§ Essay
LangChain 开发 —— RAG 与 Agent 基础
讲解 RAG、Agent 基础概念,以及 LangChain 开发实战教程:本地 ollama 模型部署与云端大模型调用、OpenAI 库的基础使用、提示词工程、LangChain(各类 API、提示词模版、Chain 链、会话记忆、文档加载器、向量存储)与 Agent 智能体
随着大模型技术快速普及,单纯调用大模型接口已经很难满足企业实际业务诉求。企业需要大模型能够读取内部私有文档、输出业务精准答案,还可以自主拆解并执行复杂业务任务。 RAG 与 Agent 就是解决上述痛点的两大核心方案:RAG 解决知识来源与回答准确性问题,Agent 解决复杂任务自动化执行问题。而 LangChain 作为主流开发框架,把这两套能力封装成可落地的工程组件,是大模型应用开发的必备工具。
相关源码可前往GitHub地址下载:LangChain 教程:RAG 与 Agent 开发实战
一、RAG 与 Agent
1、大模型的优缺点
优点
- 强大自然语言理解能力:可以读懂人类自然语言,理解复杂语义、上下文,支持各类非结构化文本输入
- 优秀生成与归纳能力:擅长总结、改写、扩写、文案创作,能够输出通顺、符合人类表达习惯的内容
- 具备基础推理能力:可以完成简单逻辑推导、问题分析,处理通用场景下的问答任务
- 通用性强:不需要针对每一个场景从零训练模型,通过提示词就可以适配多种不同业务场景
缺点
- 知识存在时间截止:无法获取训练之后产生的最新文档、行业动态
- 存在幻觉问题:直接提问容易出错,编造不存在的事实、数据
- 不掌握企业私有数据:原生大模型无法知晓内部业务信息
- 只能完成单次问答:面对多步骤复杂任务,无法自动拆解、分步执行
2、企业核心需求(技术人员拿高薪的核心抓手)
- 怎么能输出精准结果?
- 怎么能对接企业内部数据?
- 怎么能完成复杂任务?
3、RAG 的优势
- RAG 全称检索增强生成(Retrieval‑Augmented Generation),核心思路是先检索私有资料,再交给大模型来回答
- 企业私域数据和大模型结合
- 让大模型读得懂专属数据、输出结果准确贴合
4、Agent 的优势
- 企业的需求不是单次提问、回答,而是需要大模型像虚拟员工一样,自动拆解复杂的任务、一步步执行
- 比如自动整理会议纪要、完成市场调研、处理咨询流程等,这也是大模型从工具升级为生产力的关键
5、用什么框架开发?
LangChain:目前工业界最主流的开发框架是 LangChain,它封装了文档加载、文本切分、向量存储、检索、工具调用、Agent 规划等全套组件,开发者不用从零实现底层逻辑,可以快速搭建 RAG 知识库和 Agent 智能体应用
二、前置准备-大模型的接入
1、云端大模型
以阿里云百炼平台为例:
实名认证
进入主页后登陆、实名认证
创建 API key
点击模型 —> API key,创建 API key,记得复制 API key
点击模型用量可以查看剩余额度,阿里云百炼平台会赠送额外额度,如果不想额外计费,记得打开“免费额度用完即停”
安装 OpenAI 库
在编写代码前我们还需要安装 OpenAI 库:
pip install openai通过代码调用云端大模型:回到阿里云百炼平台,点击模型广场,任意选择一款模型
测试代码
以 Qwen3.8-Max 为例,点击该模型,查看 API 代码示例,复制代码到 PyCharm:
from openai import OpenAI
import os

client = OpenAI(
    # 如果没有配置环境变量,请用阿里云百炼API Key替换:api_key="sk-xxx"
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)

messages = [{"role": "user", "content": "你是谁"}]
completion = client.chat.completions.create(
    model="qwen3.8-max",  # 您可以按需更换为其它深度思考模型
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
is_answering = False  # 是否进入回复阶段
print("\n" + "=" * 20 + "思考过程" + "=" * 20)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if hasattr(delta, "reasoning_content") and delta.reasoning_content is not None:
        if not is_answering:
            print(delta.reasoning_content, end="", flush=True)
    if hasattr(delta, "content") and delta.content:
        if not is_answering:
            print("\n" + "=" * 20 + "完整回复" + "=" * 20)
            is_answering = True
        print(delta.content, end="", flush=True)
将 api_key=os.getenv("DASHSCOPE_API_KEY") 中的 DASHSCOPE_API_KEY 替换为刚才复制的 API-Key,运行测试的代码即可
除了官网给出的示例代码,我们还可以用以下精简的代码测试:
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "你是谁,能做什么?"},
    ],
    stream=True
)
for chunk in completion:
    print(chunk.choices[0].delta.content, end="", flush=True)
2、使用环境变量保护 API- Key
在上述代码中,将 API-Key 明文直接写在代码中有很大的隐患。我们可以通过环境变量隐藏 API-Key
需要配置两个 API-Key:
OPENAI_API_KEY:用于 openai 库,记录 API-KeyDASHSCOPE_API_KEY:用于 langchain ,后续会用到
Windows 配置环境变量方法
点击 win + s 打开搜索框,搜索“高级系统设置”,点击进入,
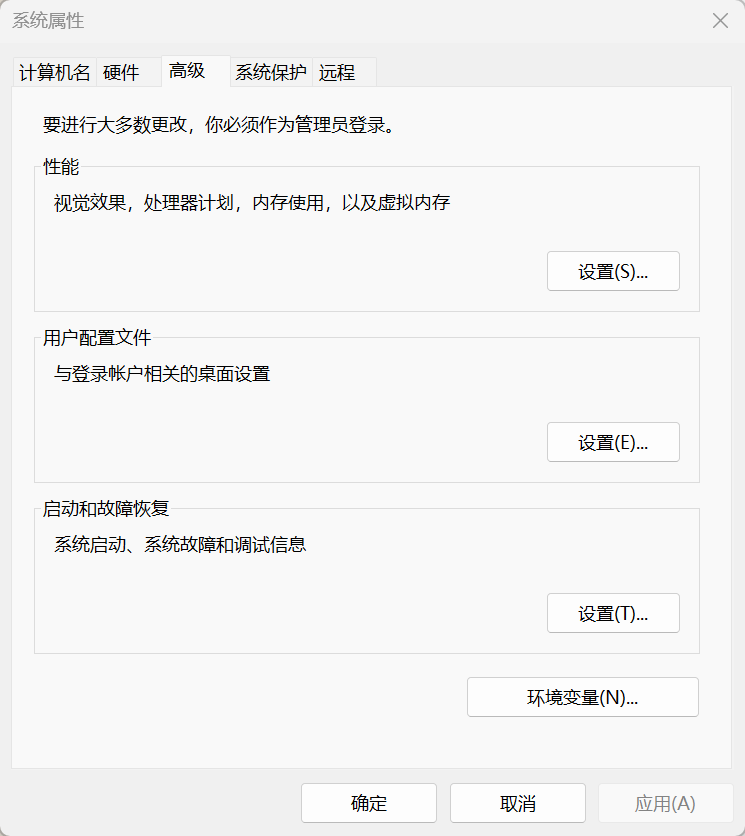
点击“环境变量”,在“用户变量”中点击“新建”,分别添加以下环境变量:
| 变量名(N) | 变量值(Y) |
|---|---|
| OPENAI_API_KEY | (复制的API-Key) |
| DASHSCOPE_API_KEY | (同上) |
重启电脑,将代码中的 api_key=os.getenv("DASHSCOPE_API_KEY") 删除,运行测试代码:
from openai import OpenAI

client = OpenAI(
    base_url="https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1",
)
completion = client.chat.completions.create(
    model="qwen3.8-max",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "你是谁,能做什么?"},
    ],
    stream=True
)
for chunk in completion:
    print(chunk.choices[0].delta.content, end="", flush=True)
Mac 配置环境变量方法
open .zshrc回车进入,不要修改原有内容,在空白处输入:
export OPENAI_API_KEY="......"
export DASHSCOPE_API_KEY="......"
点击文件 —> 存储
重启电脑
运行测试代码
3、本地部署大模型
Ollama 简介
- ollama:是一款旨在简化大型语言模型本地部署和运行过程的开源软件
- ollama 提供了一个轻量级、易于扩展的框架,让开发者能够在本地机器上轻松构建和管理 LLMs (大型语言模型)
- 通过 ollama,开发者可以导入和定制自己的模型,无需关注复杂的底层实现细节
- ollama 网址:https://ollama.com
- 简单来说,ollama 可以在本地电脑上部署和运行大模型,由自己电脑的硬件提供算力支撑模型运行
- ollama 支持多种开源模型,涵盖文本生成、代码生成、多模态推理等场景。用户可以根据需求选择合适的模型,并通过简单的命令行操作在本地运行
- ollama 官方模型库:https://ollama.com/library
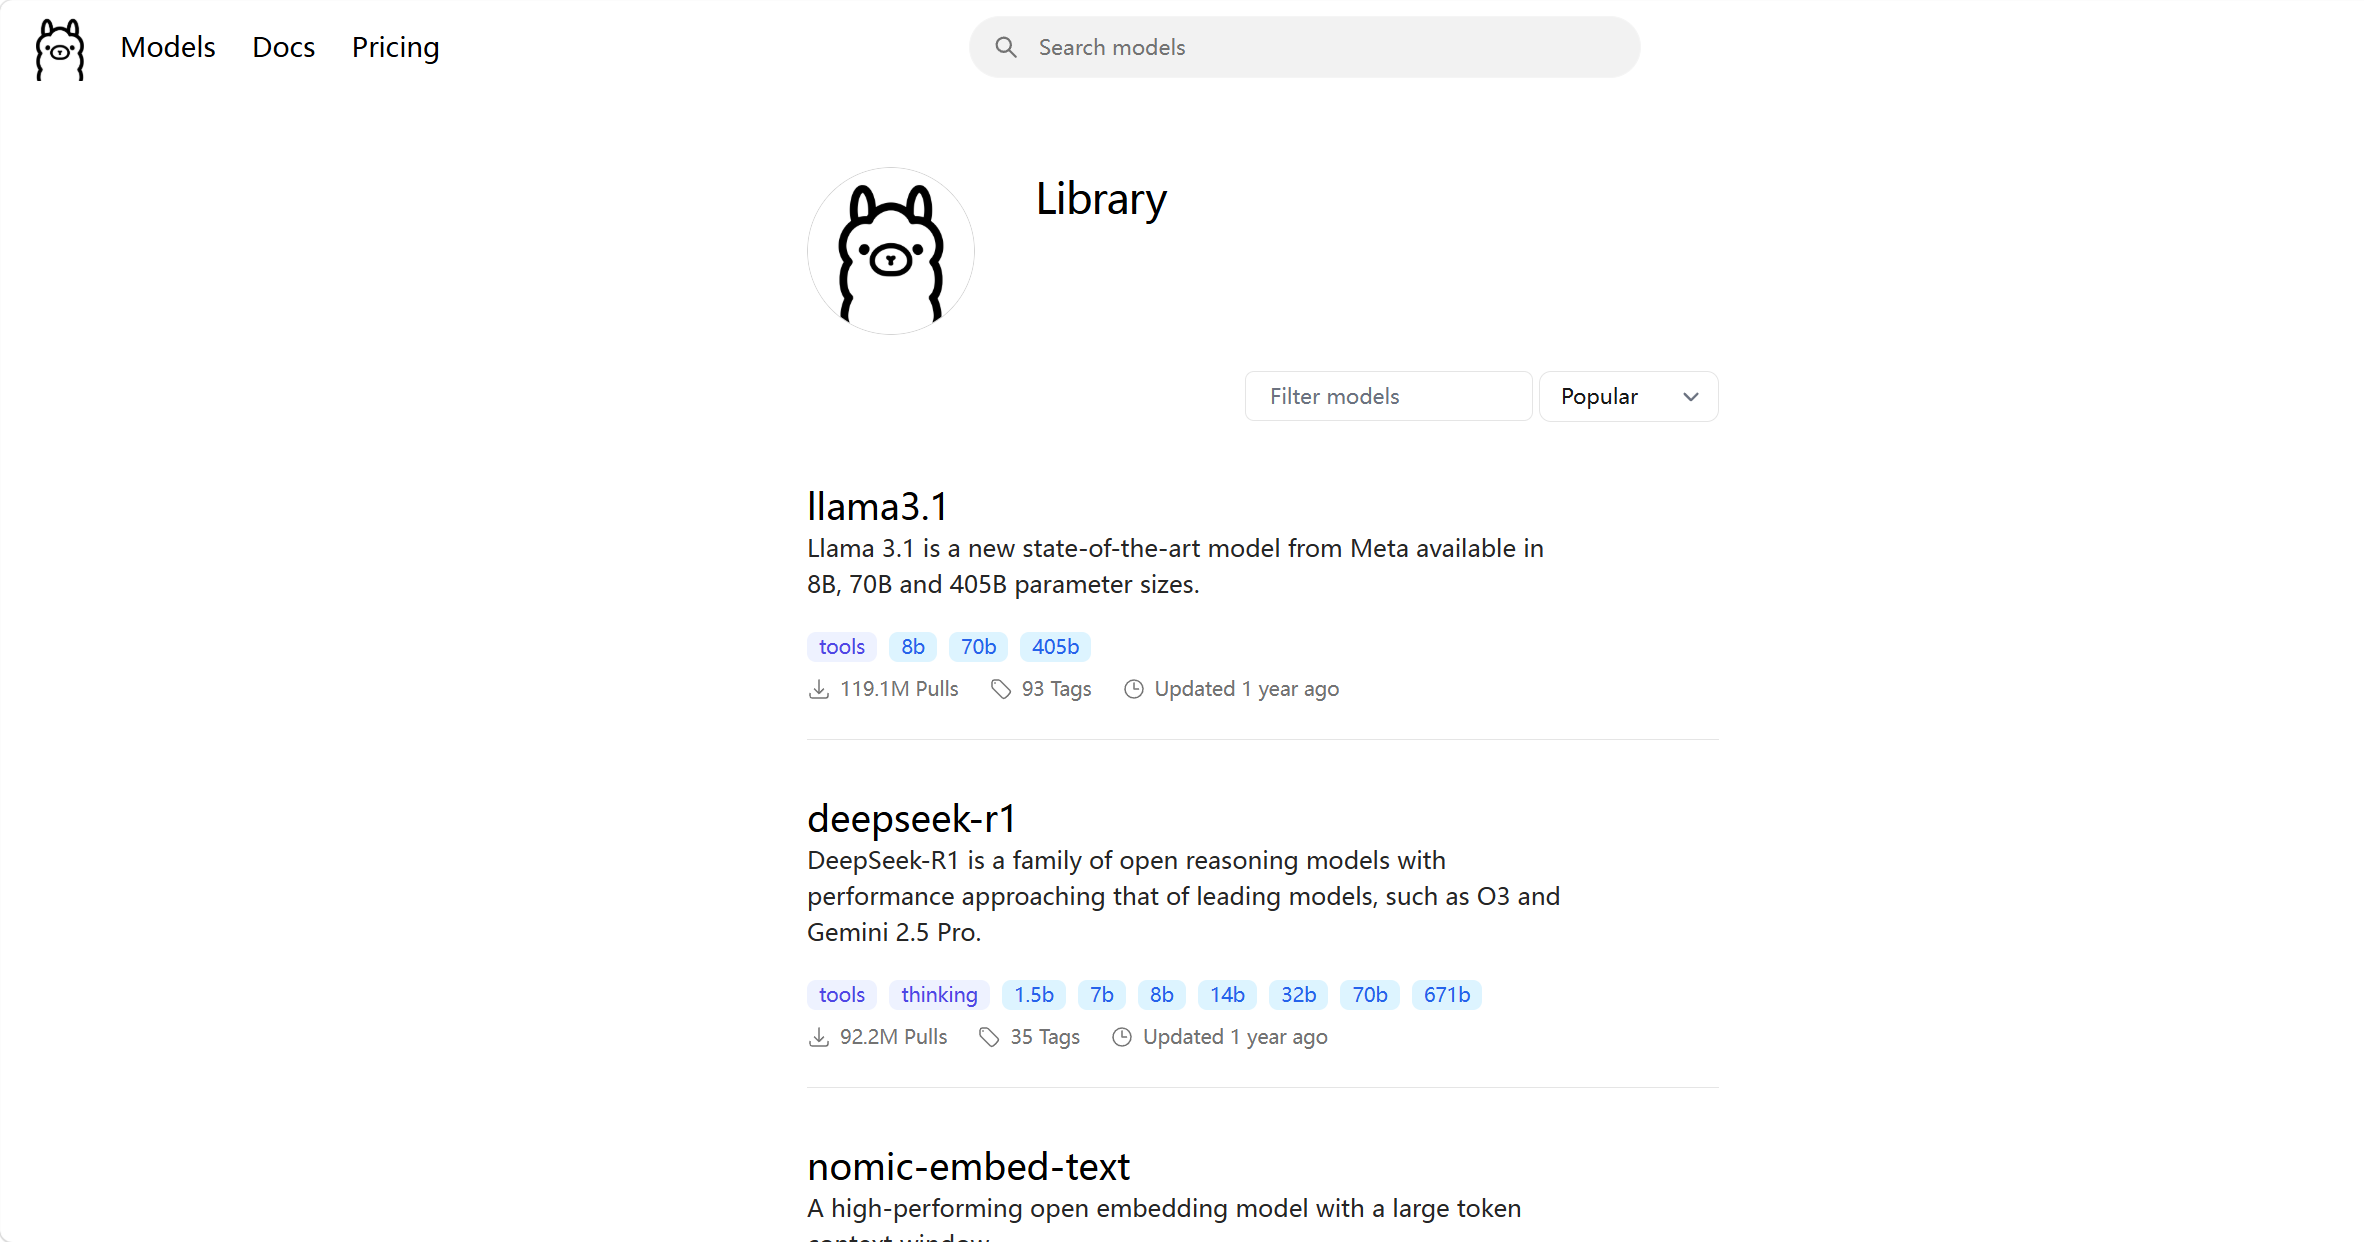
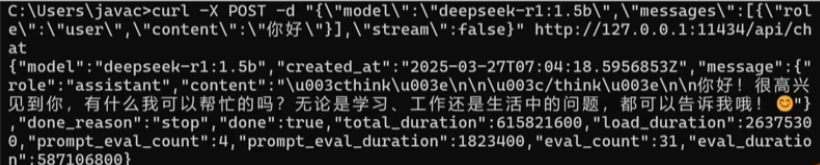
Ollama 的调用
命令行访问
ollama run deepseek-r1:1.5bRestful API 接口访问
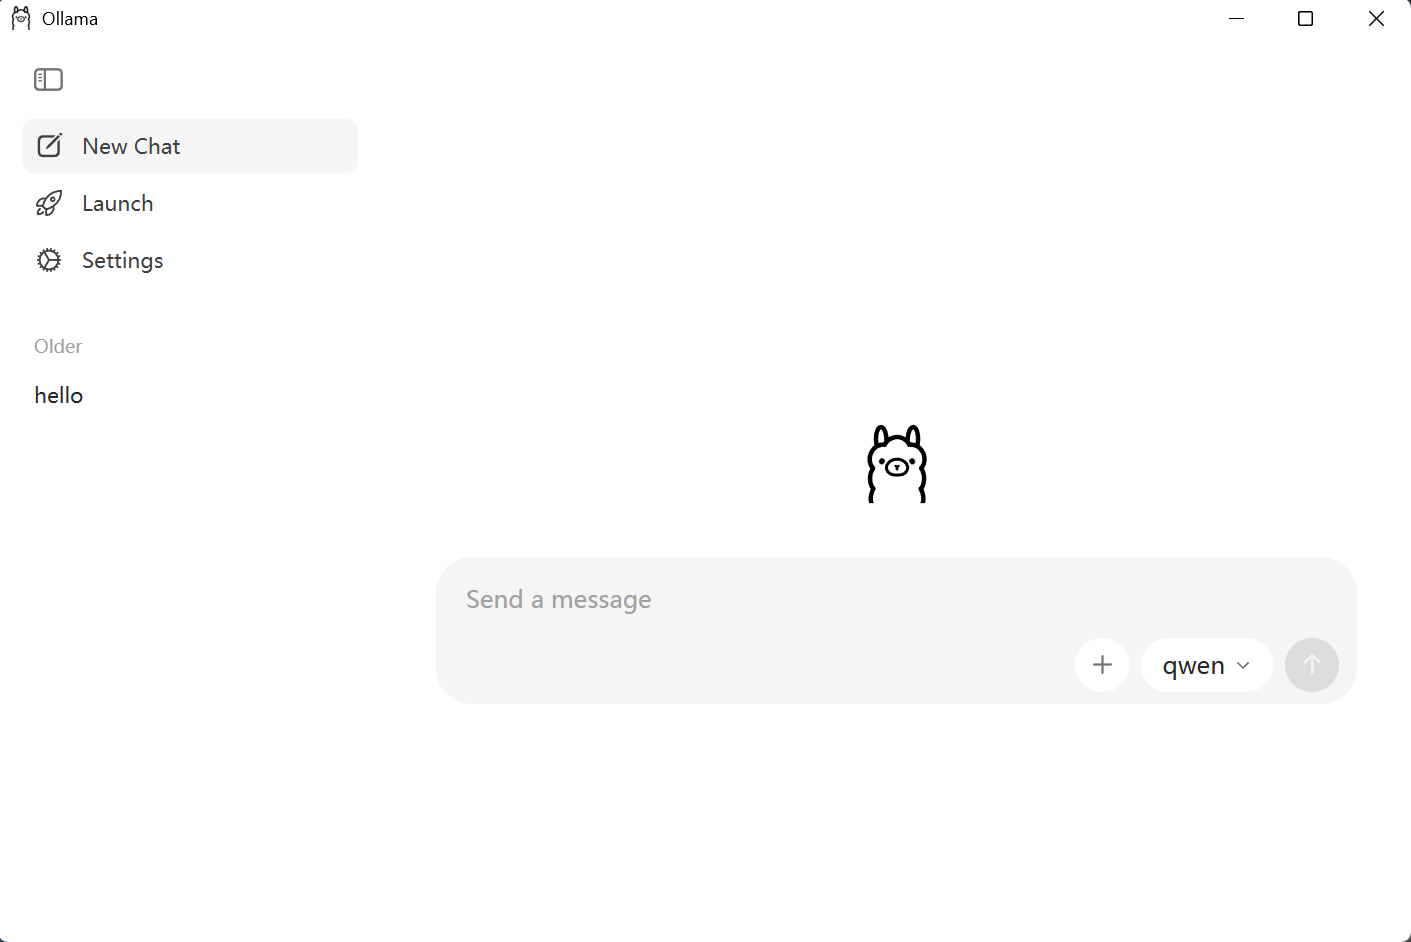
Ollama 的部署
进入官网点击 Download 下载安装
打开 ollama,右下角可以选择模型,第一次对话时会下载选定的模型
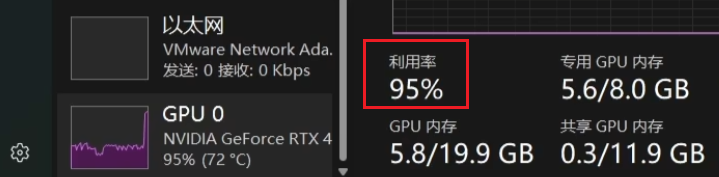
可以看到很多模型后面带有“:…b”,这是因为 ollama 中运行的模型都是蒸馏模型,并不是完整版的模型,“…b”就是参数量,可以根据自己电脑的配置选择参数量合适的模型
模型运行时会消耗自己电脑的硬件能力
代码调用 Ollama 本地模型
只需在调用云端大模型的测试代码中改动 base_url 和 model 即可:
base_url:改为 http://lacalhost:11434/v1model:改为本地下载的模型名称,如 qwen3:4b
from openai import OpenAI

client = OpenAI(、
    base_url="http://lacalhost:11434/v1",
)
completion = client.chat.completions.create(
    model="qwen3:4b",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "你是谁,能做什么?"},
    ],
    stream=True
)
for chunk in completion:
    print(chunk.choices[0].delta.content, end="", flush=True)
三、OpenAI 库的基础使用
OpenAI 库是 OpenAI 官方推出的 python SDK,核心作用是让开发者能简单、高效地调用 OpenAI 的各类 API(如 GPT 聊天、DALL · E 绘图、语音转文字等),无需手动处理 HTTP 请求、身份验证等底层细节
由于其发布较早且比较易用,现如今许多模型服务商(如阿里云百炼平台)均兼容 OpenAI SDK 的调用
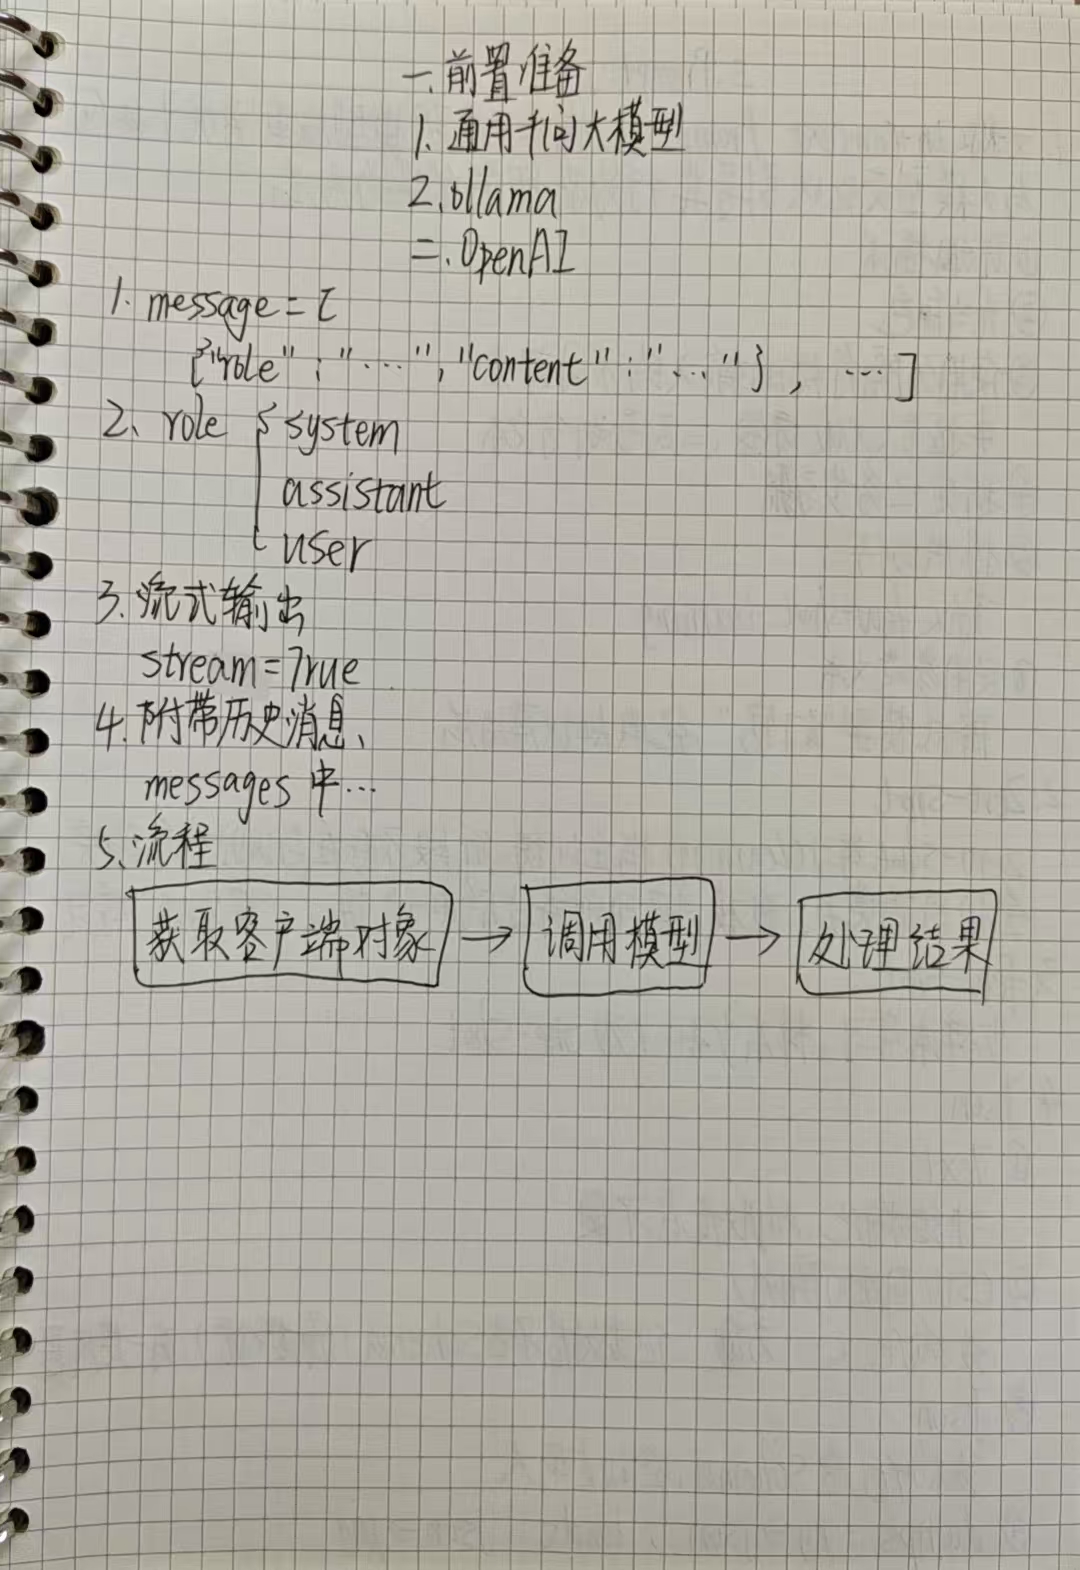
OpenAI 库的使用流程
- 获取客户端对象
- 调用模型
- 处理结果
获取客户端对象
from openai import OpenAI

client:OpenAI = OpenAI(
	api_key = "......"
    base_url = "......"
)
调用模型
from openai.types.chat.chat_completion import ChatCompletion

response:ChatCompletion = client.chat.completions.create(
	model = "qwen3-max"
    messages = [
        {"role": "system", "content": "你是一个 python 编程专家。"},
        {"role": "assistant", "content": "我是一个 python 编程专家。请问有什么可以帮助您的吗?"},
        {"role": "user", "content": "for 循环输出 1 到 5 的数字。"}
    ]
)
client.chat.completions.create 创建 ChatCompletion 对象,主要参数有 2 个:
model:选用模型messages:提供给模型的消息,类型为 list,可以包含多个字典消息,每个字典消息包含 2 个 key ,role 为角色,content 为内容
role 角色:
- system:设定助手的整体行为、角色和规则,为对话提供上下文框架(如指定助手身份、回答风格、核心要求),是全局的背景设定,影响后续所有交互
- assistant:代表 AI 助手的回答,可以在代码中人为设定
- user:代表用户,发送问题、指令或需求
处理结果
模型的回复为 response 变量,是一个 ChatCompletion 对象,其为类 json 格式,包含的信息如下:
{
"id": "chatcmpl-xxxx",
"object": ,
"created": 17......,
"model": "gpt-3.5-turbo-0125",
"choices": [
    {
        "index": 0,
        "message": {
            "role": "assistant",
            "content": "生成的回复内容"
        },
        "finish_reason": "stop"  # stop=正常,length=令牌数超额,function_call=触发函数调用
    }
],
"usage": {
    "prompt_tokens": 50,
    "completion_tokens":80,
    "total_tokens": 130
}
}
可以通过如下输出模型给出的回答信息:
print(response.choices[0].message.content)完整代码
from openai import OpenAI

# 1,获取 client 对象,OpenAI 类对象
client = OpenAI(
	# 设置了环境变量,这里不用再写 api_key
    base_url = "https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 2,调用模型
response = client.chat.completions.create(
	model = "qwen3-max",
    messages = [
        {"role": "system", "content": "你是一个 python 编程专家。"},
        {"role": "assistant", "content": "我是一个 python 编程专家。请问有什么可以帮助您的吗?"},
        {"role": "user", "content": "for 循环输出 1 到 5 的数字。"}
    ]
)

# 3,处理结果
print(response.choices[0].message.content)
流式输出
可以设定结果输出为 stream 模式(流式输出),获得更好的使用体验
开启流式输出步骤:
- 在
client.chat.completions.create()调用模型时设定参数:stream = True - for 循环 response 对象,并在循环内输出内容
from openai import OpenAI

# 1,获取 client 对象,OpenAI 类对象
client = OpenAI(
	# 设置了环境变量,这里不用再写 api_key
    base_url = "https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

# 2,调用模型
response = client.chat.completions.create(
	model = "qwen3-max",
    messages = [
        {"role": "system", "content": "你是一个 python 编程专家。"},
        {"role": "assistant", "content": "我是一个 python 编程专家。请问有什么可以帮助您的吗?"},
        {"role": "user", "content": "for 循环输出 1 到 5 的数字。"}
    ],
    stream = True   # 开启流式输出
)

# 3,处理结果
# print(response.choices[0].message.content)
for chunk in response:
    if chunk.choices[0].delta.content:
        print(
            chunk.choices[0].delta.content,
            end="",     # 不要以回车符结尾
            flush=True   # 立刻刷新缓冲区
        )
附带历史消息
调用模型传入的参数 messages,其要求是 list 对象,即表明其支持非常多的消息在内
基于此,将历史消息填入,让模型知晓对话的上下文,更好的回答
from openai import OpenAI

client = OpenAI(
    base_url = "https://ws-mz1exca911jor8vw.cn-beijing.maas.aliyuncs.com/compatible-mode/v1"
)

response = client.chat.completions.create(
	model = "qwen3-max",
    messages = [
        {"role": "system", "content": "你是 AI 助理,回答很简洁"},
        {"role": "user", "content": "小明有 2 条宠物狗"},
        {"role": "assistant", "content": "好的"},
        {"role": "user", "content": "小红有 3 只宠物猫"},
        {"role": "assistant", "content": "好的"},
        {"role": "user", "content": "总共有几个宠物?"}
    ],
    stream = True
)

for chunk in response:
    if chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
当前的历史消息是一次性的,如果是生产系统可以将消息保存到文件、数据库等持久化工具内,需要的时候提取使用
四、提示词工程
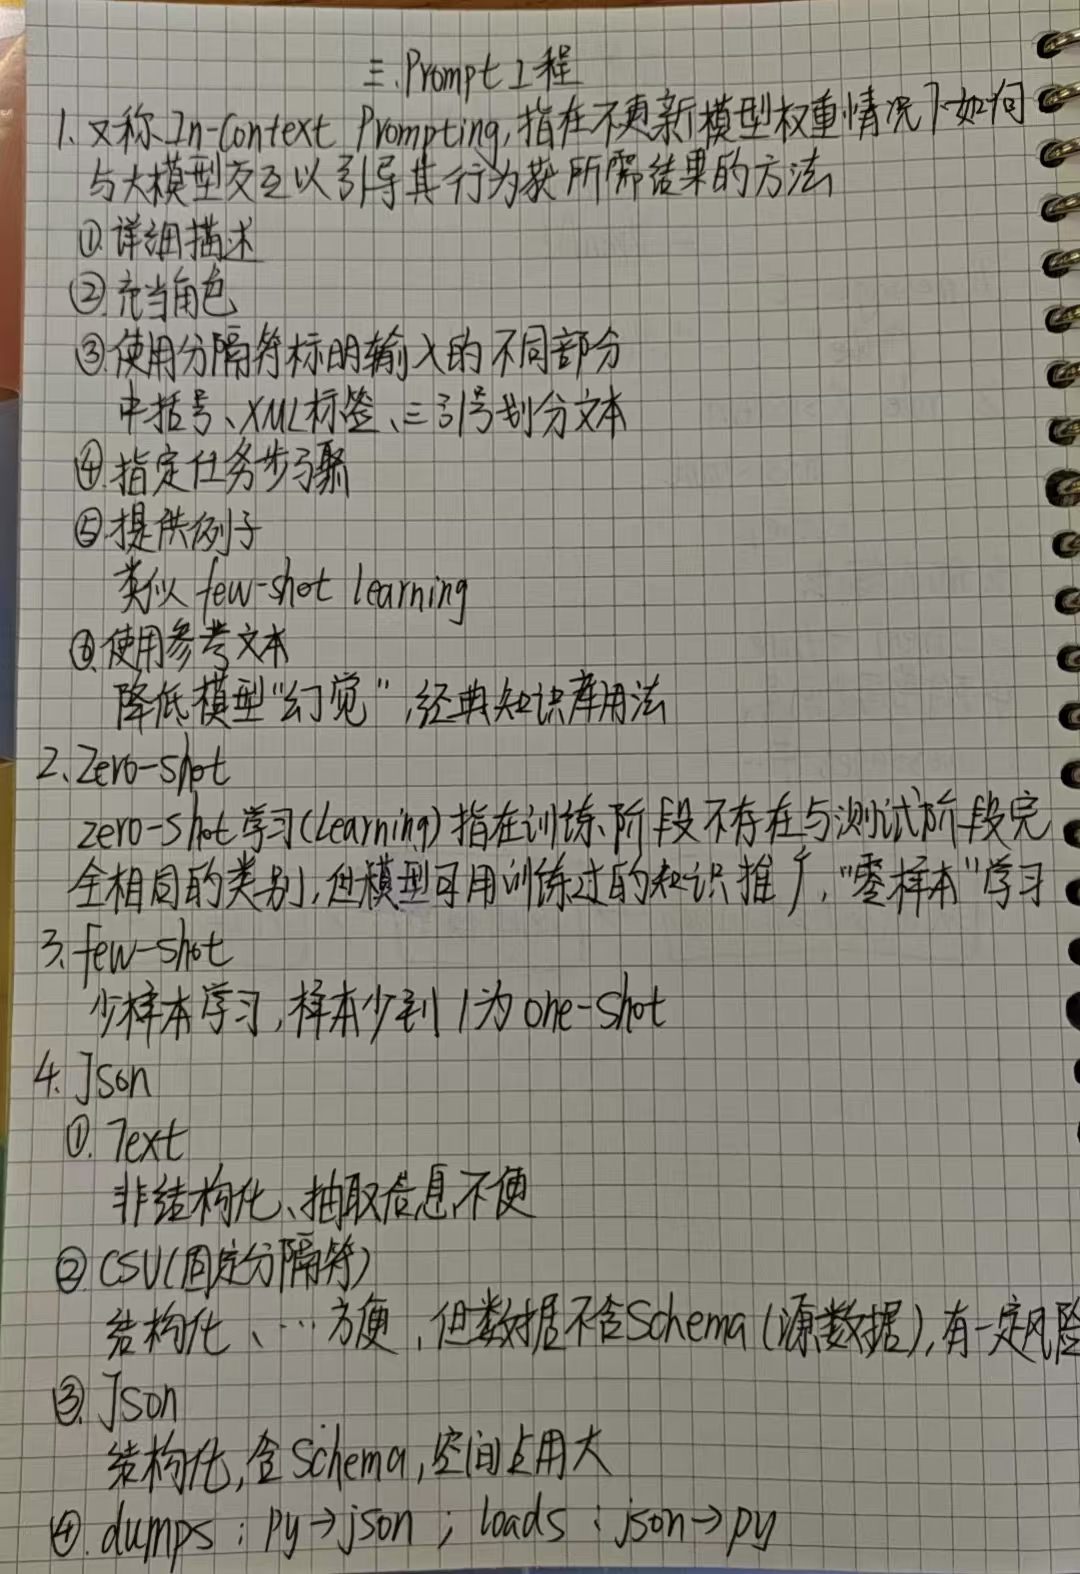
提示工程(Prompt Engineering),也称为 In-Context Prompting,是指在不更新模型权重的情况下如何与大模型交互以引导其行为以获得所需结果的方法
- 提示工程 —— 提问的工程
- 在人工智能领域,Prompt 指的是用户给大型语言模型发出的指令
- 虽然看似简单,但实际上,Prompt 的设计对于模型的结果影响很大
- 因此如何设计 Prompt ,进而与模型更好的交互,是研究人员那必备的必不可少的技能(提示工程)
提示词技巧
任何 Prompt 技巧,都不如清晰的表达你的需求。类似人与人沟通,如果话说不明白,不可能让别人理解你的思想。因此,写出清晰的指令是核心
- 技巧 1:详细的描述
- 技巧 2:让模型充当某个角色
- 技巧 3:使用分隔符标明输入的不同部分,如用中括号、XML标签、三引号等分隔符可以帮助划分要区别对待的文本,也可以帮助模型更好的理解文本内容。常用''' '''把内容框起来
- 技巧 4:对任务指定步骤
- 技巧 5:提供例子
- 技巧 6:使用参考文本,基于文本文档辅助大模型回答,降低模型幻觉问题,是经典的知识库用法,让大模型使用我们提供的信息来组成答案
用更详细、更清晰、有逻辑、有参考的提问,获得期望中的回答效果。不管是 RAG 还是 Agent 智能体亦或是其他围绕模型的各类复杂的开发工作,本质上都可以简单总结为在提示词上下功夫
提示词优化是所有大模型应用开发的基础必修课,一个好的提示词,甚至能让基础模型的输出效果媲美经过简单微调的模型
提示词优化思想
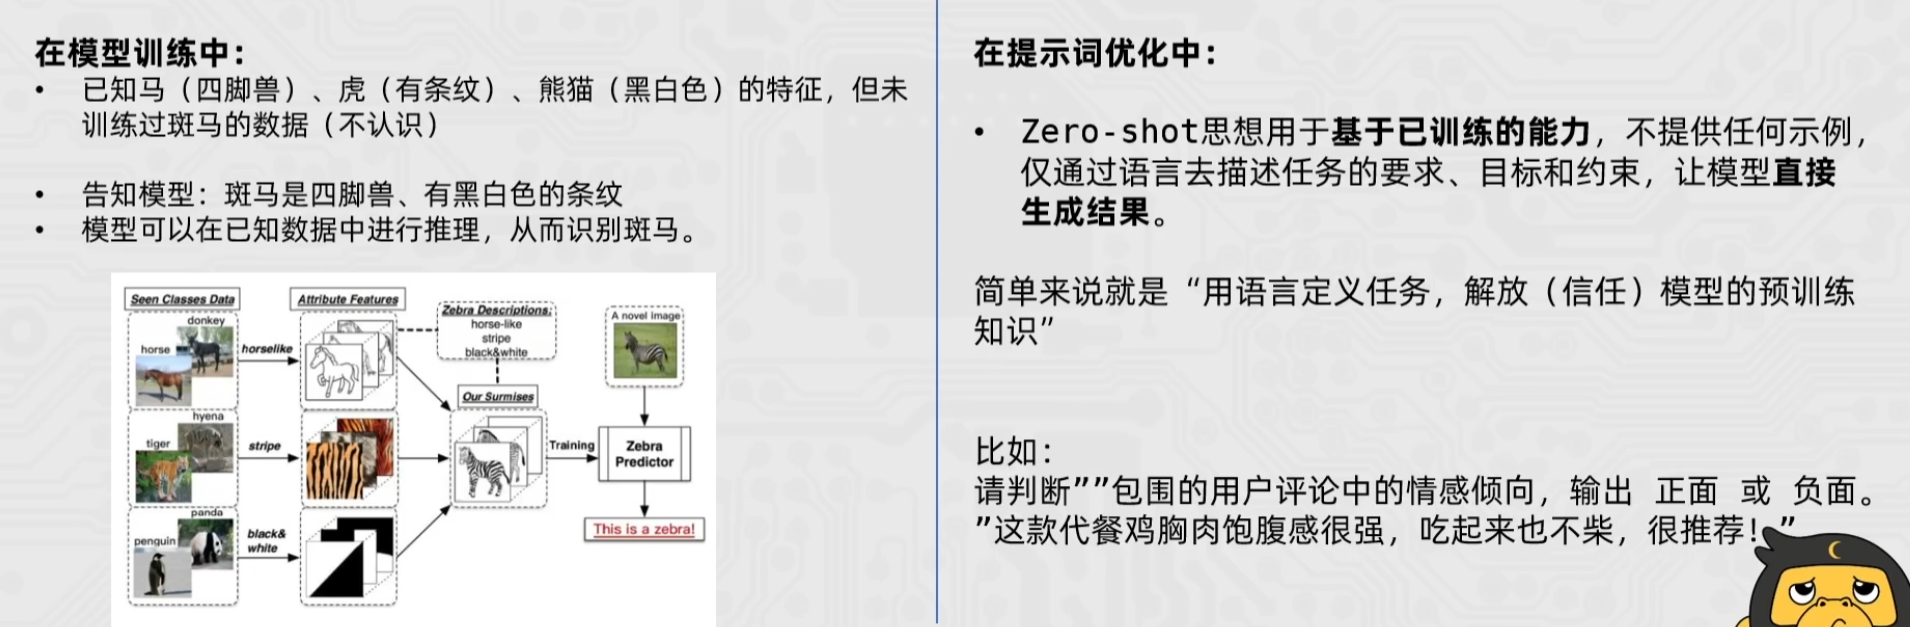
Zero-shot 思想
Zero-shot 学习(Zero-shot Learning)是指在训练阶段不存在与测试阶段完全相同的类别,但是模型可以使用训练过的知识来推广到测试集中的新类别上
这种能力被称为“零样本”学习,因为模型在训练时从未见过测试集中的新类别,在模型训练和提示词优化中均有体现
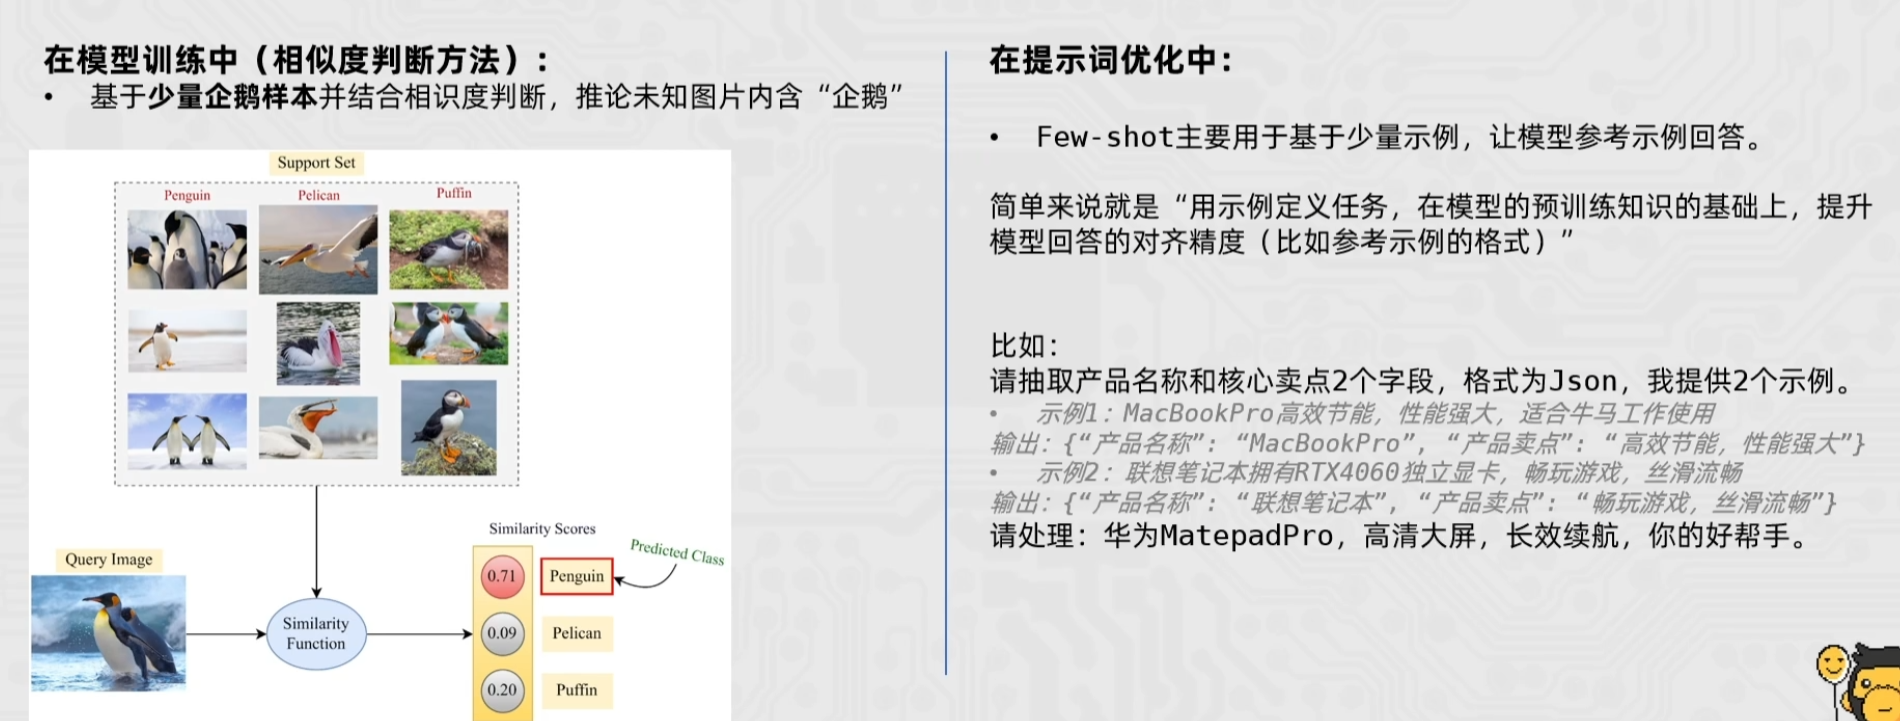
Few-shot 思想
Few-shot 学习(Few-shot Learning)是指少样本学习,当模型在学习了一定类别的大量数据后,对于新的类别,只需要少量的样本就能快速学习,对应的有 one-shot learning,单样本学习,也算样本少到为一的情况下的一种 few-shot learning
实战运用 —— 文本分类任务
from openai import OpenAI

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

# 示例数据
examples_data = {
    '新闻报道': '今日,股市经历了一轮震荡,受到宏观经济数据和全球贸易紧张局势的影响。投资者密切关注美联储可能的政策调整,以适应市场的不确定性。',
    '财务报告': '本公司年度财务报告显示,去年公司实现了稳步增长的盈利,同时资产负债表呈现强劲的状况。经济环境的稳定和管理层的有效战略执行为公司的健康发展奠定了基础。',
    '公司公告': '本公司高兴地宣布成功完成最新一轮并购交易,收购了一家在人工智能领域领先的公司。这一战略举措将有助于扩大我们的业务领域,提高市场竞争力',
    '分析师报告': '最新的行业分析报告指出,科技公司的创新将成为未来增长的主要推动力。云计算、人工智能和数字化转型被认为是引领行业发展的关键因素,投资者应关注这些趋势'
}

# 分类列表
examples_types = ['新闻报道', '财务报道', '公司公告', '分析师报告']

# 提问数据
questions = [
    "今日,央行发布公告宣布降低利率,以刺激经济增长。这一降息举措将影响贷款利率,并在未来几个季度内对金融市场产生影响。",
    "ABC公司今日发布公告称,已成功完成对XYZ公司股权的收购交易。本次交易是ABC公司在扩大业务范围、加强市场竞争力方面的重要举措。据悉,此次收购将进一步巩固ABC公司在行业中的地位,并为未来业务发展提供更广阔的发展空间。详情请见公司官方网站公告栏",
    "公司资产负债表显示,公司偿债能力强劲,现金流充足,为未来投资和扩张提供了坚实的财务基础。",
    "最新的分析报告指出,可再生能源行业预计将在未来几年经历持续增长,投资者应该关注这一领域的投资机会",
    "小明喜欢小新哟"
]

messages = [
    {"role": "system", "content": "你是金融专家,将文本分类为['新闻报道', '财务报道', '公司公告', '分析师报告'],不清楚的分类为'不清楚类别' 下面有示例:"},
]

for key, value in examples_data.items():
    messages.append({"role": "user", "content": value})
    messages.append({"role": "assistant", "content": key})

# 向模型提问
for q in questions:
    response = client.chat.completions.create(
        model="qwen3-max",
        messages=messages + [{"role": "user", "content": f"按照示例,回答这段文本的分类类别:{q}"}]
    )s

    print(response.choices[0].message.content)
Json 数据格式
Json (JavaScript Object Notation)是一种轻量级的数据交换格式,易于人阅读和编写,同时易于机器解析和生成。Json 是带有格式的字符串,主要用于数据交换,即程序和程序之间的信息交互,使用 Json 会更加方便
- Text 文本:非结构化,抽取信息不方便
- CSV(固定分隔符)文本:结构化,抽取信息方便,但是数据不含 Schema,有一定风险(不知道某些数据的含义)
- Json 文本:含 Schema,但空间占用大(空间换安全)
Json 的两种结构
- Json 对象:与 python 中的字典没区别
- Json 数组:列表套字典
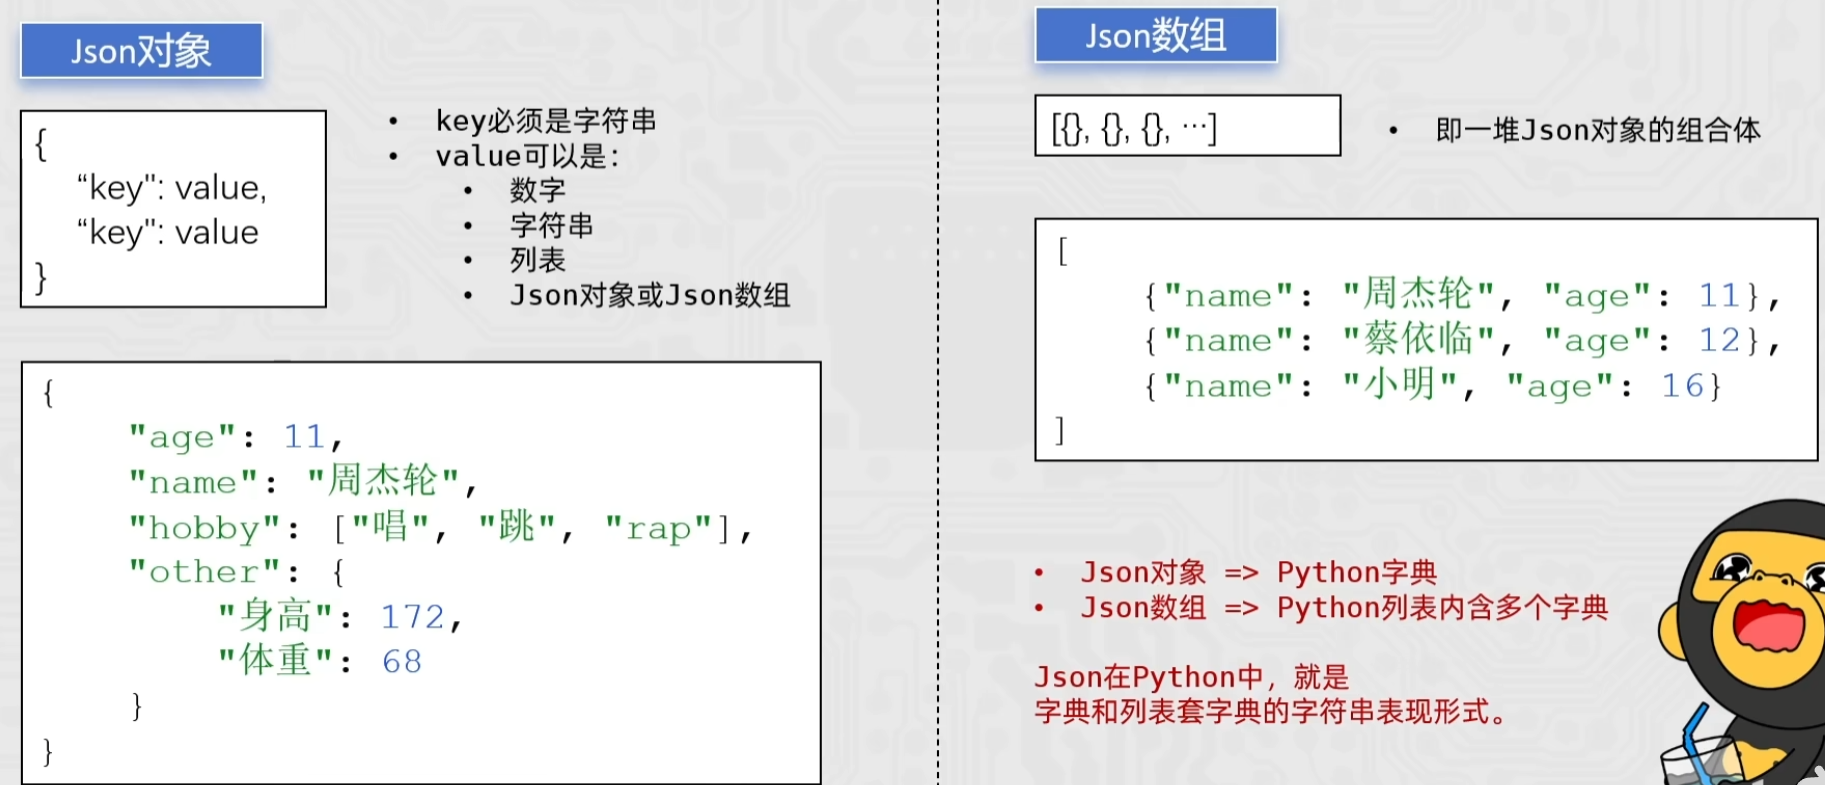
Json 在 python 中就是字典与列表套字典的字符串表现形式
Python 中使用 Json
python 中使用 Json 主要完成:
- 将 python 字典、列表转换成 Json 字符串
- 读取 Json 字符串,转换成 python 字典或列表
主要使用 python 内置的 Json 库:
- json.dumps(字典或列表,ensure_ascill=False):将字典或列表转换成 Json 字符串(ensure_ascill=False 确保中文能正常显示,返回值:Json 字符串)
- json.loads(json 字符串):将 Json 字符串转换为 python 字典或列表(返回值:python 字典或python 列表)
案例
python —> json
import json

d = {
    "name": "周杰轮",
    "age": 11,
    "gender": "男"
}

s = json.dumps(d, ensure_ascii=False)
print(s)

# {"name": "周杰轮", "age": 11, "gender": "男"}
注意:如果直接用 s = str(d) 转化的 s 为 {'name': '周杰轮', 'age': 11, 'gender': '男'},而标准的 Json 数据为了跨语言的通用性,是双引号
import json

l = [
    {
        "name": "周杰轮",
        "age": 11,
        "gender": "男"
    },
    {
        "name": "蔡依临",
        "age": 12,
        "gender": "女"
    },
    {
        "name": "小明",
        "age": 16,
        "gender": "男"
    }
]

print(json.dumps(l, ensure_ascii=False))

# [{"name": "周杰轮", "age": 11, "gender": "男"}, {"name": "蔡依临", "age": 12, "gender": "女"}, {"name": "小明", "age": 16, "gender": "男"}]
json —> python
import json

json_str = '{"name": "周杰轮", "age": 11, "gender": "男"}'

res_dict = json.loads(json_str)
print(res_dict, type(res_dict))
import json
json_array_str = '[{"name": "周杰轮", "age": 11, "gender": "男"}, {"name": "蔡依临", "age": 12, "gender": "女"}, {"name": "小明", "age": 16, "gender": "男"}]'
res_list = json.loads(json_array_str)
print(res_list, type(res_list))实战运用 1 —— 信息抽取任务
from openai import OpenAI
import json

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

schema = ['日期', '股票名称', '开盘价', '收盘价', '成交量']
examples_data = [
    {
        "content": "2023-01-10,股市震荡。股票强大科技A股今日开盘价100人民币,一度飙升至105人民币,随后回落至98人民币,最终以102人民币收盘,成交量达到520000。",
        "answers": {
            "日期": "2023-01-10",
            "股票名称": "强大科技A股",
            "开盘价": "100人民币",
            "收盘价": "102人民币",
            "成交量": "520000"
        }
    },
    {
        "content": "2024-05-16,股市利好。股票英伟达美股今日开盘价105美元,一度飙升至109美元,随后回落至100美元,最终以116美元收盘,成交量达到3560000。",
        "answers": {
            "日期": "2024-05-16",
            "股票名称": "英伟达美股",
            "开盘价": "105美元",
            "收盘价": "116美元",
            "成交量": "3560000"
        }
    }
]

questions = [
    "2025-06-16,股市利好。股票传智教育A股今日开盘价66人民币,一度飙升至70人民币,随后回落至65人民币,最终以68人民币收盘,成交量达到123000。",
    "2025-06-06,股市利好。股票黑马程序员A股今日开盘价200人民币,一度飙升至211人民币,随后回落至201人民币,最终以206人民币收盘。"
]

messages = [
    {"role": "system", "content": f"你帮我完成信息抽取,我给你句子,你抽取{schema}信息,按JSON字符串输出,如果某些信息不存在,用'原文未提及'表示,请参考如下示例:"}
]

for example in examples_data:
    messages.append(
        {"role": "user", "content": example["content"]}
    )
    messages.append(
        {"role": "assistant", "content": json.dumps(example["answers"], ensure_ascii=False)}
    )

for q in questions:
    response = client.chat.completions.create(
        model="qwen3-max",
        messages=messages + [{"role": "user", "content": f"按照上述的示例,现在抽取这个句子的信息:{q}"}]
    )

    print(response.choices[0].message.content)
实战运用 2 —— 文本匹配任务
from openai import OpenAI

client = OpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

examples_data = {
    "是": [
        ("公司ABC发布了季度财报,显示盈利增长。", "财报披露,公司ABC利润上升。"),
        ("公司ITCAST发布了年度财报,显示盈利大幅度增长。", "财报披露,公司ITCAST更赚钱了。")
    ],
    "不是": [
        ("黄金价格下跌,投资者抛售。", "外汇市场交易额创下新高。"),
        ("央行降息,刺激经济增长。", "新能源技术的创新。")
    ]
}

questions = [
    ("利率上升,影响房地产市场。", "高利率对房地产有一定的冲击。"),
    ("油价大幅度下跌,能源公司面临挑战。", "未来智能城市的建设趋势越加明显。"),
    ("股票市场今日大涨,投资者乐观。", "持续上涨的市场让投资者感到满意。")
]

messages = [
    {"role": "system", "content": f"你帮我完成文本匹配,我给你2个句子,被[]包围,你判断它们是否匹配,回答是或不是,请参考如下示例:"},
]

for key, value in examples_data.items():
    for t in value:
        messages.append(
            {"role": "user", "content": f"句子1:[{t[0]}],句子2:[{t[1]}]"}
        )
        messages.append(
            {"role": "assistant", "content": key}
        )

for q in questions:
    response = client.chat.completions.create(
        model="qwen3-max",
        messages=messages + [{"role": "user", "content": f"句子1:[{q[0]}],句子2:[{q[1]}]"}]
    )

    print(response.choices[0].message.content)
五、RAG 介绍
LangChain 简介
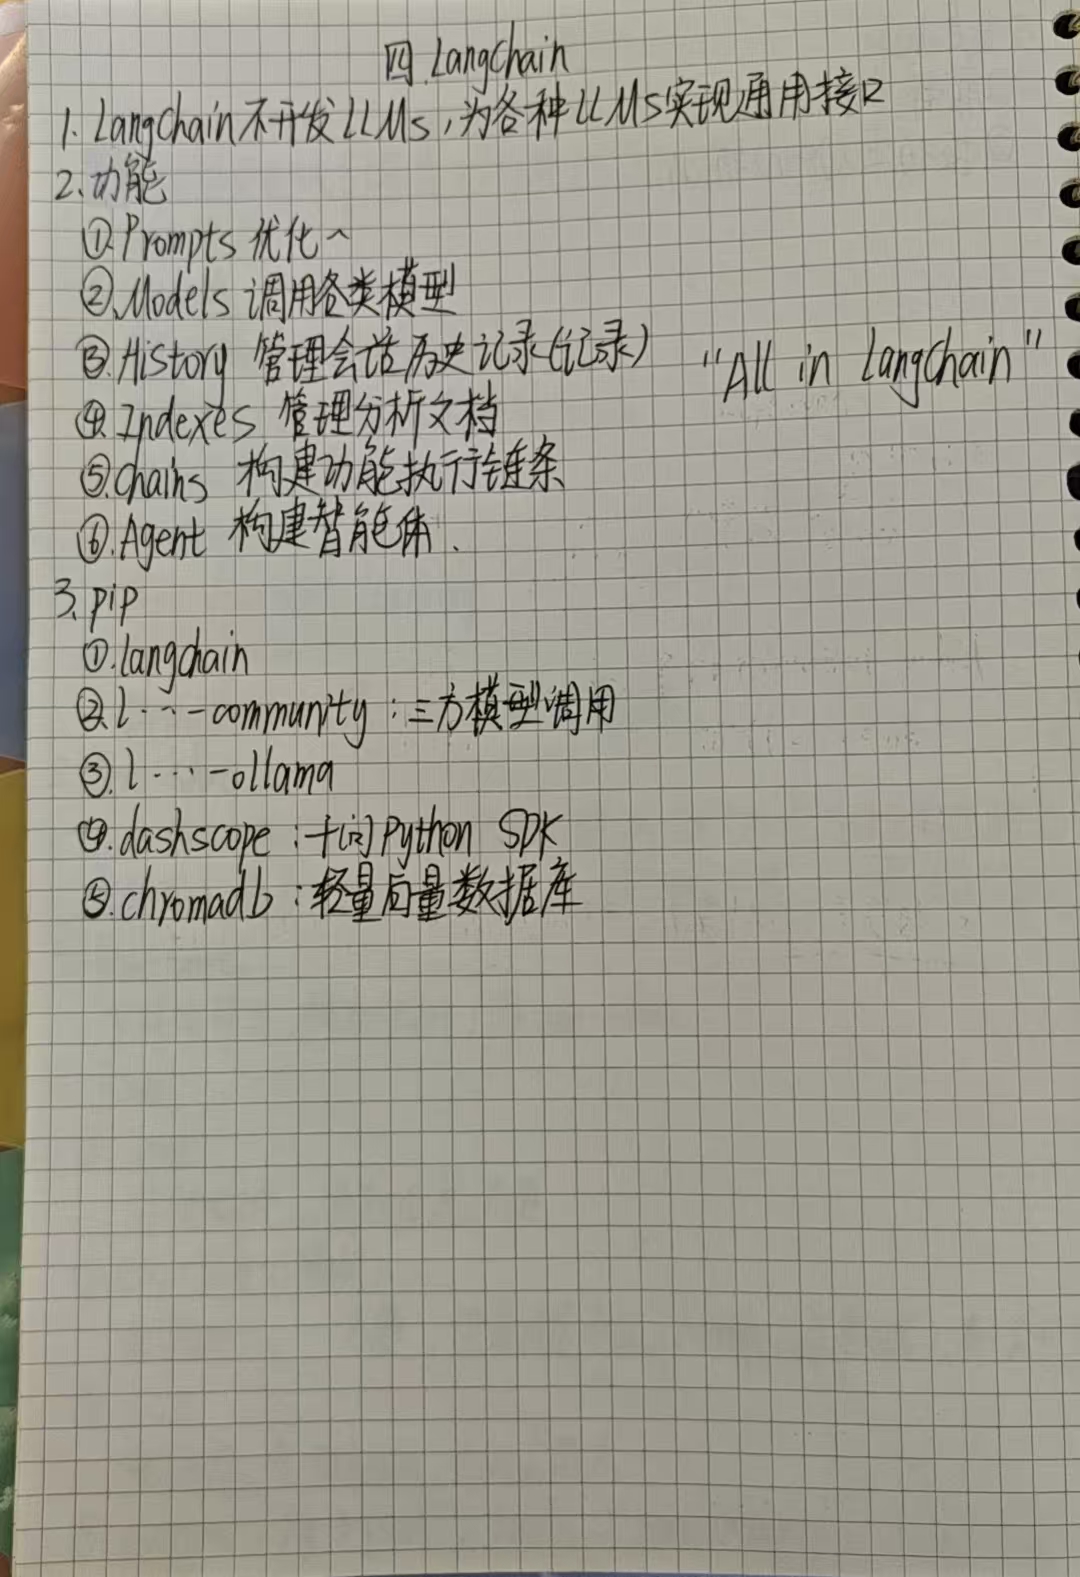
LangChain 由 Harrison Chase 创建于 2022 年 10 月,它是围绕 LLMs (大语言模型)建立的一个框架
LangChain 自身并不开发 LLMs ,它的核心理念是为各种 LLMs 实现通用的接口,把 LLMs 相关的组件“链接”在一起,简化 LLMs 应用的开发难度,方便开发者快速地开发复杂的 LLMs 应用
LangChain 是一个开发 LLM 相关业务功能的集大成者,是一个 python 的第三方库,提供各种功能的 API
LangChain 主要功能
- Prompt 优化提示词(提示词工程)
- Models 调用各种模型
- History 管理会话历史记录(记忆)
- Indexes 管理和分析各类文档
- Chins 构建功能的执行链条(核心亮点)
- Agent 构建智能体
“All in LangChain” —— 一站齐活
LangChain 环境部署
pip install langchain langchain-community langchain-ollama dashscope chromadb- langchain:核心包
- langchain-community:社区支持包,提供了更多的第三方模型调用
- langchain-ollama:ollama 支持包,支持调用 ollama 托管部署的本地模型
- dashscope:阿里云通义千问的 python SDK
- chromadb:轻量向量数据库
RAG 介绍
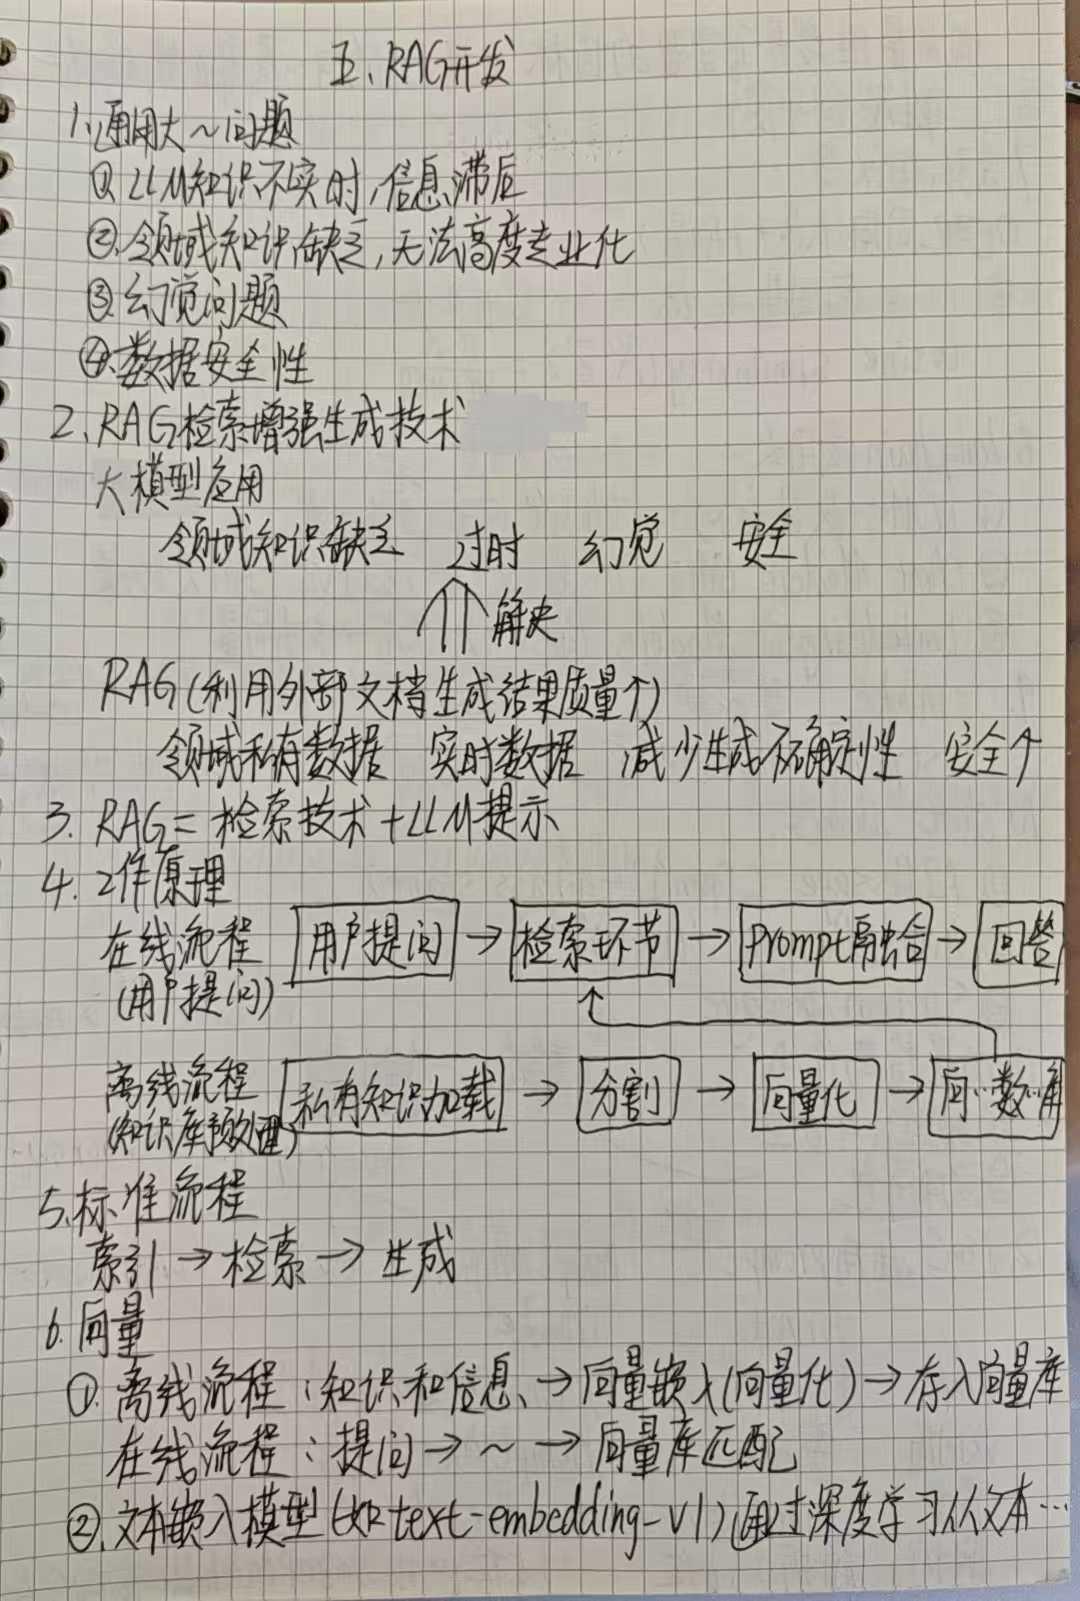
通用的基础大模型存在一些问题:
- LLM 的知识不是实时的,模型训练好后不具备自动更新知识的能力,会导致部分信息滞后
- LLM 领域知识是缺乏的,大模型的知识来源于训练数据,这些数据主要来自公开的互联网和开源数据集,无法覆盖特定领域或高度专业化的内部数据
- 幻觉问题,LLM 有时会在回答中生成看似合理但实际上是错误的信息
- 数据安全性
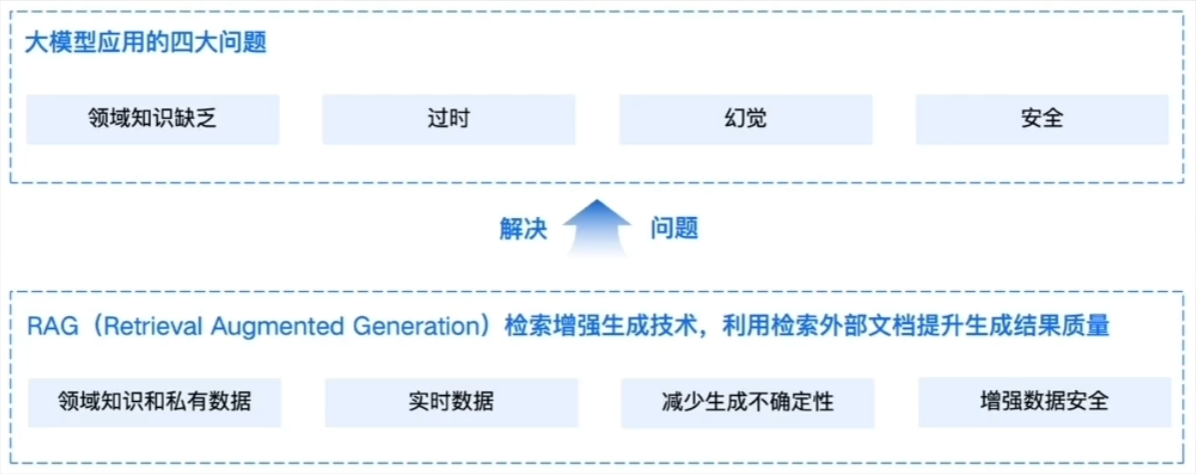
RAG(Retrieval‑Augmented Generation),即检索增强生成,为大模型提供了从特定数据源检索到的信息,以此来修正和补充生成的答案。可以总结为一个公式:
RAG 的工作原理
工作流程图解
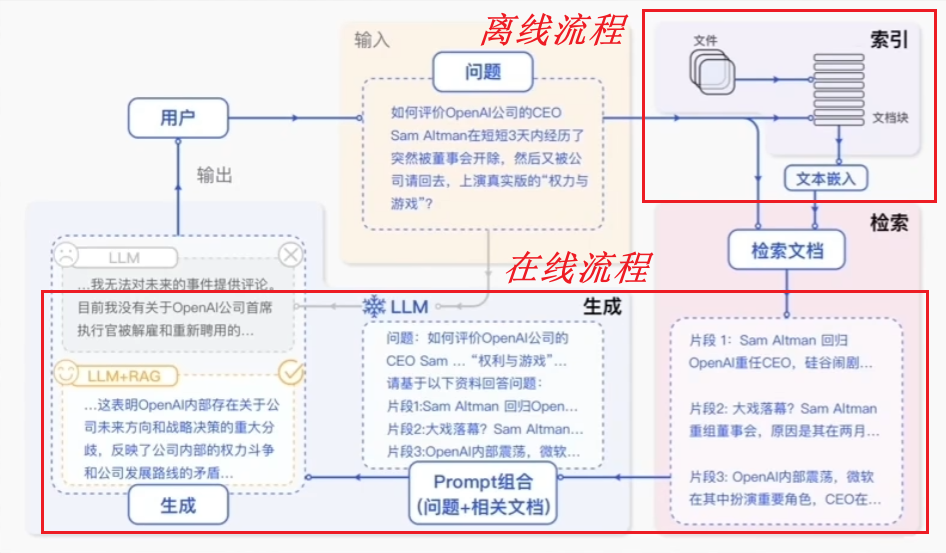
RAG 标准流程
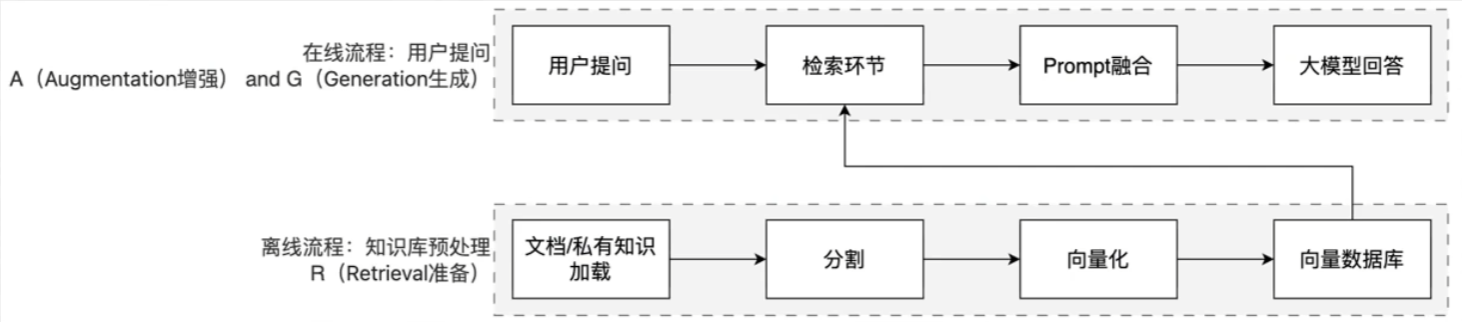
简单来说,RAG 工作分为两条线:
- 离线准备线:R
- 在线服务线:A and G
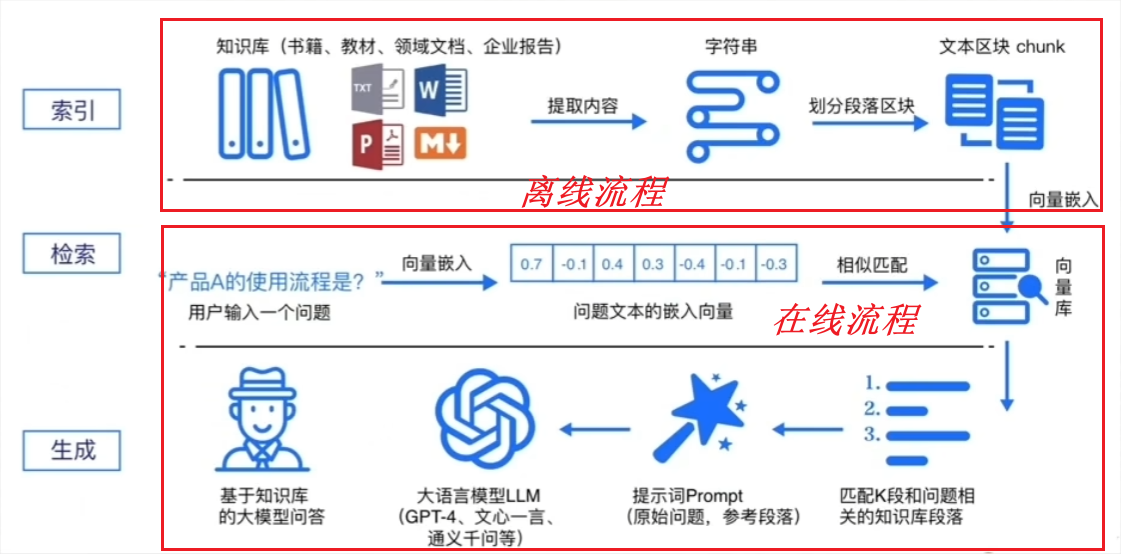
RAG 标准流程由索引(Indexing)、检索(Retriever)和生成(Generation)三个核心阶段组成
-
索引阶段:通过处理多种来源、多种格式的文档提取其中文本,将其切分为标准长度的文本块(chunk),并进行嵌入向量化(embedding),向量存储在向量数据库(vector database)中。
加载文件、内容提取、文本分割形成 chunk、文本向量化、存向量数据库
-
检索阶段:用户输入的查询(query)被转化成向量表示,通过相似度匹配从向量数据库中检索出最相关的文本块
query 向量化、在文本向量中匹配出与问句向量相似的 top_k 个
-
生成阶段:检索到的相关文本与原始查询共同构成提示词(Prompt),输入大语言模型(LLM),生成精确且具备上下文关联的回答
匹配出的文本作为上下文和问题一起添加到 prompt 中、提交给 LLM 生成答案
模型本质上就是用户输入,模型给出输出,用户能做的就是在输入上做功夫
RAG 就是在向模型提问之前基于已有的知识库或文档内容做检索,确保向模型提问的内容更精准以及包含足够的信息量以提供给模型
向量的基础概念
RAG 流程中,向量库是一个重要的节点
- 离线流程:知识和信息 —> 向量嵌入(向量化)—> 存入向量库
- 在线流程:用户的提问 —> 向量嵌入(向量化)—> 在向量库中匹配
向量
向量(vector)就是文本的“数学身份证”:它把一段文字的语义信息,转换成一串固定长度的数字列表,让计算机能“看懂”文字的含义并做相似度计算
简单来说,就是让计算机更方便的理解不同的文本内容,是否表述的是一个意思
文本嵌入模型
文本嵌入模型(如 text-embedding-v1)通过深度学习等技术,从文本提取语义特征并映射为固定长度的数字序列
向量嵌入的过程,我们一般选用合适的文本嵌入模型来完成
在向量匹配的过程中,如何识别 2 段文本是否表述相似的含义,主要可以通过如余弦相似度等算法来完成,比如(数值只做示例,非真实向量):
- A:“如何快速学会打篮球” —> [ 0.2,0.5,0.8 ]
- B:“打篮球怎么学得快” —> [ 0.18,0.52,0.79 ]
- C:“运动后吃什么好呢” —> [ 0.9,0.1,0.2 ]
通过余弦相似度算法可以得到:A 和 B相似度 0.999789,A 和 C 相似度 0.361446,由此可以通过精确的数学计算,去匹配 2 段文本是否描述同一个意思,提高语义匹配的效率和精度
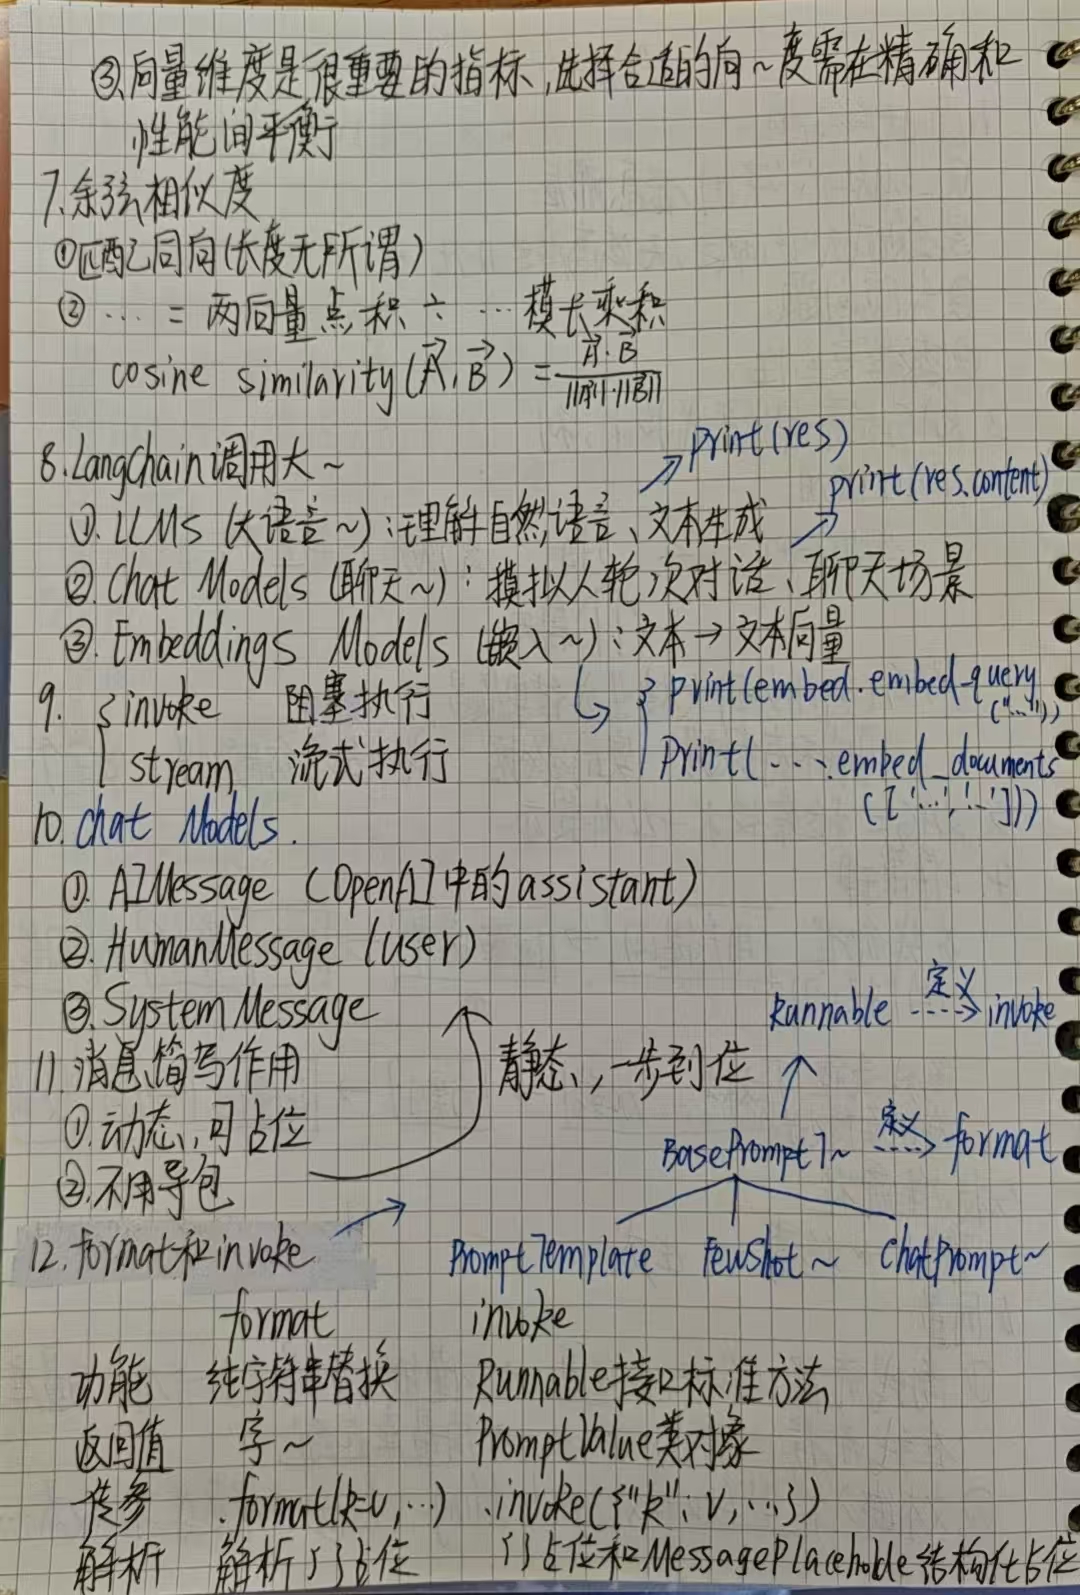
如何更为精准的完成语义匹配,生成向量的维度是一个很重要的指标
如 text-embedding-v1 模型,可以生成 1536 维的向量(一段文本固定得到 1536 个数字序列),1536 个数字表示,这段文本在 1536 个主题(抽象的语义特征)方向上的得分(强度)
- 生成向量的维度越多,就更好的记录文本的语义特征,做语义匹配会更加精准
- 更多的向量会在计算、存储和匹配过程中,带来更大的压力
选择合适的向量维度需要在精准和性能之间做平衡,一般 1536 维是比较好的选择
余弦相似度算法
向量的数学序列,共同决定了向量在高维空间中的方向和长度,而余弦相似度主要就是撇除长度的影响,得到方向的夹角。夹角越小越相似,即方向相同
以一维向量为例:

以二维向量为例:
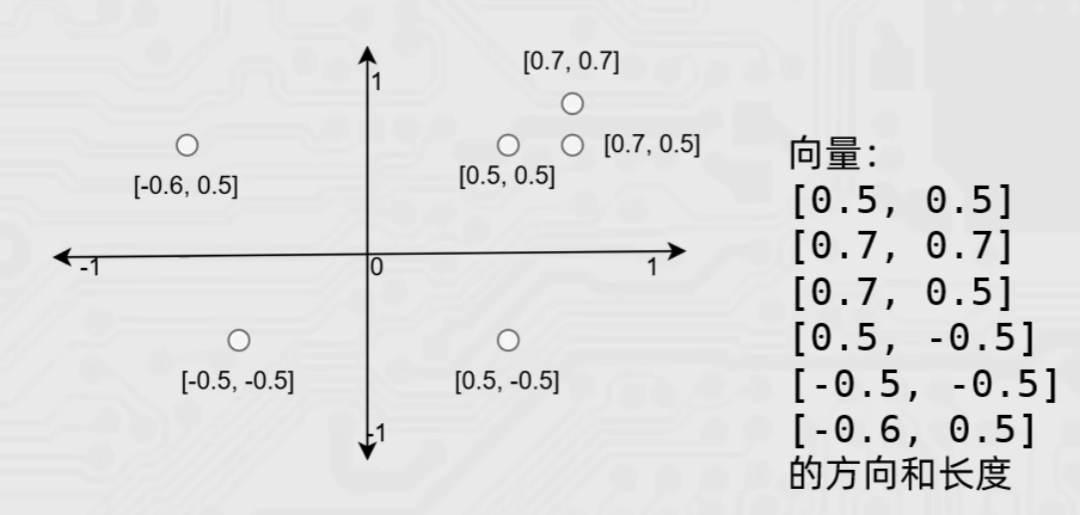
三维乃至更高纬度难以描述,但概念一致
在文本向量语义匹配中,余弦相似度是衡量两个向量方向相似程度的核心算法,即判断两端文本语义是否相近
即:
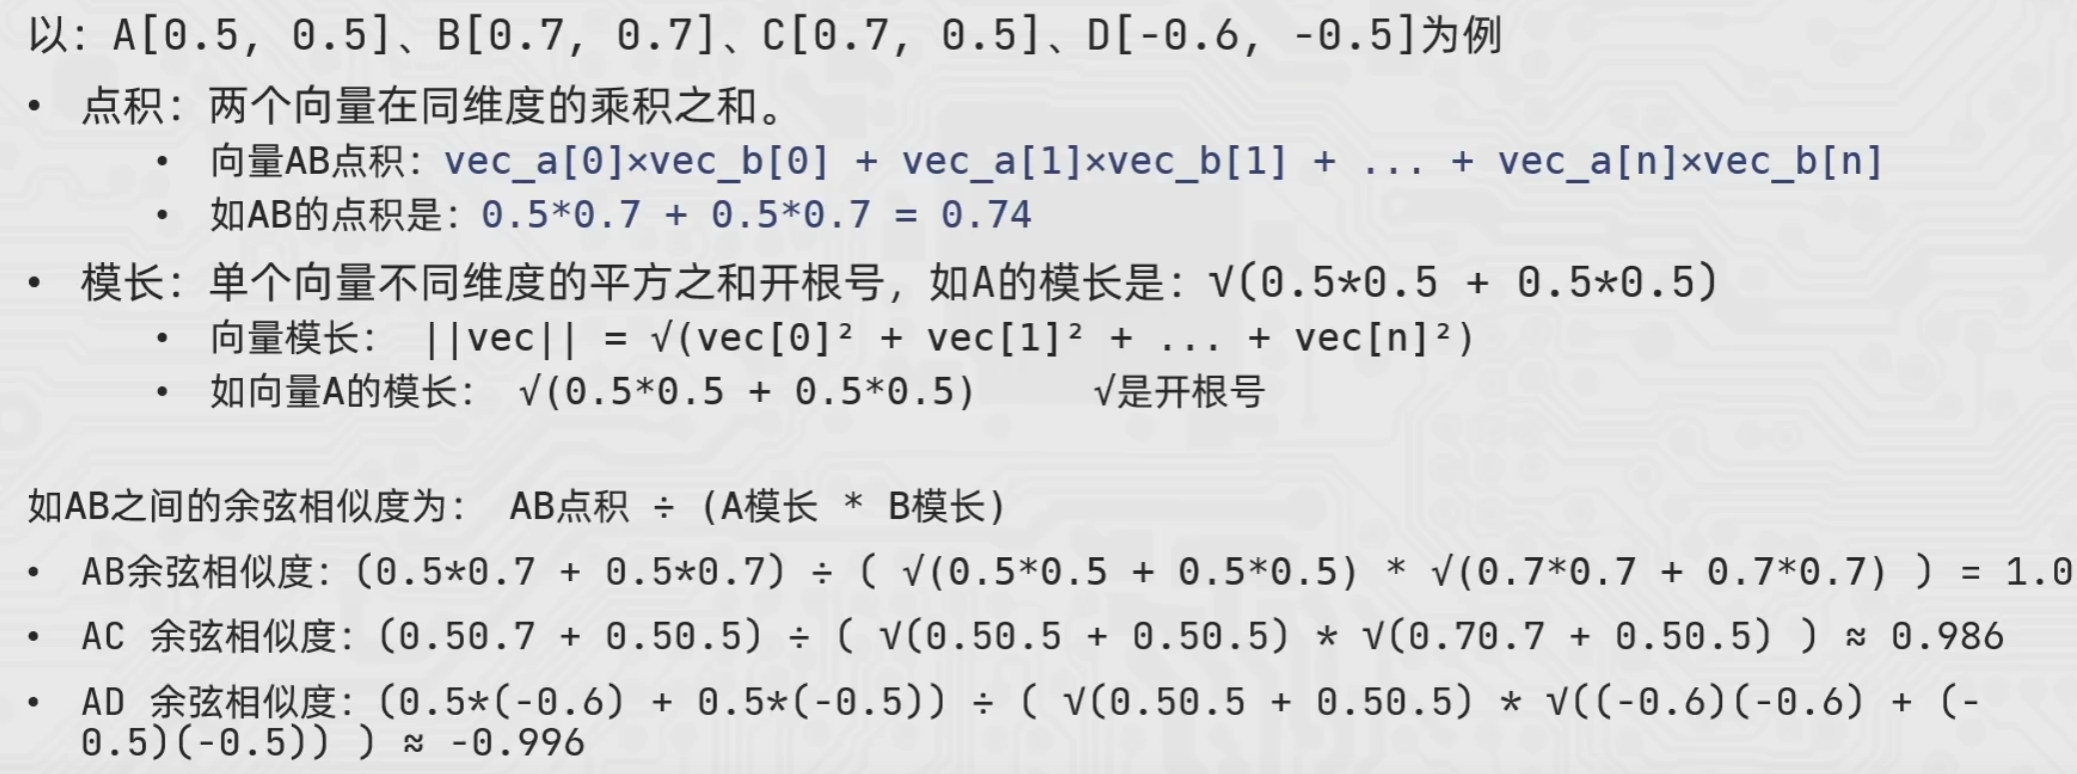
代码实现余弦相似度计算
import numpy as np

"""
计算两个向量的余弦相似度

参数:
    vec_a (np.array): 向量A
    vec_b (np.array): 向量B
返回:
    float: 余弦相似度结果(范围[-1,1],越接近1方向越一致)
公式:
    cos_sim = (vec_a · vec_b) / (||vec_a|| × ||vec_b||)
    拆解:
    1. 点积:vec_a · vec_b = vec_a[0]×vec_b[0] + vec_a[1]×vec_b[1] + ... + vec_a[n]×vec_b[n]
    2. 模长:||vec_a|| = √(vec_a[0]² + vec_a[1]² + ... + vec_a[n]²)
    3. 模长:||vec_b|| = √(vec_b[0]² + vec_b[1]² + ... + vec_b[n]²)

A: [0.5, 0.5]
B: [0.7, 0.7]
C: [0.7, 0.5]
D: [-0.6, -0.5]
"""

def get_dot(vec_a, vec_b):
    """计算2个向量的点积,2个向量同维度数字乘积之和"""
    if len(vec_a) != len(vec_b):
        raise ValueError("2个向量必须维度数量相同")

    dot_sum = 0
    for a, b in zip(vec_a, vec_b):
        dot_sum += a * b

    return dot_sum

def get_norm(vec):
    """计算单个向量的模长:对向量的每个数字求平方在求和在开根号"""
    sum_square = 0
    for v in vec:
        sum_square += v * v

    # numpy sqrt函数完成开根号
    return np.sqrt(sum_square)

def cosine_similarity(vec_a, vec_b):
    """余弦相似度:2个向量的点积 除以 2个向量模长的乘积"""
    result = get_dot(vec_a, vec_b) / (get_norm(vec_a) * get_norm(vec_b))
    return result

if __name__ == '__main__':
    vec_a = [0.5, 0.5]
    vec_b = [0.7, 0.7]
    vec_c = [0.7, 0.5]
    vec_d = [-0.6, -0.5]

    print("ab:", cosine_similarity(vec_a, vec_b))
    print("ac:", cosine_similarity(vec_a, vec_c))
    print("ad:", cosine_similarity(vec_a, vec_d))
六、RAG 开发
现在市面上的模型多如牛毛,各种模型不断出现,LangChain 模型组件提供了与各种模型的集成,并为所有模型提供一个精简的统一接口
LangChain 目前支持三种类型的模型:LLMs(大语言模型)、Chat Models(聊天模型)、Embeddings Models(嵌入模型)
- LLMs:是技术范畴的统称,指基于大量参数、海量文本训练的 Transformer 架构模型,核心能力是理解和生成自然语言,主要服务与文本生成场景
- Chat Models:聊天模型,是应用范畴的细分,是专为对话场景优化的 LLMs,核心能力是模拟人类对话的轮次交互,主要服务与聊天场景
- Embeddings Models:接受文本作为输入,得到文本的向量
LangChain 支持的三类模型,它们的使用场景不同,输入输出不同,开发者需要根据项目需要选择
LangChain 调用大模型
LLMs 使用场景最多,常用大模型的下载库:
同时 LangChain 支持对许多模型的调用,以通义千问为例:
from langchain_community.llms.tongyi import Tongyi

# 实例化模型
model = Tongy(models='qwen-max')

# 推理模型
res = model.invoke(input="帮我讲个笑话")
print(res)
如果要访问本地 ollama 模型,只需要通过 langchain_ollama 包导入 OllamaLLM 类即可
from langchain_ollama import OllamaLLM

model = OllamaLLM(model='qwen3:4b')

res = model.invoke(input="帮我讲个笑话")
print(res)
LangChain 流式输出
如果需要流式输出结果,只需要将 invoke 方法改为 stream 方法即可
invoke:一次性返回完整结果stream:逐渐返回结果,流式输出
from langchain_community.llms.tongyi import Tongyi

# 实例化模型
model = Tongy(models='qwen-max')

# 推理模型
res = model.stream(input="帮我讲个笑话")

for chunk in res:
    print(chunk, end="", flush=True)
LangChain 调用聊天模型
聊天模型包含下面几种类型,使用时需要按照约定传入合适的值:
- AIMessage:AI 输入的消息。可以是针对问题的回答
- HumanMessage:用户信息
- SystemMessage:指定模型具体所处环境和背景
云模型
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage

model = ChatTongyi(model="qwen3-max")

# 准备消息列表
messages = [
    SystemMessage(content="你是一个边塞诗人。"),
    HumanMessage(content="写一首唐诗"),
    AIMessage(content="锄禾日当午,汗滴禾下土,谁知盘中餐,粒粒皆辛苦。"),
    HumanMessage(content="按照你上一个回复的格式,在写一首唐诗。")
]

res = model.stream(input=messages)

# for 循环迭代打印输出,通过 .content 来获取到内容
for chunk in res:
    print(chunk.content, end="", flush=True)
本地模型
from langchain_ollama import ChatOllama
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage

model = ChatOllama(model="qwen3:4b")

messages = [
    SystemMessage(content="你是一个边塞诗人。"),
    HumanMessage(content="写一首唐诗"),
    AIMessage(content="锄禾日当午,汗滴禾下土,谁知盘中餐,粒粒皆辛苦。"),
    HumanMessage(content="按照你上一个回复的格式,在写一首唐诗。")
]

res = model.stream(input=messages)

for chunk in res:
    print(chunk.content, end="", flush=True)
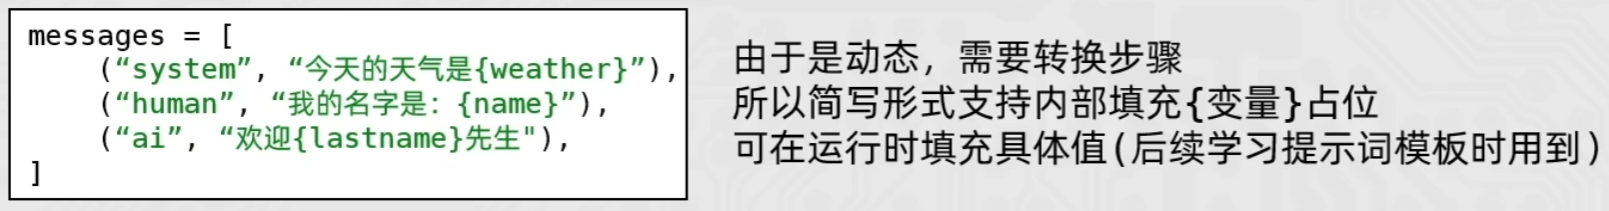
LangChain 消息的简写形式
- SystemMessage(content=“内容”) —> (“system”, “内容”)
- HumanMessage(content=“内容”) —> (“human”, “内容”)
- AIMessage(content=“内容”) —> (“human”, “内容”)
from langchain_community.chat_models.tongyi import ChatTongyi

model = ChatTongyi(model="qwen3-max")

messages = [
    ("system", "你是一个边塞诗人。"),
    ("human", "写一首唐诗。"),
    ("ai", "锄禾日当午,汗滴禾下土,谁知盘中餐,粒粒皆辛苦。"),
    ("human", "按照你上一个回复的格式,在写一首唐诗。")
]

res = model.stream(input=messages)

for chunk in res:
    print(chunk.content, end="", flush=True)
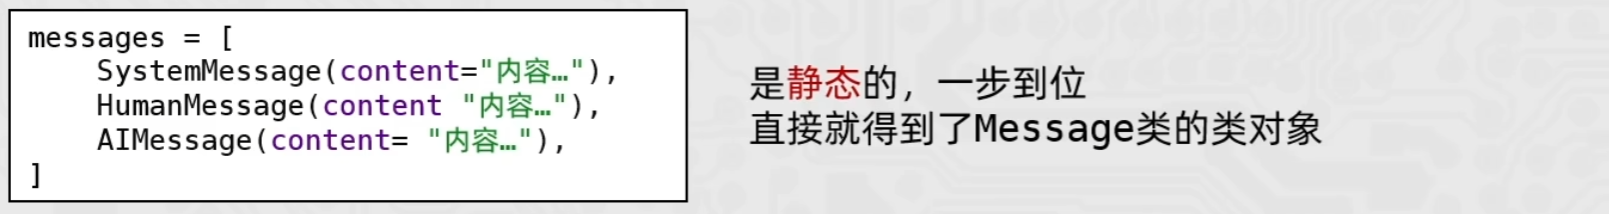
区别和优势在于:
使用类对象的形式
简写形式
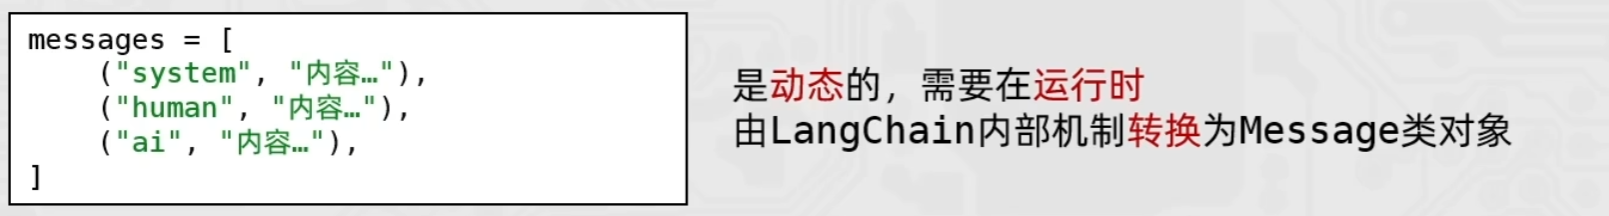
好处在于,简写形式避免导包、写起来更简单,更重要的是支持:
LangChain 调用嵌入模型
Embedding Models 嵌入模型的特点:将字符串作为输入,返回一个浮点数的列表(向量)。在 NLP 中,Embedding 的作用就是将数据进行文本向量化
云模型
from langchain_community.embeddings import DashScopeEmbeddings

# 创建模型对象 不传model默认用的是 text-embeddings-v1
model = DashScopeEmbeddings()

# embed_query: 单次转换
# embed_documents: 批量转换
print(model.embed_query("我喜欢你"))
print(model.embed_documents(["我喜欢你", "我稀饭你", "晚上吃啥"]))
本地模型
from langchain_ollama import OllamaEmbeddings

model = OllamaEmbeddings(model="qwen3-embedding:4b")

print(model.embed_query("我喜欢你"))
print(model.embed_documents(["我喜欢你", "我稀饭你", "晚上吃啥"]))
API 总结
| 方式 | LLMs 大语言模型 | 聊天模型 | 文本嵌入模型 |
|---|---|---|---|
| 阿里云千问 | from langchain_community.llms.tongyi import Tongyi | from langchain_community.chat_models.tongyi import ChatTongyi | from langchain_community.embeddings import DashScopeEmbeddings |
| Ollama 本地模型 | from langchain_ollama import OllamaLLM | from langchain_ollama import ChatOllama | from langchain_ollama import OllamaEmbeddings |
| 方法 | invoke 批量 stream 流式 | invoke 批量 stream 流式 | embed_query 单次转换 embed_documents 批量转换 |
PromptTemplate 通用提示词模板
提示词优化在模型应用中非常重要,LangChain 提供了 PromptTemplate 类,用来协助优化提示词
PromptTemplate 表示提示词模板,可以构建一个自定义的基础提示词模板,支持变量的注入,最终生成所需的提示词
标准写法
from langchain_core.prompts import PromptTemplate
from langchain_community.llms.tongyi import Tongyi

# zero-shot
prompt_template = PromptTemplate.from_template(
    "我的邻居姓{lastname}, 刚生了{gender}, 你帮我起个名字,简单回答。"
)

# 变量注入,生成提示词文本
prompt_text = prompt_template.format(lastname="张", gender="女儿")

model = Tongyi(model="qwen-max")
res = model.invoke(input=prompt_text)
print(res)
这种写法与下面的基础写法有什么区别呢?
lastname = "张"
gender = "女儿"
s = f"我的邻居姓{lastname}, 刚生了{gender}, 你帮我起个名字,简单回答。"区别就是prompt_template 是一个 PromptTemplate 对象,其为 Runnable 接口的子类,可以加入到 LangChain 中的 chain 中
基于 chain 链的写法
from langchain_core.prompts import PromptTemplate
from langchain_community.llms.tongyi import Tongyi

# zero-shot
prompt_template = PromptTemplate.from_template(
    "我的邻居姓{lastname}, 刚生了{gender}, 你帮我起个名字,简单回答。"
)
model = Tongyi(model="qwen-max")

# chain 链
chain = prompt_template | model

# 基于链,调用模型获取结果
res = chain.invoke(input={"lastname": "张", "gender": "女儿"})
print(res)
FewShotPromptTemplate 提示词模板
from langchain_core.prompts import PromptTemplate, FewShotPromptTemplate

few_shot_template = FewShotPromptTemplate(
    example_prompt=None,                      # 示例数据的模板
    examples=None,                            # 示例的数据(用来注入动态数据),list 内套字典
    prefix=None,                              # 示例之前的提示词
    suffix=None,                              # 示例之后的提示词
    input_variables=[]                        # 声明在前缀或后缀中所需要注入的变量名
)
案例
from langchain_core.prompts import PromptTemplate, FewShotPromptTemplate
from langchain_community.llms.tongyi import Tongyi

# 示例的模板
example_template = PromptTemplate.from_template("单词:{word}, 反义词:{antonym}")

# 示例的动态数据注入 要求是list内部套字典
examples_data = [
    {"word": "大", "antonym": "小"},
    {"word": "上", "antonym": "下"},
]

few_shot_template = FewShotPromptTemplate(
    example_prompt=example_template,
    examples=examples_data,
    prefix="告知我单词的反义词,我提供如下的示例:",
    suffix="基于前面的示例告知我,{input_word}的反义词是?",
    input_variables=['input_word']
)

prompt_text = few_shot_template.invoke(input={"input_word": "左"}).to_string()
print(prompt_text)

model = Tongyi(model="qwen-max")

print(model.invoke(input=prompt_text))
模板类的 format 和 invoke 方法
在 PromptTemplate(通用提示词模版)、 FewShotPromptTemplate(FewShot 提示词模板)以及 ChatPromptTemplate(对话提示词模板) 都拥有 format 和 invoke 方法
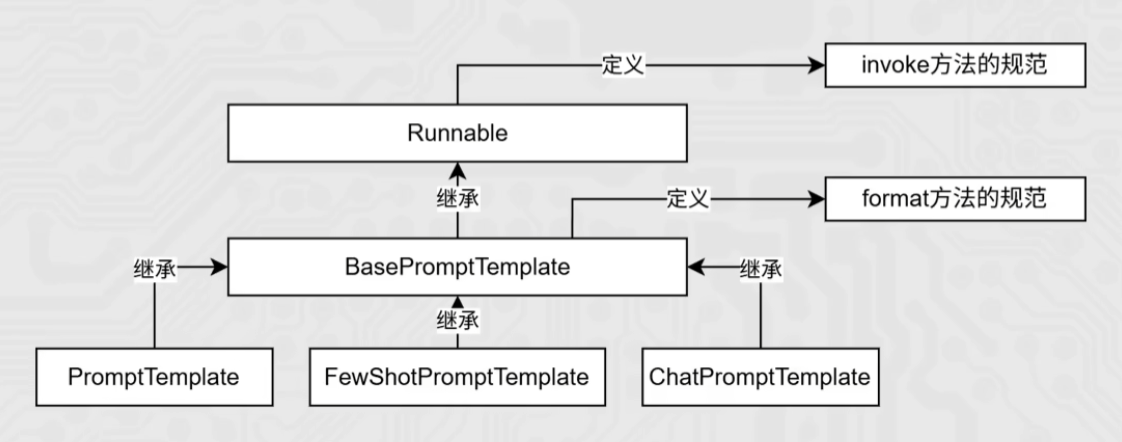
format 和 invoke 的区别:
| 区别 | format | invoke |
|---|---|---|
| 功能 | 纯字符串替换,解析占位符生成提示词 | Runnable 接口标准方法,解析占位符生成提示词 |
| 返回值 | 字符串 | PromptValue 类对象 |
| 传参 | .format(k=v, k=v, ······) | .invoke({“k”:v, “k”:v, ······}) |
| 解析 | 支持解析{}占位符 | 支持解析{}占位符和 MessagesPlaceholder 结构化占位符 |
所以前面在查看提示词时用到 .to_string():
prompt_text = few_shot_template.invoke(input={"input_word": "左"}).to_string()from langchain_core.prompts import PromptTemplate
from langchain_core.prompts import FewShotPromptTemplate
from langchain_core.prompts import ChatPromptTemplate
from langchain_community.llms.tongyi import Tongyi
from langchain_community.chat_models.tongyi import ChatTongyi
template = PromptTemplate.from_template("我的邻居是:{lastname},最喜欢:{hobby}")
res = template.format(lastname="张大明", hobby="钓鱼")
print(res, type(res))
"""
我的邻居是:张大明,最喜欢:钓鱼
<class 'str'>
"""
res2 = template.invoke({"lastname": "周杰轮", "hobby": "唱歌"})
print(res2, type(res2)
"""
text='我的邻居是:周杰轮,最喜欢:唱歌'
<class 'langchain_core.prompt_values.StringPromptValue'>
"""ChatPromptTemplate 提示词模板
- PromptTemplate:通用提示词模板,支持动态注入信息
- FewShotPromptTemplate:支持基于模板注入任意数量的示例信息
- ChatPromptTemplate:支持注入任意数量的历史会话信息
通过 from_messages 方法,从列表中获取多轮次会话作为聊天的基础模板。前面 PromptTemplate 类用的 from_template 仅能接入一条消息,而 from_messages 可以接入一个 list 的消息
历史会话信息并不是静态的(固定的),而是随着对话的进行不停地积攒,即动态的。所以,历史会话信息需要支持动态注入。
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_community.chat_models.tongyi import ChatTongyi

chat_prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个边塞诗人,可以作诗。"),
        MessagesPlaceholder("history"),
        ("human", "请再来一首唐诗"),
    ]
)

history_data = [
    ("human", "你来写一个唐诗"),
    ("ai", "床前明月光,疑是地上霜,举头望明月,低头思故乡"),
    ("human", "好诗再来一个"),
    ("ai", "锄禾日当午,汗滴禾下锄,谁知盘中餐,粒粒皆辛苦"),
]

prompt_text = chat_prompt_template.invoke({"history": history_data}).to_string()

model = ChatTongyi(model="qwen3-max")

res = model.invoke(prompt_text)
print(res.content, type(res))
chains 链的基础使用
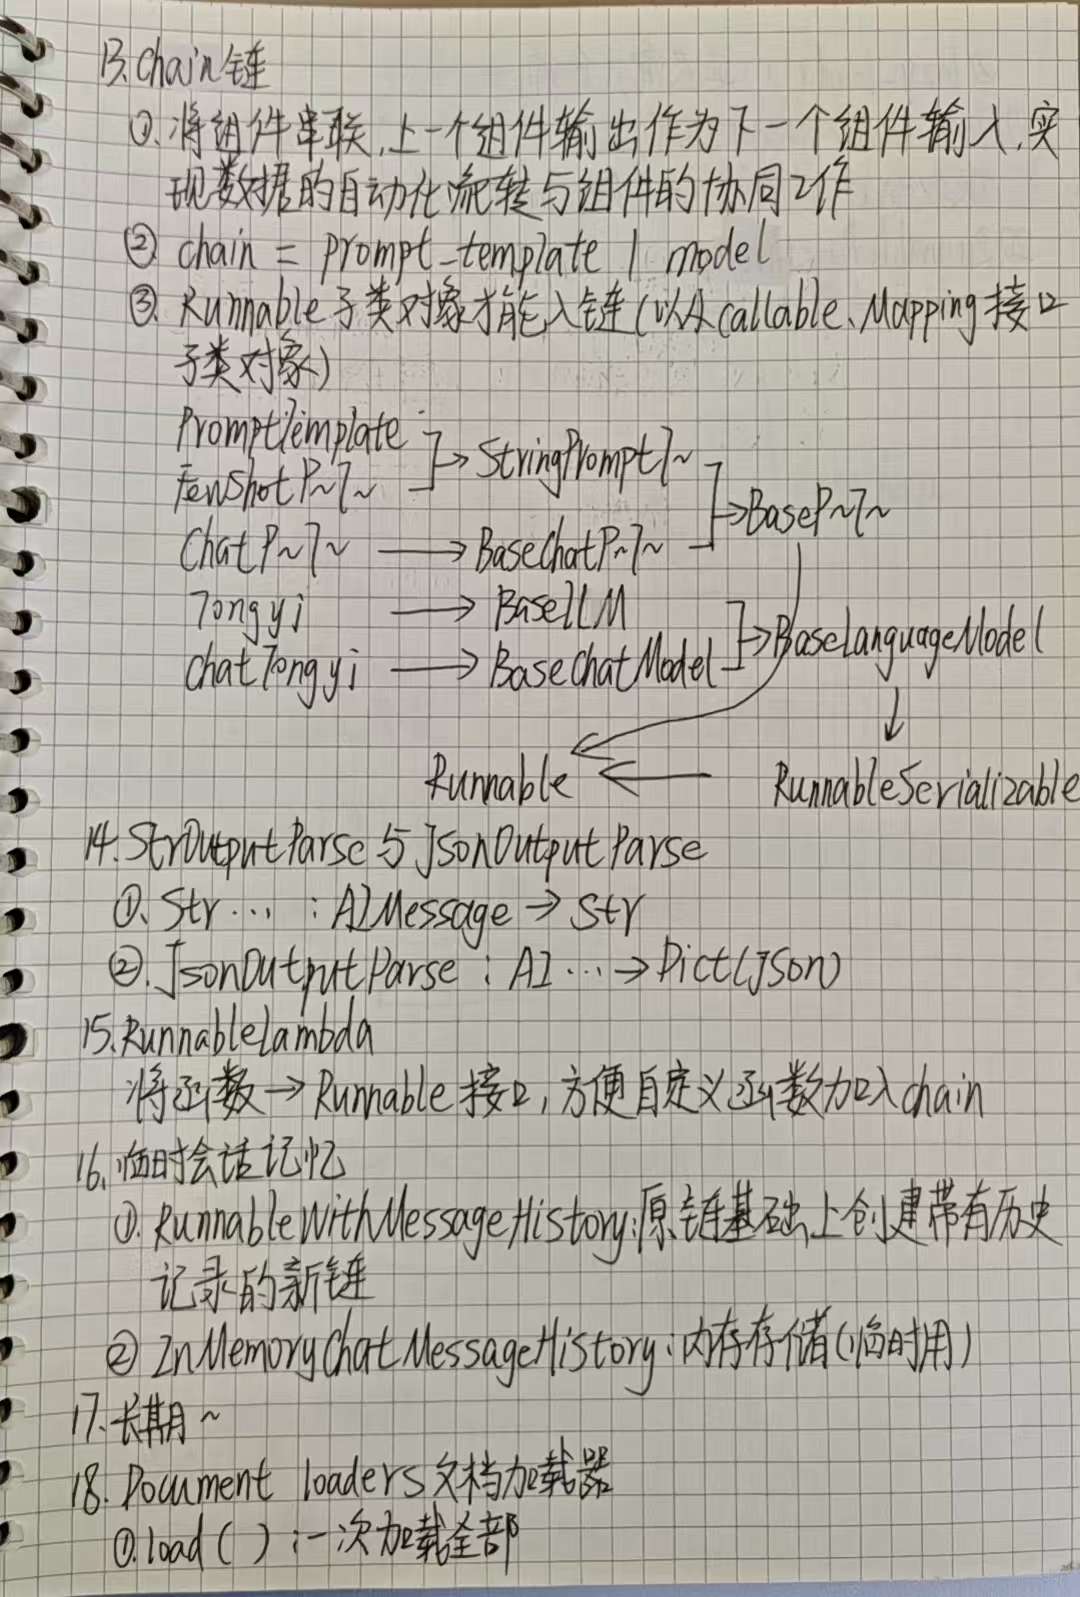
「 将组件串联,上一个组件的输出作为下一个组件的输入 」是 LangChain 链(尤其是 | 管道链)的核心工作原理,这也是链式调用的核心价值:实现数据的自动化流转与组件的协同工作,如下:
chain = prompt_template | model核心前提:Runnable 的子类对象才能入链(以及 Callable、Mapping 接口子类对象也可加入(用的不多))。
我们目前所学习到的组件,均是Runnable接口的子类,如下类的继承关系:
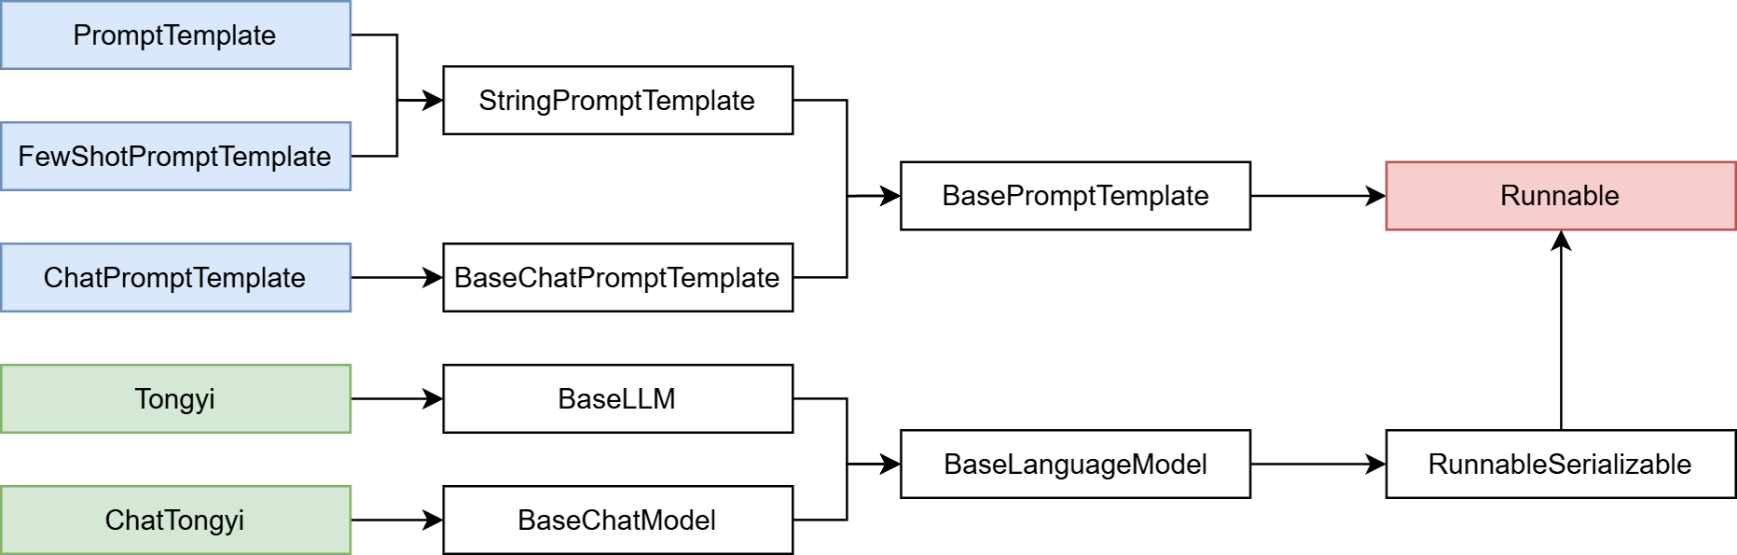
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_community.chat_models.tongyi import ChatTongyi

chat_prompt_template = ChatPromptTemplate.from_messages(
    [
        ("system", "你是一个边塞诗人,可以作诗。"),
        MessagesPlaceholder("history"),
        ("human", "请再来一首唐诗"),
    ]
)

history_data = [
    ("human", "你来写一个唐诗"),
    ("ai", "床前明月光,疑是地上霜,举头望明月,低头思故乡"),
    ("human", "好诗再来一个"),
    ("ai", "锄禾日当午,汗滴禾下锄,谁知盘中餐,粒粒皆辛苦"),
]

model = ChatTongyi(model="qwen3-max")

# 组成链,要求每一个组件都是 Runnable 接口的子类
chain = chat_prompt_template | model

# 通过链去调用 invoke
# res = chain.invoke({"history": history_data})
# print(res.content)

# 通过 stream 流式输出
for chunk in chain.stream({"history": history_data}):
    print(chunk.content, end="", flush=True)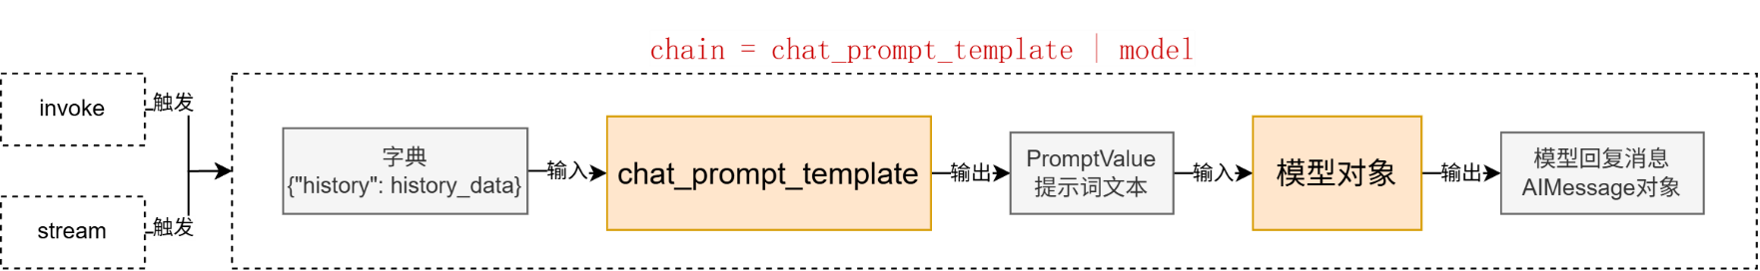
拓展:“|” 运算符的重写
前文代码中: chain = chat_prompt_template | model,在语法上使用了 | 运算符的重写
在 Python 中,运算符(如 +、|)的行为由类的魔法方法决定。例如:
-
a + b 本质调用的是 :
a.__or__(b) -
a | b 本质调用的是:
a.__or__(b)
只需要自行实现类的 or 方法,即可对 | 符号的功能进行重写
Runnable 接口
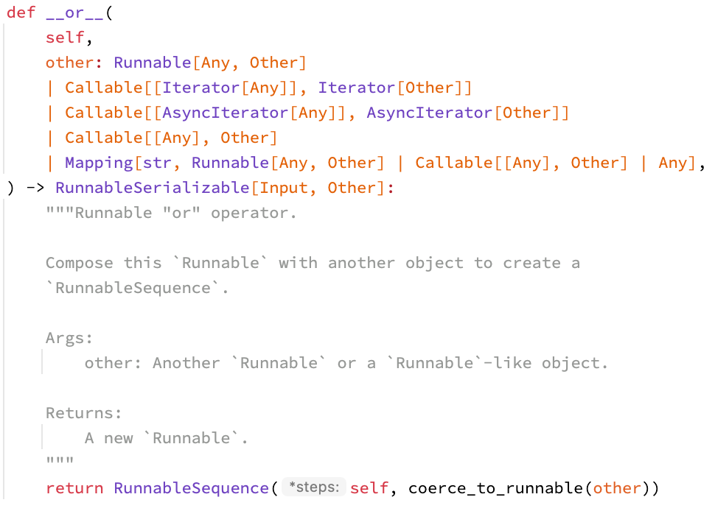
LangChain 中的绝大多数核心组件都继承了 Runnable 抽象基类(位于 langchain_core.runnables.base)
chain 变量是 RunnableSequence(RunnableSerializable 子类)类型,而得到这个类型的原因就是 Runnable 基类内部对 or 魔术方法的改写
同时,在后面继续使用 | 添加新的组件,依旧会得到 RunnableSequence,这就是链的基础架构
StrOutputParser 解析器
有如下代码,想要以第一次模型的输出结果,第二次去询问模型:
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi

model = ChatTongyi(model="qwen3-max")

prompt = PromptTemplate.from_template(
    "我邻居姓:{lastname}, 刚生了{gender},请起名,仅告知名字无需其它内容"
)

chain = prompt | model | model

res = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res.content)
chain = prompt | model | model:
-
链的构建完全符合要求(参与的组件)
-
但是运行报错
-
错误的主要原因是:
• prompt的结果是 PromptValue 类型,输入给了 model
• model的输出结果是:AIMessage
模型(ChatTongyi)源码中关于 invoke 方法明确指定了 input 的类型:
@override
def invoke(
    self,
    input: LanguageModelInput,
    config: RunnableConfig | None = None,
    *,
    stop: list[str] | None = None,
    **kwargs: Any,
) -> AIMessage:
LanguageModelInput = PromptValue | str | Sequence[MessageLikeRepresentation]
"""Input to a language model."""需要做类型转换
可以借助 LangChain 内置的解析器,StrOutputParser 字符串输出解析器
StrOutputParser 是 LangChain 内置的简单字符串解析器
- 可以将 AIMessage 解析为简单的字符串,符合了模型 invoke 方法要求(可传入字符串,不接收 AIMessage 类型)
- 是 Runnable 接口的子类(可以加入链)
parser = StrOutputParser()
chain = prompt | model | parser | model
修改后的代码如下:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi

parser = StrOutputParser()
model = ChatTongyi(model="qwen3-max")
prompt = PromptTemplate.from_template(
    "我邻居姓:{lastname},刚生了{gender},请起名,仅告知我名字无需其它内容。"
)

chain = prompt | model | parser | model

res: AIMessage = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res)

# 如果继续在后面加 | parser
chain = prompt | model | parser | model | parser

res: str = chain.invoke({"lastname": "张", "gender": "女儿"})
print(res.content)
JsonOutputParser 与 多模型执行链
在前面我们完成了这样的需求去构建多模型链,不过这种做法并不标准,因为:
上一个模型的输出,没有被处理就输入下一个模型
正常情况下我们应该有如下处理逻辑:

模型输出的数据类型为 AIMessage,而提示词模版的输入类型为 dict:
def invoke(
    self, input: dict, config: RunnableConfig | None = None, **kwargs: Any
) -> PromptValue:
所以,我们需要完成将模型输出的 AIMessage 转为字典注入第二个提示词模板中,形成新的提示词(PromptValue 对象)
- StrOutputParser:AIMessage 输入、str 输出
- JsonOutputParser:AIMessage 输入、dict 输出
JsonOutputParser 完成多模型链
from langchain_core.output_parsers import StrOutputParser, JsonOutputParser
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.prompts import PromptTemplate

# 创建所需的解析器
str_parser = StrOutputParser()
json_parser = JsonOutputParser()

# 模型创建
model = ChatTongyi(model="qwen3-max")

# 第一个提示词模板
first_prompt = PromptTemplate.from_template(
    "我邻居姓:{lastname},刚生了{gender},请帮忙起名字,"
    "并封装为JSON格式返回给我。要求key是name,value就是你起的名字,请严格遵守格式要求。"
)

# 第二个提示词模板
second_prompt = PromptTemplate.from_template(
    "姓名:{name},请帮我解析含义。"
)

# 构建链(AIMessage("{name: 张若曦}")
chain = first_prompt | model | json_parser | second_prompt | model | str_parser

for chunk in chain.stream({"lastname": "张", "gender": "女儿"}):
    print(chunk, end="", flush=True)
RunnableLambda 与 自定义函数加入链
前文我们根据 JsonOutputParser 完成了多模型执行链条的构建
我们还可以自己编写 Lambda 匿名函数来完成自定义逻辑的数据转换,想怎么转换就怎么转换,更自由
想要完成这个功能,可以基于RunnableLambda类实现
RunnableLambda 类是 LangChain 内置的,将普通函数等转换为 Runnable 接口实例,方便自定义函数加入 chain
语法:
RunnableLambda( 函数对象 或 lambda 匿名函数 )from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import PromptTemplate
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.runnables import RunnableLambda
model = ChatTongyi(model="qwen3-max")
str_parser = StrOutputParser()
first_prompt = PromptTemplate.from_template(
"我邻居姓:{lastname},刚生了{gender},请帮忙起名字,仅生成一个名字,并告知我名字,不要额外信息。"
)
second_prompt = PromptTemplate.from_template(
"姓名{name},请帮我解析含义。"
)
# 函数的入参:AIMessage -> dict ({"name": "xxx"})
my_func = RunnableLambda(lambda ai_msg: {"name": ai_msg.content})
chain = first_prompt | model | my_func | second_prompt | model | str_parser
for chunk in chain.stream({"lastname": "曹", "gender": "女孩"}):
print(chunk, end="", flush=True)其中 my_func 接受来自 model 的输出(AIMessage),返回 {"name": 模型输出的结果 }
跳过 RunnableLambda 类,直接让函数加入链也是可以的。因为 Runnable 接口类在实现 or 的时候,支持 Callable 接口的实例(函数就是 Callable 接口的实例):
def __or__(
    self,
    other: Runnable[Any, Other]
    | Callable[[Iterator[Any]], Iterator[Other]]
    | Callable[[AsyncIterator[Any]], AsyncIterator[Other]]
    | Callable[[Any], Other]
    | Mapping[str, Runnable[Any, Other] | Callable[[Any], Other] | Any],
) -> RunnableSerializable[Input, Other]:
如上代码示例,| 符号(底层是调用 or)组链,是支持函数加入的。其本质是将函数自动转换为 RunnableLambda
chain = first_prompt | model | (lambda ai_msg: {"name": ai_msg.content}) | second_prompt | model | str_parserMemory 临时会话记忆
如果想要封装历史记录,除了自行维护历史消息外,也可以借助 LangChain 内置的历史记录附加功能
LangChain提供了History功能,帮助模型在有历史记忆的情况下回答
- 基于 RunnableWithMessageHistory 在原有链的基础上创建带有历史记录功能的新链(新 Runnable 实例)
- 基于 InMemoryChatMessageHistory 为历史记录提供内存存储(临时用)
from langchain_core.runnables.history import RunnableWithMessageHistory

# 通过 RunnableWithMessageHistory 获取一个新的带有历史记录功能的 chain ( conversation_chain )
conversation_chain = RunnableWithMessageHistory(
    some_chain,                           # 被附加历史消息的 Runnable,通常是 chain
    None,                                 # 获取指定会话 ID 的历史会话的函数
    input_messages_key="input",           # 声明用户输入消息在模板中的占位符
    history_messages_key="chat_history"   # 声明历史消息在模板中的占位符
)
其中 None 中提供 ID,返回历史会话记录,其中历史会话记录封装在 InMemoryChatMessageHistory 中
# 获取指定会话 ID 的历史会话记录函数
chat_history_store = {}            # 存放多个会话 ID 所对应的历史会话记录
# 函数传入为会话 ID(字符串类型)
# 函数要求返回 BaseChatMessageHistory 的子类
# BaseChatMessageHistory 类专用于存放某个会话的历史记录
# InMemoryChatMessageHistory 是官方自带的基于内存存放历史记录的类
def get_history(session_id):
    if session_id not in chat_history_store:
        # 返回一个新的实例
        chat_history_store[session_id] = InMemoryChatMessageHistory()
        return chat_history_store[session_id]
完整代码
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.prompts import PromptTemplate, ChatPromptTemplate, MessagesPlaceholder
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables.history import RunnableWithMessageHistory
from langchain_core.chat_history import InMemoryChatMessageHistory

model = ChatTongyi(model="qwen3-max")
str_parser = StrOutputParser()
prompt = PromptTemplate.from_template(
    "你需要根据会话历史回应用户问题。对话历史:{chat_history},用户提问:{input},请回答"
)
"""
# 优化:
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你需要根据会话历史回应用户问题。对话历史:"),
        MessagesPlaceholder("chat_history"),
        ("human", "请回答如下问题:{input}")
    ]
)
"""

def print_prompt(full_prompt):
    print("="*20, full_prompt.to_string(), "="*20)
    return full_prompt

base_chain = prompt | print_prompt | model | str_parser

store = {}      # key 就是 session,value 就是 InMemoryChatMessageHistory 类对象
# 实现通过会话 id 获取 InMemoryChatMessageHistory 类对象
def get_history(session_id):
    if session_id not in store:
        store[session_id] = InMemoryChatMessageHistory()

    return store[session_id]

# 创建一个新的链,对原有链增强功能:自动附加历史消息
conversation_chain = RunnableWithMessageHistory(
    base_chain,     				    # 被增强的原有 chain
    get_history,    				    # 通过会话 id 获取 InMemoryChatMessageHistory 类对象
    input_messages_key="input",         # 表示用户输入在模板中的占位符
    history_messages_key="chat_history" # 表示历史消息在模板中的占位符
)

if __name__ == '__main__':
    # 固定格式,添加 LangChain 的配置,为当前程序配置所属的 session_id
    session_config = {
        "configurable": {
            "session_id": "user_001"
        }
    }

    res = conversation_chain.invoke({"input": "小明有2个猫"}, session_config)
    print("第1次执行:", res)
    res = conversation_chain.invoke({"input": "小刚有1只狗"}, session_config)
    print("第2次执行:", res)
    res = conversation_chain.invoke({"input": "总共有几个宠物"}, session_config)
    print("第3次执行:", res)
Memory 长期会话记忆
使用 InMemoryChatMessageHistory 仅可以在内存中临时存储会话记忆,一旦程序退出,则记忆丢失
InMemoryChatMessageHistory 类继承自 BaseChatMessageHistory,在官方注释中给出了相关实现的指南,并给出了基于文件的历史消息存储示例代码:
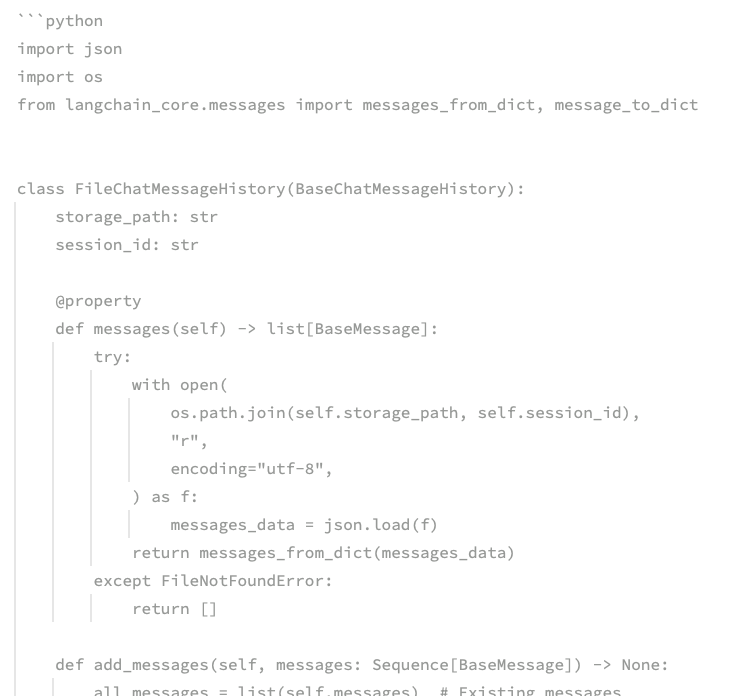
我们可以自行实现一个基于 Json 格式和本地文件的会话数据保存
FileChatMessageHistory 类实现,核心思路:
-
基于文件存储会话记录,以 session_id 为文件名,不同 session_id 有不同文件存储消息
-
继承 BaseChatMessageHistory 实现如下3个方法:
• add_messages:同步模式,添加消息
• messages:同步模式,获取消息
• clear:同步模式,清除消息
如下面代码,官方在 BaseChatMessageHistory 类的注释中提供了一个基于文件存储的示例代码:
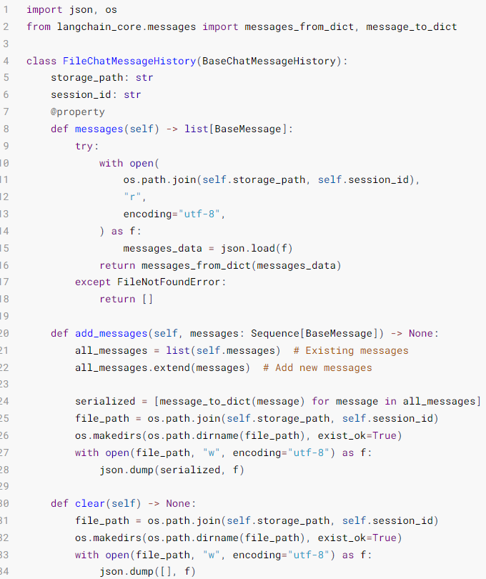
from __future__ import annotations

import os, json
from typing import Sequence

from langchain_community.chat_models import ChatTongyi
from langchain_core.messages import message_to_dict, messages_from_dict, BaseMessage
from langchain_core.chat_history import BaseChatMessageHistory
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.runnables import RunnableWithMessageHistory

# message_to_dict:单个消息对象(BaseMessage 类实例) -> 字典
# messages_from_dict:[字典、字典...]  -> [消息、消息...]
# AIMessage、HumanMessage、SystemMessage 都是 BaseMessage 的子类

class FileChatMessageHistory(BaseChatMessageHistory):
    def __init__(self, session_id, storage_path):
        self.session_id = session_id        # 会话 id
        self.storage_path = storage_path    # 不同会话 id 的存储文件,所在的文件夹路径
        # 完整的文件路径
        self.file_path = os.path.join(self.storage_path, self.session_id)
        # 确保文件夹是存在的
        os.makedirs(os.path.dirname(self.file_path), exist_ok=True)

    def add_messages(self, messages: Sequence[BaseMessage]) -> None:
        # Sequence序列 类似list、tuple
        all_messages = list(self.messages)      # 已有的消息列表
        all_messages.extend(messages)           # 新的和已有的融合成一个 list

        # 将数据同步写入到本地文件中
        # 类对象写入文件 -> 一堆二进制
        # 为了方便,可以将 BaseMessage 消息转为字典(借助 json 模块以 json 字符串写入文件)
        # 官方 message_to_dict:单个消息对象(BaseMessage 类实例) -> 字典
        # new_messages = []
        # for message in all_messages:
        #     d = message_to_dict(message)
        #     new_messages.append(d)

        new_messages = [message_to_dict(message) for message in all_messages]
        # 将数据写入文件
        with open(self.file_path, "w", encoding="utf-8") as f:
            json.dump(new_messages, f)

    @property       # @property 装饰器将 messages 方法变成成员属性用
    def messages(self) -> list[BaseMessage]:
        # 当前文件内: list[字典]
        try:
            with open(self.file_path, "r", encoding="utf-8") as f:
                messages_data = json.load(f)    # 返回值就是:list[字典]
                return messages_from_dict(messages_data)
        except FileNotFoundError:
            return []

    def clear(self) -> None:
        with open(self.file_path, "w", encoding="utf-8") as f:
            json.dump([], f)

model = ChatTongyi(model="qwen3-max")
# prompt = PromptTemplate.from_template(
#     "你需要根据会话历史回应用户问题。对话历史:{chat_history},用户提问:{input},请回答"
# )
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你需要根据会话历史回应用户问题。对话历史:"),
        MessagesPlaceholder("chat_history"),
        ("human", "请回答如下问题:{input}")
    ]
)

str_parser = StrOutputParser()

def print_prompt(full_prompt):
    print("="*20, full_prompt.to_string(), "="*20)
    return full_prompt

base_chain = prompt | print_prompt | model | str_parser

def get_history(session_id):
    return FileChatMessageHistory(session_id, "./chat_history")

# 创建一个新的链,对原有链增强功能:自动附加历史消息
conversation_chain = RunnableWithMessageHistory(
    base_chain,     # 被增强的原有chain
    get_history,    # 通过会话id获取InMemoryChatMessageHistory类对象
    input_messages_key="input",             # 表示用户输入在模板中的占位符
    history_messages_key="chat_history"     # 表示用户输入在模板中的占位符
)

if __name__ == '__main__':
    # 固定格式,添加 LangChain 的配置,为当前程序配置所属的 session_id
    session_config = {
        "configurable": {
            "session_id": "user_001"
        }
    }

    res = conversation_chain.invoke({"input": "小明有2个猫"}, session_config)
    print("第1次执行:", res)
    res = conversation_chain.invoke({"input": "小刚有1只狗"}, session_config)
    print("第2次执行:", res)
    res = conversation_chain.invoke({"input": "总共有几个宠物"}, session_config)
    print("第3次执行:", res)
Document loaders 文档加载器
文档加载器提供了一套标准接口,用于将不同来源(如 CSV、PDF 或 JSON等)的数据读取为 LangChain 的文档格式。这确保了无论数据来源如何,都能对其进行一致性处理
文档加载器(内置或自行实现)需实现 BaseLoader 接口
Class Document,是 LangChain 内文档的统一载体,所有文档加载器最终返回此类的实例
一个基础的 Document 类实例,基于如下代码创建:
from langchain_core.documents import Document

document = Document(
    page_content="Hello, world!", metadata={"source": "https://example.com"}
)
可以看到,Document 类其核心记录了:
- page_content:文档内容
- metadata:文档元数据(字典)
不同的文档加载器可能定义了不同的参数,但是其都实现了统一的接口(方法)
- load():一次性加载全部文档
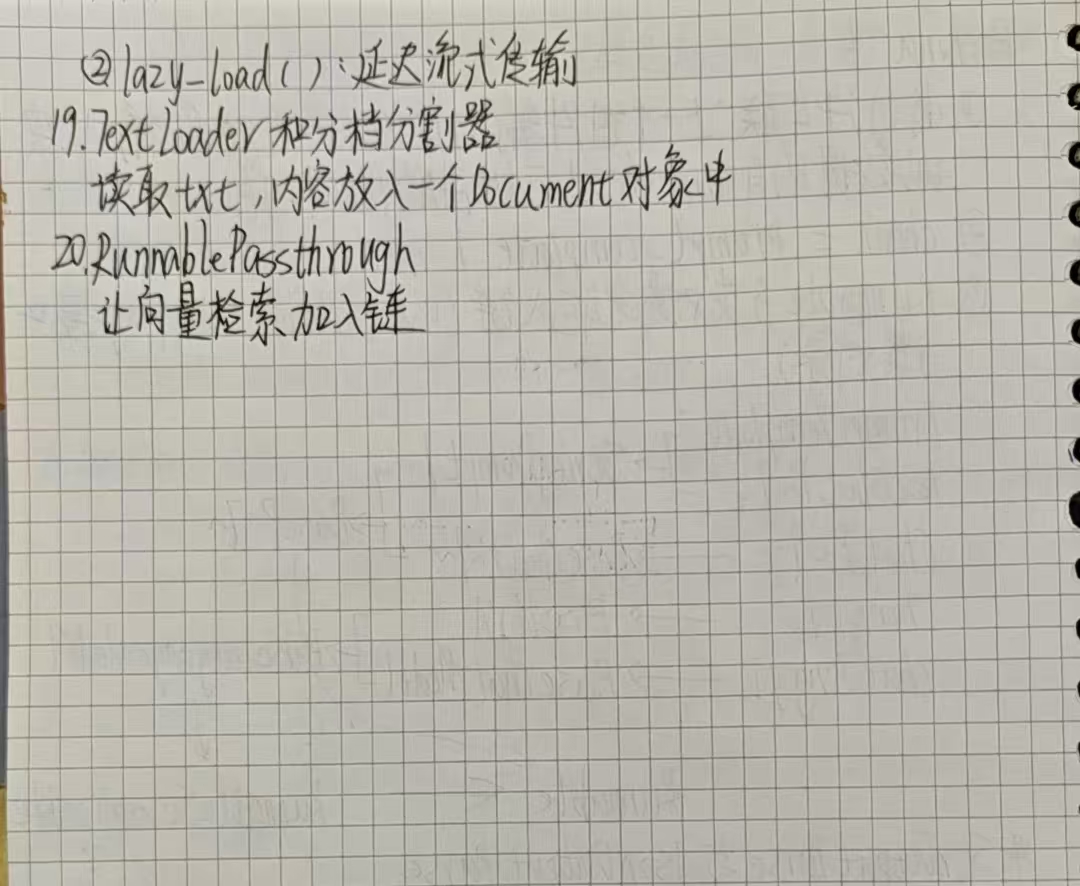
- lazy_load():延迟流式传输文档,对大型数据集很有用,避免内存溢出
一个简单的 CSVLoader 的使用示例如下:
from langchain_community.document_loaders.csv_loader import CSVLoader
loader = CSVLoader(
	......         # 初始化参数
)

# 一次性加载全部文档
documents = loader.load()

# 对于大数据集,分段返回文档
for document in loader.lazy_load():
	print(document)
LangChain 内置了许多文档加载器,详细参见官方文档:
https://docs.langchain.com/oss/python/integrations/document_loaders
我们简单的学习如下几个常用的文档加载器:
- CSVLoader
- JSONLoader
- PDFLoader
CSVLoader
简单示例:
from langchain_community.document_loaders.csv_loader import CSVLoader

loader = CSVLoader(file_path="./xxx.csv")

data = loader.load()
print(data)
自定义 CSV 文件的解析和加载:
from langchain_community.document_loaders.csv_loader import CSVLoader

loader = CSVLoader(
    file_path=“./xxx.csv”,
    csv_args={
        “delimiter”: ",",         # 指定分隔符
        “quotechar”: '"'          # 指定字符串的引号包裹
        # 字段列表(无表头使用,有表头勿用会读取首行做为数据)
        "fieldnames": ["name", "age", "gender"],
    },
)

data = loader.load()
print(data)
实战运用
from langchain_community.document_loaders import CSVLoader

loader = CSVLoader(
    file_path="./data/stu.csv",
    csv_args={
        "delimiter": ",",
        "quotechar": '"',
        "fieldnames": ['name', 'age', 'gender', '爱好']
    },
    encoding="utf-8"            # 指定编码为UTF-8
)

# 批量加载 .load()   ->  [Document, Document, ...]
# documents = loader.load()
#
# for document in documents:
#     print(type(document), document)

# 懒加载  .lazy_load()  迭代器 [Document]
for document in loader.lazy_load():
    print(document)
JSONLoader
JSONLoader 用于将J SON 数据加载为 Document 类型对象
使用 JSONLoader 需要额外安装 jq:
pip install jqjq 是一个跨平台的 json 解析工具,LangChain 底层对 JSON 的解析就是基于 jq 工具实现的。将 JSON 数据的信息抽取出来,封装为 Document 对象,抽取的时候依赖 jq_schema 语法
简单示例 (json 对象):
{
    "name": "周杰轮",
    "age": 11,
    "hobby": ["唱", "跳", "RAP"],
    "other": {
        "addr": "深圳",
        "tel": "12332112321"
     }
}- . 表示整个 JSON 对象(根)
- [] 表示数组
- .name 表示抽取“周杰轮”
- .hobby 表示抽取“爱好”数组
- .hobby[1] 或 .hobby.[1] 表示抽取“跳”
- .other.addr 表示抽取“深圳”
简单示例 (json 数组):
[
    {"name": "周杰轮", "age": 11, "gender": "男"},
    {"name": "蔡依临", "age": 12, "gender": "女"},
    {"name": "王力鸿", "age": 11, "gender": "男"}
]- .[]. 得到 3 个字典
- .[].name 表示抽取全部的 name,即得到 3 个 name 信息
简单示例:
from langchain_community.document_loaders import JSONLoader
loader = JSONLoader(
    file_path="xxx.json",   # 文件路径
    jq_schema=".",          # jq schema 语法
    text_content=False,     # 抽取的是否是字符串,默认 True
    json_lines=True,        # 是否是 JsonLines 文件(每一行都是 JSON 的文件)
)
如下是一个典型的 JsonLines 文件,如果是该类型的文件需要 json_lines=True
{"name": "周杰轮", "age": 11, "gender": "男"}
{"name": "蔡依临", "age": 12, "gender": "女"}
{"name": "王力鸿", "age": 11, "gender": "男"}
实战运用 1
stu.json:
{
    "name": "周杰轮",
    "age": 11,
    "hobby": ["唱", "跳", "RAP"],
    "other": {
        "addr": "深圳",
        "tel": "12332112321"
    }
}
from langchain_community.document_loaders import JSONLoader
# stu.json
loader = JSONLoader(
file_path="./data/stu.json",
jq_schema=".name", # "周杰轮"
# jq_schema=".other.addr", # "深圳"
# jq_schema=".", # 整个数据
)
"""
loader = JSONLoader(
file_path="./data/stu.json",
jq_schema=".", # 整个数据
text_content=False, # 告知 JSONLoader, 我抽取的内容不是字符串
)
"""
document = loader.load()
print(document)实战运用 2
stus.json:
[
    {"name": "周杰轮", "age": 11, "gender": "男"},
    {"name": "蔡依临", "age": 12, "gender": "女"},
    {"name": "王力鸿", "age": 11, "gender": "男"}
]
# stus.json
loader = JSONLoader(
file_path="./data/stus.json",
jq_schema=".[].name", # 所有 "name"
text_content=False, # 告知 JSONLoader 我抽取的内容不是字符串
)
document = loader.load()
print(document)实战运用 3
stu_json_lines.json:
{"name": "周杰轮", "age": 11, "gender": "男"}
{"name": "蔡依临", "age": 12, "gender": "女"}
{"name": "王力鸿", "age": 11, "gender": "男"}
# stu_json_lines.json
loader = JSONLoader(
file_path="./data/stu_json_lines.json",
jq_schema=".name",
text_content=False, # 告知 JSONLoader 我抽取的内容不是字符串
json_lines=True # 告知 JSONLoader 这是一个 JSONLines 文件(每一行都是一个独立的标准 JSON)
)
document = loader.load()
print(document)TextLoader 和 文档分割器
基本的加载器:TextLoader,作用是读取文本文件(如.txt),将全部内容放入一个 Document 对象中
简单示例:
from langchain_community.document_loaders import TextLoader

loader = TextLoader(
    "xxx.txt",                                                                         		encoding="utf-8",
)

docs = loader.load()
print(docs)
print(len(docs))	# 结果为 1
如果文档很大,加载到一个 Document 对象中就不太合适了
RecursiveCharacterTextSplitter(递归字符文本分割器),主要用于按自然段落分割大文档,是 LangChain 官方推荐的默认字符分割器。它在保持上下文完整性和控制片段大小之间实现了良好平衡,开箱即用效果佳
pip install langchain_text_splittersfrom langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
loader = TextLoader(
"./data/Python基础语法.txt",
encoding="utf-8",
)
docs = loader.load()
splitter = RecursiveCharacterTextSplitter(
chunk_size=500, # 分段的最大字符数
chunk_overlap=50, # 分段之间允许重叠的字符数, 确保语义连贯
# 文本分段依据
separators=["\n\n", "\n", "。", "!", "?", ".", "!", "?", " ", ""],
# 字符统计依据(函数)
length_function=len,
)
split_docs = splitter.split_documents(docs)- docs:[ Document ]
- split_docs:[ Document , Document , Document ······ ]
实战运用
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter

loader = TextLoader("./data/Python基础语法.txt", encoding="utf-8")

docs = loader.load()      	  # [Document]

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ".", "!", "?", " ", ""],
    length_function=len,   	  # 统计字符的依据函数
)

split_docs = splitter.split_documents(docs)

# print(split_docs)
print(len(split_docs))
for doc in split_docs:
    print(doc)
    print("="*20)
PyPDFLoader
LangChain 内支持许多 PDF 的加载器,我们选择其中的 PyPDFLoader 使用。PyPDFLoader 加载器,依赖 PyPDF 库,所以需要安装它:
pip install pypdf如下代码即可快速加载 PDF 中的文字内容了:
from langchain_community.document_loaders import PyPDFLoader

loader = PyPDFLoader(
    file_path="",   # 文件路径必填
    mode='page',   	# 读取模式,可选 page(按页面划分不同 Document)和 single(单个Document)
    password='password',  # 文件密码
)
Vector stores 向量存储
基于 LangChain 的向量存储,存储嵌入数据,并执行相似性搜索
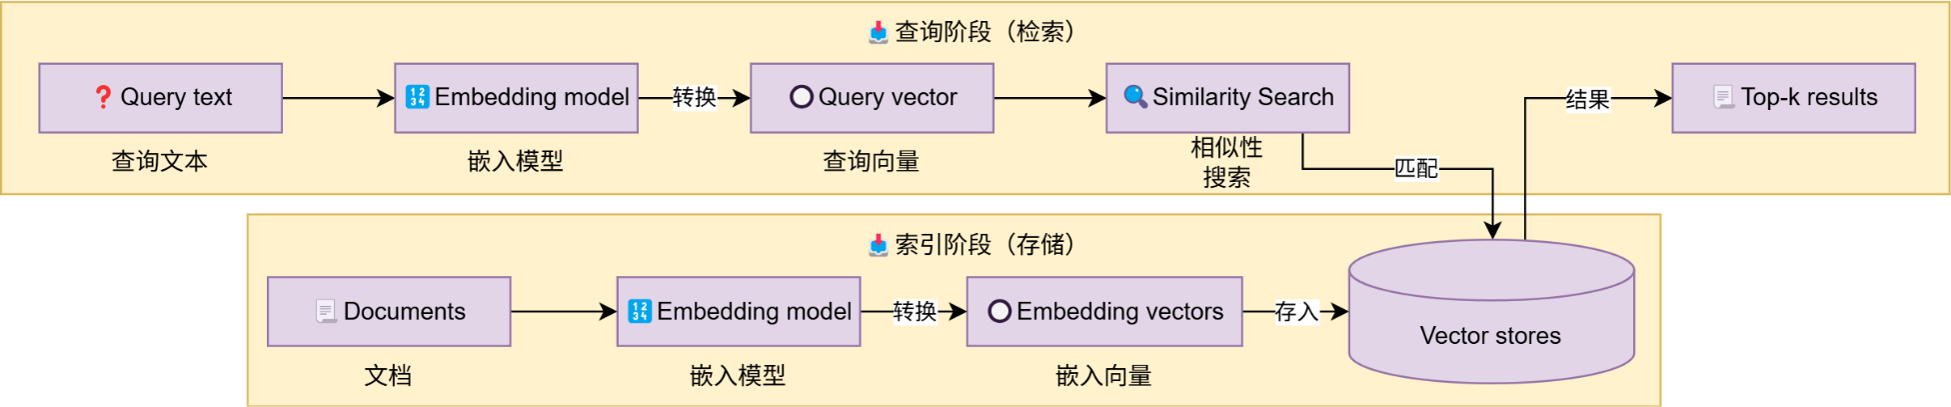
如图,这是一个典型的向量存储应用,也即是典型的 RAG 流程,这部分开发主要涉及到:
-
文本转向量(前文已经学习)
-
创建向量存储,基于向量存储完成:
• 存入向量
• 删除向量
• 向量检索
针对存 / 删 / 检 三个步骤,LangChain 为向量存储提供了统一接口:
- add_documents
- delete
- similarity_search
内置向量存储的使用
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings

vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings())

# 添加文档到向量存储,并指定id
vector_store.add_documents(documents=[doc1, doc2], ids=["id1", "id2"])

# 删除文档(通过指定的id删除)
vector_store.delete(ids=["id1"])

# 相似性搜索
similar_docs = vector_store.similarity_search("your query here", 4)
实战运用
info.csv
source,info
AAA,Python 是世界上最好的编程语言
BBB,我要学 python
AAA,LangChain 极大地方便了大模型开发
AAA,AI 和 Python 是下一个十年的风口
BBB,Python 学起来很简单的
AAA,学习 Python 键盘敲烂月薪过万
AAA,努力带来成就,Python 助力辉煌
AAA,学习 Python 的时候也要记得好好休息打打篮球
AAA,明天晚上吃啥子呀
BBB,如何快速减肥呢
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader
# 文本转向量的模型用哪个?
vector_store = InMemoryVectorStore(
embedding=DashScopeEmbeddings()
)
loader = CSVLoader(
file_path="./data/info.csv",
encoding="utf-8",
source_column="source", # 指定本条数据的来源是哪里
)
# 全量加载
documents = loader.load()
print(documents[1]) # "Python 是世界上最好的编程语言", source: AAA
# id1 id2 id3 id4 ...
# 向量存储的 新增、删除、检索
vector_store.add_documents(
documents=documents, # 被添加的文档,类型:list[Document]
ids=["id"+str(i) for i in range(1, len(documents)+1)] # 给添加的文档提供 id(字符串) list[str]
)
# 删除 传入 [id, id...]
vector_store.delete(["id1", "id2"])
# 检索 返回类型 list[Document]
result = vector_store.similarity_search(
"python 是不是简单易学呀",
1 # 检索的结果要几个
)
print(result)外部(Chroma)向量存储的使用
pip install langchain-chroma chromadbfrom langchain_community.embeddings import DashScopeEmbeddings
from langchain_chroma import Chroma
vector_store = Chroma(
collection_name="example_collection", # 当前向量存储名字,类似数据库的表名称
embedding_function=DashScopeEmbeddings(), # 嵌入模型
persist_directory="./chroma_langchain_db", # 指定数据存放的文件夹
)实战运用
from langchain_chroma import Chroma
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_community.document_loaders import CSVLoader

# Chroma 向量数据库(轻量级的)
vector_store = Chroma(
    collection_name="test",
    embedding_function=DashScopeEmbeddings(),
    persist_directory="./chroma_db"
)

loader = CSVLoader(
     file_path="./data/info.csv",
     encoding="utf-8",
     source_column="source",
)

documents = loader.load()

vector_store.add_documents(
     documents=documents,
     ids=["id"+str(i) for i in range(1, len(documents)+1)]
 )

 # 删除
 vector_store.delete(["id1", "id2"])

# 检索
result = vector_store.similarity_search(
    "Python 是不是简单易学呀",
    1,
    filter={"source": "BBB"}                # 数据过滤
)

print(result)
项目目录中会自动多出来一个 chroma_db 文件
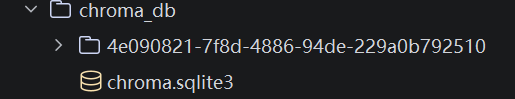
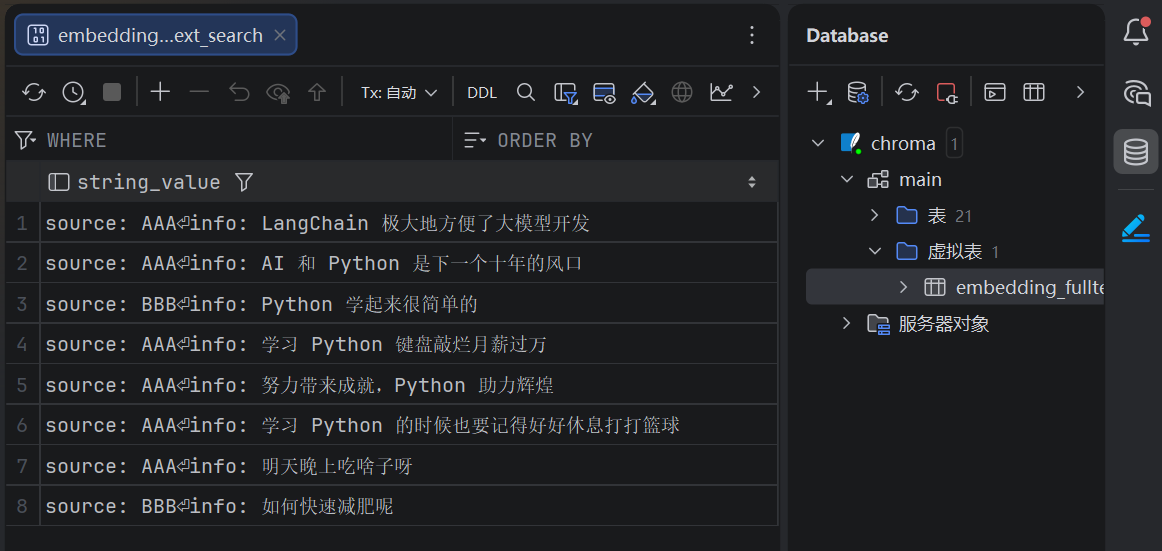
点击 chroma.sqlite3 ,再点击弹出页面左下角的测试连接,在右侧虚拟表中可以查看存储的数据:
检索向量并构建提示词
"""
提示词:用户的提问 + 向量库中检索到的参考资料
"""
from langchain_community.chat_models import ChatTongyi
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

def print_prompt(prompt):
    print(prompt.to_string())
    print("=" * 20)
    return prompt

model = ChatTongyi(model="qwen3-max")
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "以我提供的已知参考资料为主,简洁和专业的回答用户问题。参考资料:{context}。"),
        ("user", "用户提问:{input}")
    ]
)

vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings(model="text-embedding-v4"))

# 准备一下资料(向量库的数据)
# add_texts 传入一个 list[str] ( 临时用 )
vector_store.add_texts(
    ["减肥就是要少吃多练", "在减脂期间吃东西很重要,清淡少油控制卡路里摄入并运动起来", "跑步是很好的运动哦"])

input_text = "怎么减肥?"

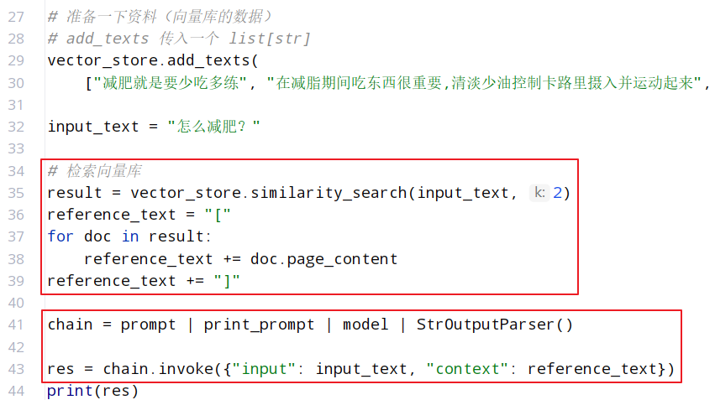
# 检索向量库
result = vector_store.similarity_search(input_text, 2)

reference_text = "["
for doc in result:
    reference_text += doc.page_content
reference_text += "]"
# print(reference_text)
# [减肥就是要少吃多练在减脂期间吃东西很重要,清淡少油控制卡路里摄入并运动起来]

chain = prompt | print_prompt | model | StrOutputParser()

res = chain.invoke({"input": input_text, "context": reference_text})
print(res)
RunnablePassthrough 的使用
能不能让向量检索加入链?
InMemoryVectorStore 不是 Runnable 接口的子类实例对象,不能入链。langchain 中向量存储对象,有一个方法:as_retriever,可以返回一个 Runnable 接口的子类实例对象:
retriever = vector_store.as_retriever(search_kwargs={"k": 2})retriever 就是 Runnable 接口的子类实例对象
那么 retriever 可以入链了吗?
chain = retriever | prompt | model | StrOutputParser()我们观察一下 retriever 和 prompt 的输入输出:
"""
retriever:
    - 输入:用户的提问        		    str
    - 输出:向量库的检索结果			  list[Document]
prompt:
    - 输入:用户的提问 + 向量库的检索结果  dict
    - 输出:完整的提示词                 PromptValue
"""
list[Document] 类型不能作为 prompt 的输入,显然 retriever 还不能入链,并且 prompt 还会丢失 用户的提问
不管 prompt 和 retriever 谁在前,都会丢失 用户的提问 ,如何做到将 用户的提问 同时传给 prompt 和 retriever 呢?
我们可以使用 RunnablePassthrough:
chain = (
    {"input": RunnablePassthrough(), "context": retriever | format_func} | prompt | print_prompt | model | StrOutputParser()
)
在这里我们将字典 {"input": RunnablePassthrough(), "context": retriever | format_func} 入链了,字典可以入链吗?我们可以查看 | 方法:
def __or__(
    self,
    other: Runnable[Output, Other]
    | Callable[[Iterator[Output]], Iterator[Other]]
    | Callable[[AsyncIterator[Output]], AsyncIterator[Other]]
    | Callable[[Output], Other]
    | Mapping[str, Runnable[Output, Any] | Callable[[Output], Any] | Any],
) -> RunnableSerializable[Input, Any]:
Callable 是函数,其中的 Mapping 就是字典的顶级父类,也就是说字典可以入链
现在的 chain 是如何工作的呢?
chain 是一个大链套了一个小链,大链就是 chain,小链就是 retriever | format_func,第一个入链的组件是 retriever。当链 .invoke() 时,输入会给 retriever,而 RunnablePassthrough() 相当于一个占位符,也会将 invoke 的输入带走,input 的值会分别输入给 这两个组件,而 prompt 的输入由 retriever 提供。其中 format_func 是将 retriever 的输出类型 list[Document] 转化成字符串
实战运用
from langchain_community.chat_models import ChatTongyi
from langchain_core.documents import Document
from langchain_core.runnables import RunnablePassthrough
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_community.embeddings import DashScopeEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

def print_prompt(prompt):
    print(prompt.to_string())
    print("=" * 20)
    return prompt

model = ChatTongyi(model="qwen3-max")
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "以我提供的已知参考资料为主,简洁和专业的回答用户问题。参考资料:{context}。"),
        ("user", "用户提问:{input}")
    ]
)

vector_store = InMemoryVectorStore(embedding=DashScopeEmbeddings(model="text-embedding-v4"))

vector_store.add_texts(
    ["减肥就是要少吃多练", "在减脂期间吃东西很重要,清淡少油控制卡路里摄入并运动起来", "跑步是很好的运动哦"])

input_text = "怎么减肥?"

retriever = vector_store.as_retriever(search_kwargs={"k": 2})

def format_func(docs: list[Document]):
    if not docs:
        return "无相关参考资料"

    formatted_str = "["
    for doc in docs:
        formatted_str += doc.page_content
    formatted_str += "]"

    return formatted_str

chain = (
    {"input": RunnablePassthrough(), "context": retriever | format_func} | prompt | print_prompt | model | StrOutputParser()
)

res = chain.invoke(input_text)
print(res)
七、Agent 智能体
Agent 简介
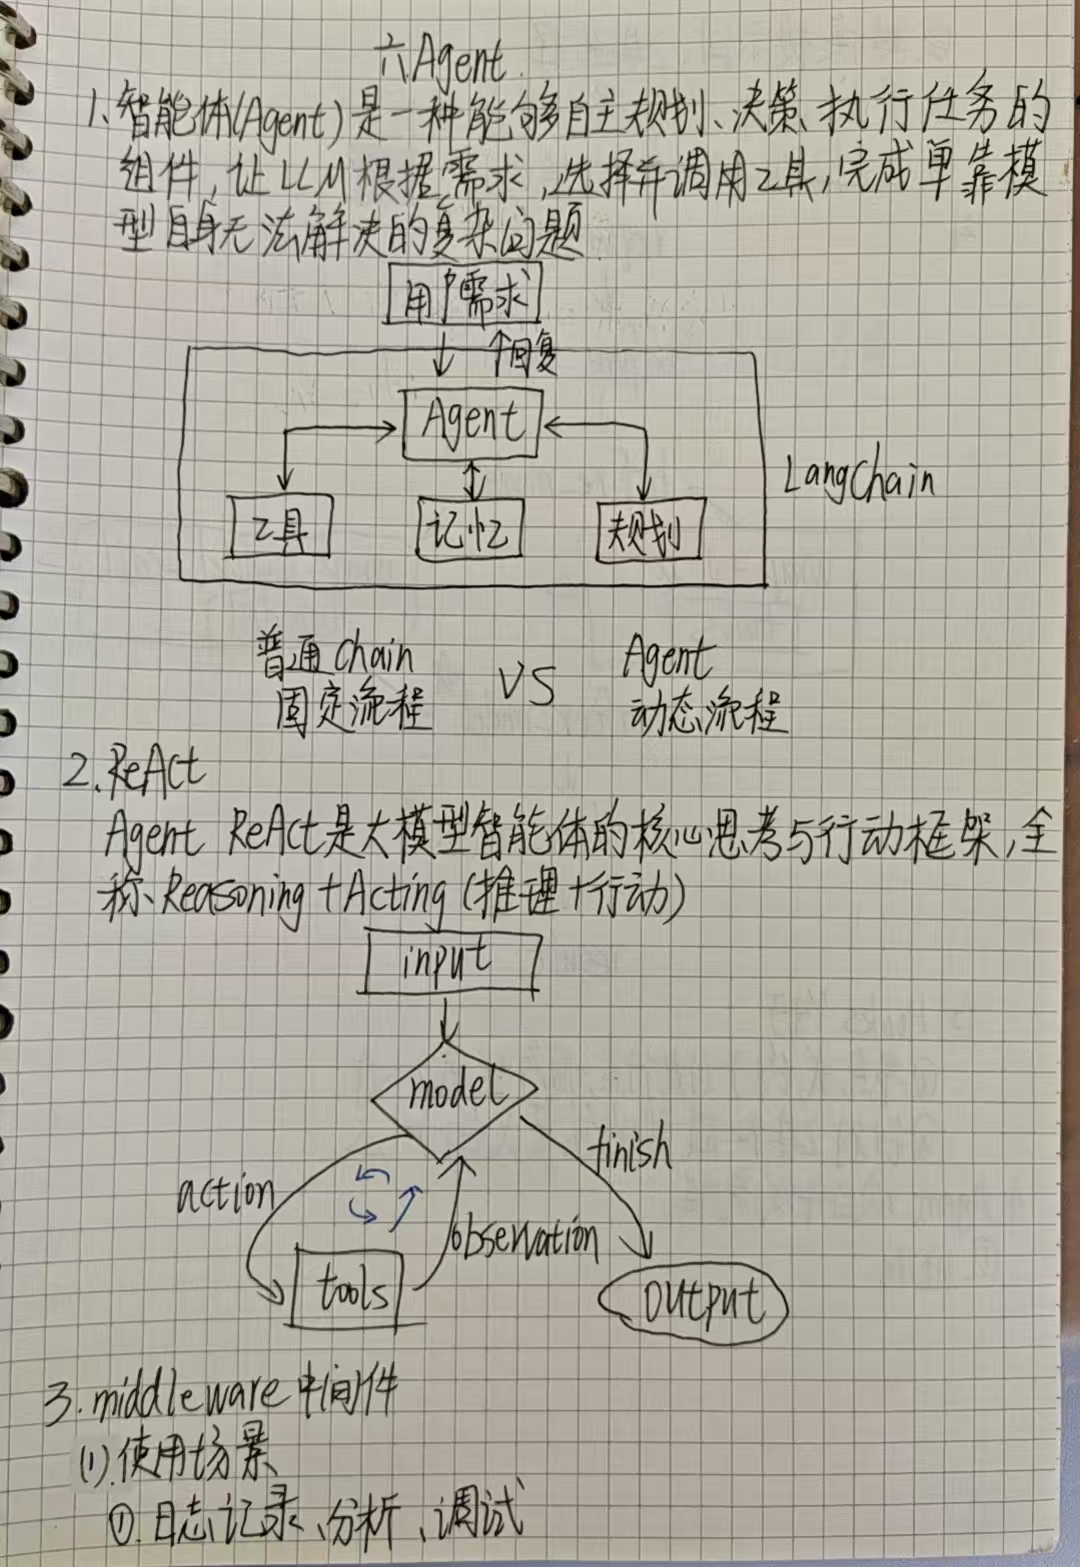
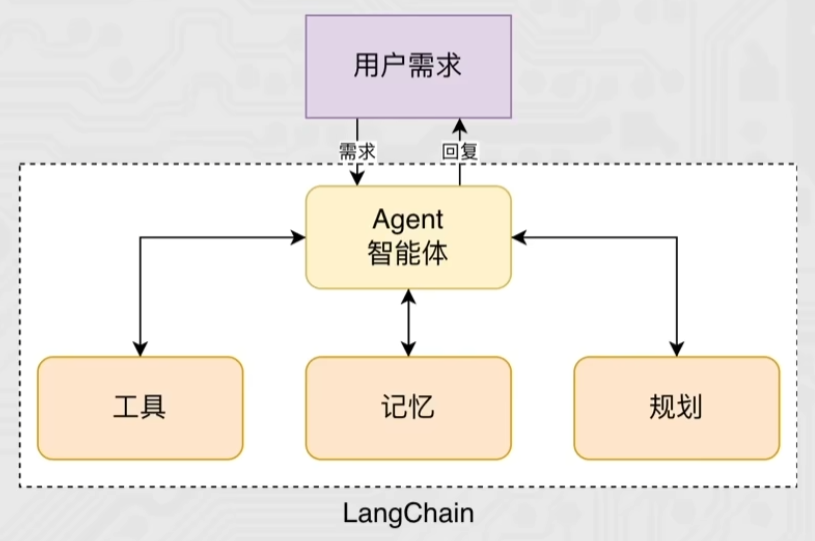
智能体是一种能够自主规划、决策、执行任务的组件,核心是让大语言模型(LLM)根据任务需求,选择并调用工具,完成单靠模型自身无法解决的复杂问题
- 没有 Agent 时,LLM 只能基于自身训练数据回答问题,遇到需要实时数据、复杂计算、外部工具调用的场景会卡壳
- 有了 Agent 后,LLM 就像一个“指挥官”,能思考任务步骤 ——> 选择合适工具 ——> 执行工具调用 ——> 根据结构调整策略,直到完成任务
Agent 核心特点:
- 目标驱动:围绕用户的具体任务目标展开工作
- 工具调用能力:能连接外部工具,弥补 LLM 的局限性
- 自主决策与迭代:不需要人工干预,能根据工具返回的结果,判断是否需要继续调用工具,或直接生成最终答案
以电商商品问答为例:
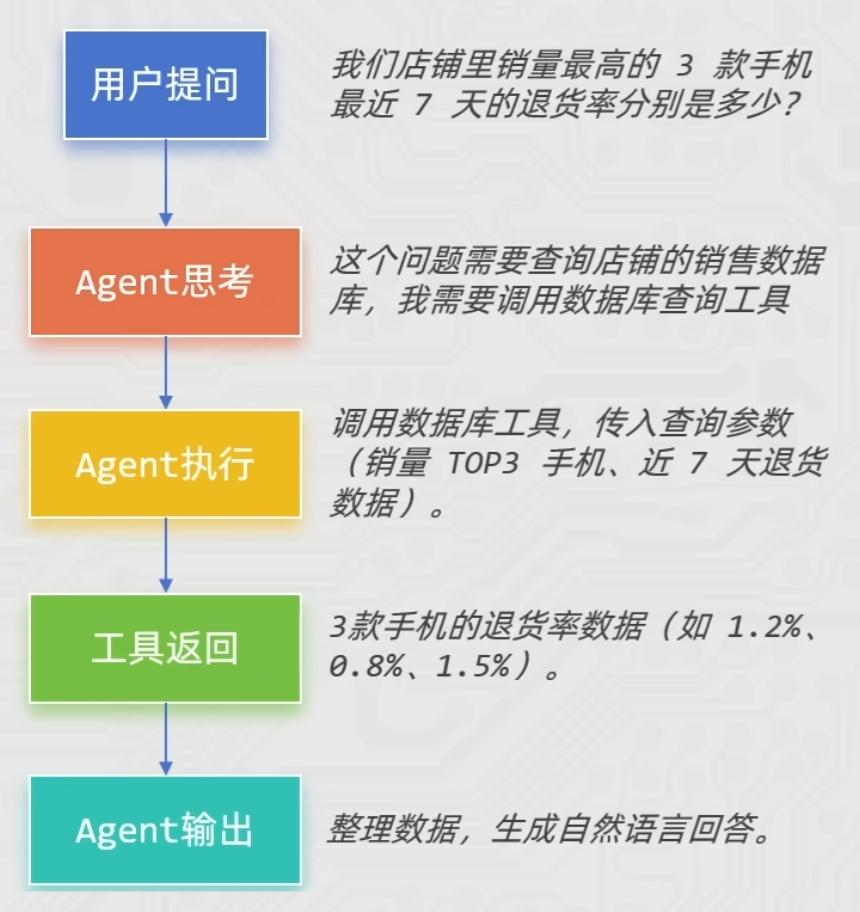
普通 Chain 与 Agent 对比:
| 普通 Chain | Agent |
|---|---|
| 执行流程固定,按预设步骤运行 | 执行流程动态,根据任务和结果自主调整 |
| 工具调用路径写死在代码里 | 工具选择由 LLM 思考决定 |
| 适合简单、标准化任务 | 适合复杂、多步骤、需要决策的任务 |
Agent 智能体 = 大语言模型(大脑) + 工具集(手脚) + 决策逻辑(思维), 是让 LLM 从 “只会回答” 升级为 “会做事(影响现实世界)” 的智能助手
Agent 初体验
from langchain.agents import create_agent
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool

# 扩展大语言模型的能力边界
@tool(description="查询天气")
def get_weather() -> str:
    return "晴天"

agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),           # 智能体的大脑 LLM
    tools=[get_weather],                           # 向智能体提供工具列表
    system_prompt="你是一个聊天助手,可以回答用户问题。",
)

res = agent.invoke(
    {
        "messages": [
            {"role": "user", "content": "明天深圳的天气如何?"},
        ]
    }
)

for msg in res["messages"]:
    print(type(msg).__name__, msg.content)

"""
HumanMessage 明天深圳的天气如何?
AIMessage
ToolMessage 晴天
AIMessage 明天深圳的天气是晴天。建议外出时注意防晒,并保持水分补充!
"""

"""
parse = StrOutputPaeser()

for msg in res["messages"]:
    print(f"{type(msg).__name__}: {parser.invoke(msg)}")
"""
其中第一个 AIMessage 没有输出内容,是模型的思考,ToolMessage 是工具消息
流式输出
通过 create_agent 方法可以创建 Agent 对象,其也是 Runnable 接口的子类实现,所以也拥有:
- invoke 执行:一次型得到完整结果
- stream 执行:流式得到结果
for chunk in agent.stream({
    "messages": [{"role": "user", "content": "Search for AI news and summarize the findings"}]
}, stream_mode="values"):
    # 每个块都包含该时刻的完整状态, 所以取最后一条, 即为最新
    latest_message = chunk["messages"][-1]
    if latest_message.content:
        print(f"Agent: {latest_message.content}")
    elif latest_message.tool_calls:
        print(f"Calling tools: {[tc['name'] for tc in latest_message.tool_calls]}")
实战运用
from langchain.agents import create_agent
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool

@tool(description="获取股价,传入股票名称,返回字符串信息")
def get_price(name: str) -> str:
    return f"股票{name}的价格是20元"

@tool(description="获取股票信息,传入股票名称,返回字符串信息")
def get_info(name: str) -> str:
    return f"股票{name},是一家A股上市公司,专注于IT职业教育。"

agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    tools=[get_price, get_info],
    system_prompt="你是一个智能助手,可以回答股票相关问题,记住请告知我思考过程,让我知道你为什么调用某个工具"
)

for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "传智教育股价多少,并介绍一下"}]},
    stream_mode="values"
):
    latest_message = chunk['messages'][-1]

    if latest_message.content:
        print(type(latest_message).__name__, latest_message.content)

    try:
        if latest_message.tool_calls:
            print(f"工具调用: { [tc['name'] for tc in latest_message.tool_calls]  }")
    except AttributeError as e:
        pass
ReAct 行动框
Agent ReAct 是大模型智能体的核心思考与行动框架,全称 Reasoning + Acting(推理 + 行动),是让 Agent 像人类一样「思考问题→制定策略→执行行动→验证结果」的关键逻辑
简单来说:ReAct 让 Agent 不再是 “直接回答问题”,而是通过 “自然语言思考过程” 指导工具调用,一步步解决复杂问题,完美适配需要多步推理、工具协作的场景(如智能客服、报告生成、任务规划等)
一个典型的 ReAct 范式的 Agent 如图所示:
-
思考 Reasoning:分析问题,判断现有信息是否足够,明确下一步
即模型决策是否需要调用外部工具获取更多信息用来回答
-
行动 Action:执行思考阶段指定的策略
即基于模型决策结果,调用工具获取信息
-
观察 Observation:获取行动的结果,提取有效信息
即获取工具返回值即判断工具是否正常工作位下一轮思考提供信息
-
(再)思考 → (再)行动 → (再)观察 → 循环往复直到结束
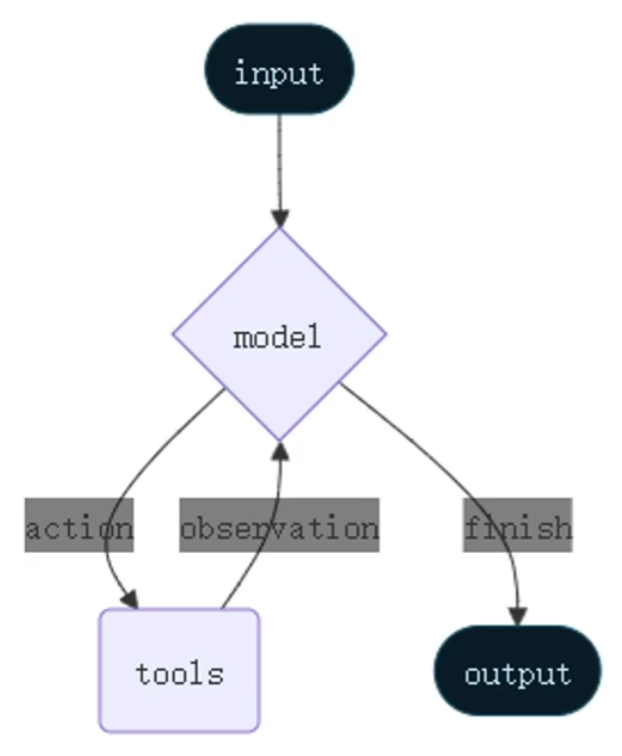
LangChain 的 Agent 对象遵循 ReAct 框架要求,在执行的过程中会持续的自我思考、自我行动、自我观察。 一个典型的 ReAct 案例如下:
@tool(description="获取体重,返回值是整数,单位千克")
def get_weight() -> int:
    return 90

@tool(description="获取身高,返回值是整数,单位厘米")
def get_height() -> int:
    return 172

agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    system_prompt="""你是严格遵循ReAct框架的智能体,必须按「思考→行动→观察→再思考」的流程解决问题,
且**每轮仅能思考并调用1个工具**,禁止单次调用多个工具。
并告知我你的思考过程,工具的调用原因,按思考、行动、观察三个结构告知我""",
    tools=[get_weight, get_height],
)

for chunk in agent.stream(
    {"messages": [{"role": "user", "content": "计算我的BMI"}]},
    stream_mode="values",
):
    latest_message = chunk["messages"][-1]
    if latest_message.content:
        print(latest_message.content.strip())
    try:
        if latest_message.tool_calls:
            print(f"Calling tools: {[tc['name'] for tc in latest_message.tool_calls]}")
    except AttributeError:
pass“每轮仅能思考并调用1个工具,禁止单次调用多个工具”只是为了方便展示,实际上 Langchain 是由并行调用工具的能力
middleware 中间件
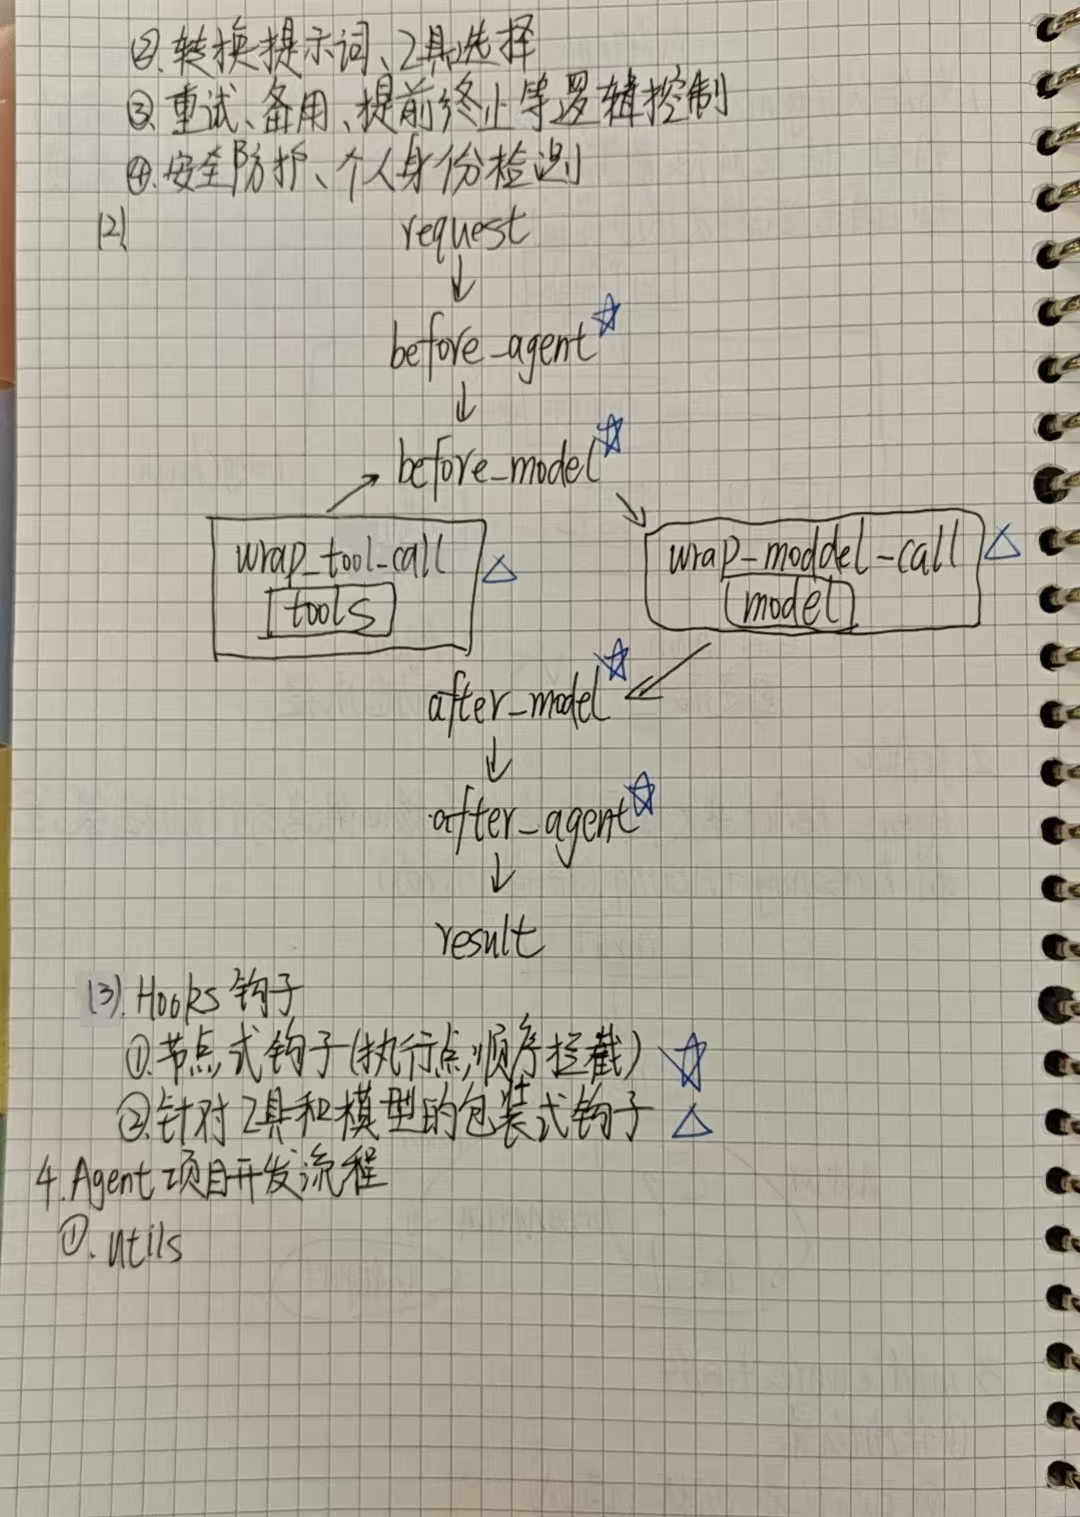
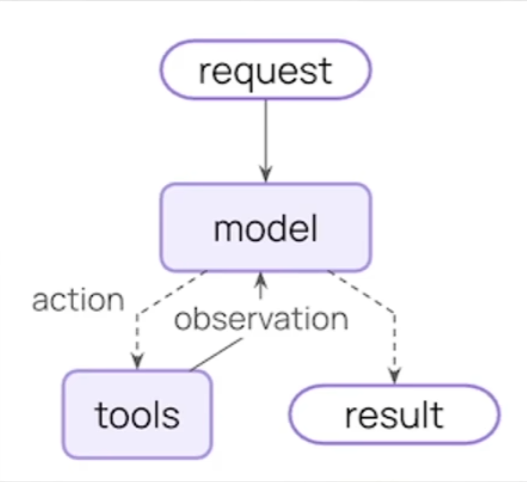
中间件的作用是对智能体的每一步工作进行控制和自定义的执行,其作用场景:
- 日志记录、分析、调试
- 转换提示词、工具选择
- 重试、备用、提前终止等逻辑控制
- 安全防护、个人身份检测等
无中间件:
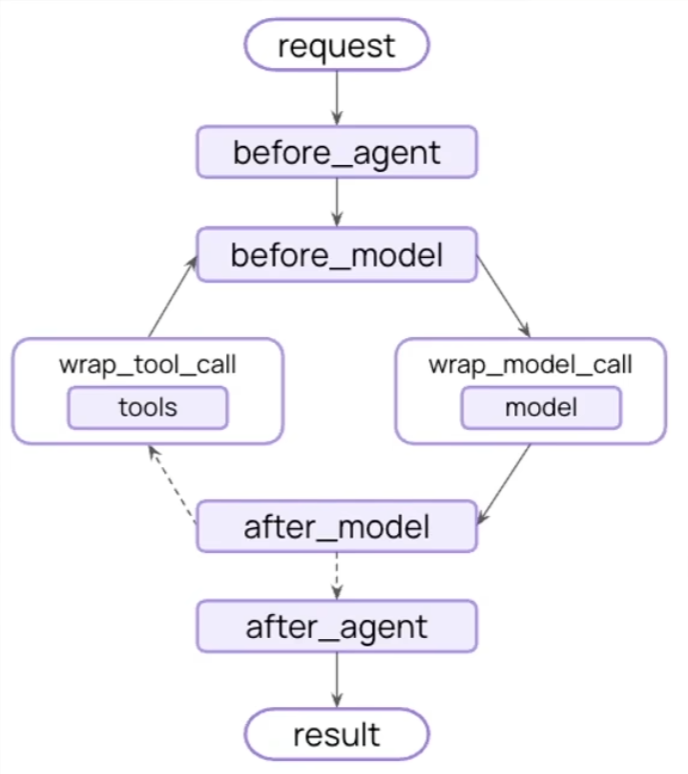
有中间件:
LangChain 中内置了一些基础的中间件,参见:
https://docs.langchain.com/oss/python/langchain/middleware/built‑in
中间件通过 Hooks 钩子来实现拦截,自定义中间件可以简单的使用装饰器来定义
节点式钩子(执行点顺序拦截):
- before_agent:agent 执行之前拦截
- after_agent:agent 执行后拦截
- before_model:模型执行前拦截
- after_model:模型执行后拦截
针对工具和模型的包装式钩子:
- wrap_model_call:每个模型调用时候拦截
- wrap_tool_call:每个工具调用时候拦截
from langchain.agents import create_agent, AgentState
from langchain.agents.middleware import before_agent, after_agent, before_model, after_model, wrap_model_call, wrap_tool_call
from langchain_community.chat_models.tongyi import ChatTongyi
from langchain_core.tools import tool
from langgraph.runtime import Runtime

@tool(description="查询天气,传入城市名称字符串,返回字符串天气信息")
def get_weather(city: str) -> str:
    return f"{city}天气:晴天"

@before_agent
def log_before_agent(state: AgentState, runtime: Runtime) -> None:
    # agent执行前会调用这个函数并传入state和runtime两个对象
    print(f"[before agent]agent启动,并附带{len(state['messages'])}消息")

@after_agent
def log_after_agent(state: AgentState, runtime: Runtime) -> None:
    print(f"[after agent]agent结束,并附带{len(state['messages'])}消息")

@before_model
def log_before_model(state: AgentState, runtime: Runtime) -> None:
    print(f"[before_model]模型即将调用,并附带{len(state['messages'])}消息")

@after_model
def log_after_model(state: AgentState, runtime: Runtime) -> None:
    print(f"[after_model]模型调用结束,并附带{len(state['messages'])}消息")

@wrap_model_call
def model_call_hook(request, handler):
    print("模型调用啦")

    return handler(request)

@wrap_tool_call
def monitor_tool(request, handler):
    print(f"工具执行:{request.tool_call['name']}")
    print(f"工具执行传入参数:{request.tool_call['args']}")

    return handler(request)

agent = create_agent(
    model=ChatTongyi(model="qwen3-max"),
    tools=[get_weather],
    middleware=[log_before_agent, log_after_agent, log_before_model, log_after_model, model_call_hook, monitor_tool]
)

res = agent.invoke({"messages": [{"role": "user", "content": "深圳今天的天气如何呀,如何穿衣"}]})

"""
[before agent]agent启动,并附带1消息
[before_model]模型即将调用,并附带1消息
模型调用啦
[after_model]模型调用结束,并附带2消息
工具执行:get_weather
工具执行传入参数:{'city': '深圳'}
[before_model]模型即将调用,并附带3消息
模型调用啦
[after_model]模型调用结束,并附带4消息
[after agent]agent结束,并附带4消息
"""
手写笔记