§ Essay
MySQL 数据库入门到精通
讲解 MySQL 基础(SQL 语法、约束、多表查询、事务、视图存储过程触发器),MySQL 进阶(存储引擎、B+Tree 索引、SQL 优化、锁机制),MySQL 运维(日志体系、备份恢复、主从复制、故障排查)
MySQL 是业界广泛使用的开源关系型数据库。本文从最基础的 MySQL 环境安装写起,逐步讲解 MySQL 高级与运维内容,带你彻底掌握 MySQL
一、MySQL 简介
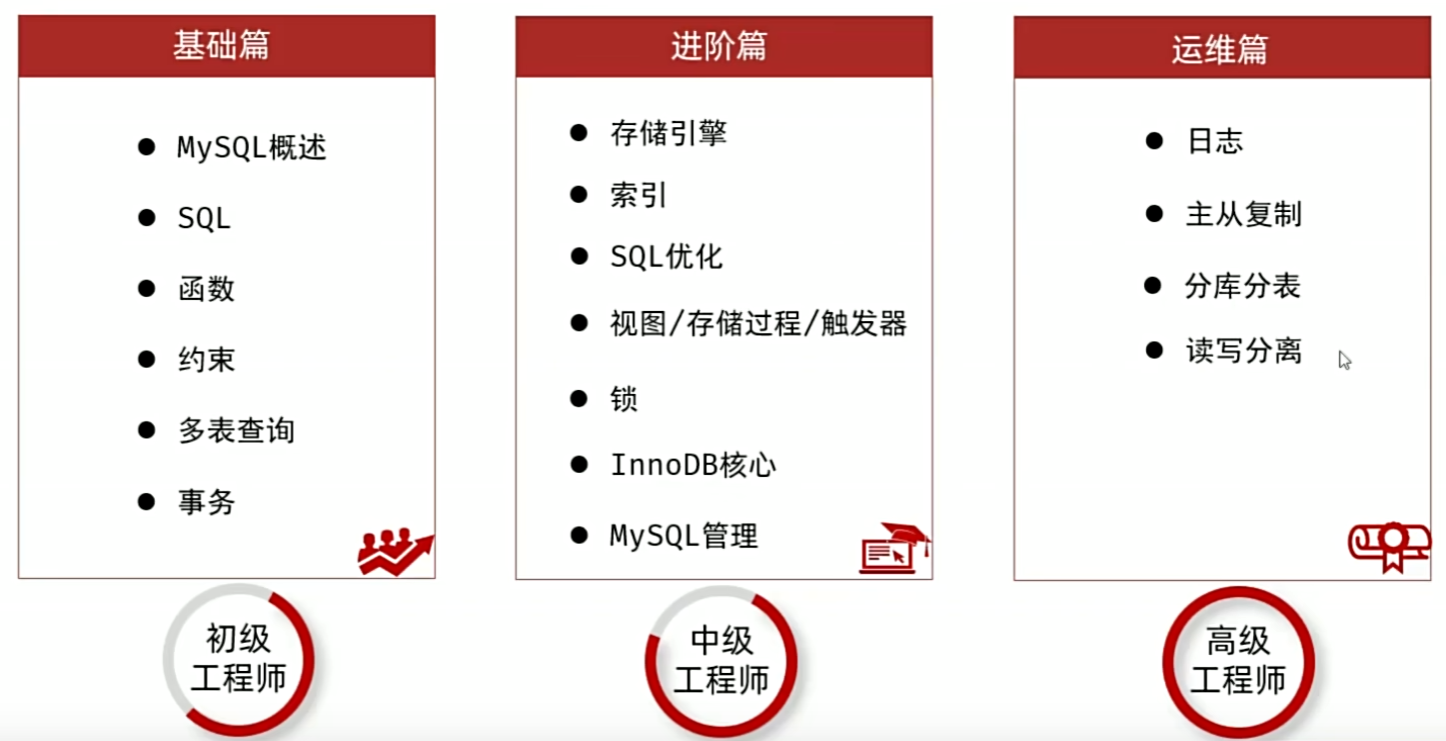
1、MySQL 入门到精通需要学习哪些内容?
2、数据库相关概念
| 名称 | 全称 | 简称 |
|---|---|---|
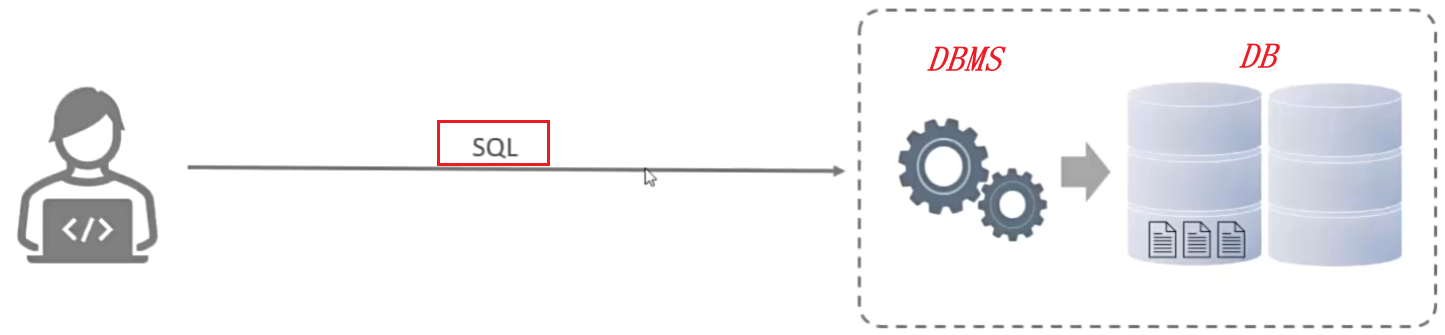
| 数据库 | 存储数据的仓库,数据是有组织的进行存储 | DataBase(DB) |
| 数据库管理系统 | 操纵和管理数据库的大型软件 | DataBase Management System(DBMS) |
| SQL | 操作关系型数据库的编程语言,定义了一套操作关系型数据库统一标准 | Structured Query Language(SQL) |
主流的关系型数据库管理系统
| Rank | DBMS | Database Model | Score |
|---|---|---|---|
| 1 | Oracle | Relational, Multi-model | 1266.89 |
| 2 | MySQL | Relational, Multi-model | 1206.05 |
| 3 | Microsoft SQL Server | Relational, Multi-model | 944.81 |
| 4 | PostgreSQL | Relational, Multi-model | 606.56 |
| 5 | IBM Db2 | Relational, Multi-model | 164.20 |
| 6 | Microsoft Access | Relational | 128.95 |
| 7 | SQLite | Relational | 127.43 |
| 8 | MariaDB | Relational, Multi-model | 106.42 |
| 9 | Microsoft Azure SQL Database | Relational, Multi-model | 86.32 |
| 10 | Hive | Relational | 83.45 |
不管是哪个 DBMS,都是通过统一标准的 sql 语言操作
3、MySQL 下载与启动
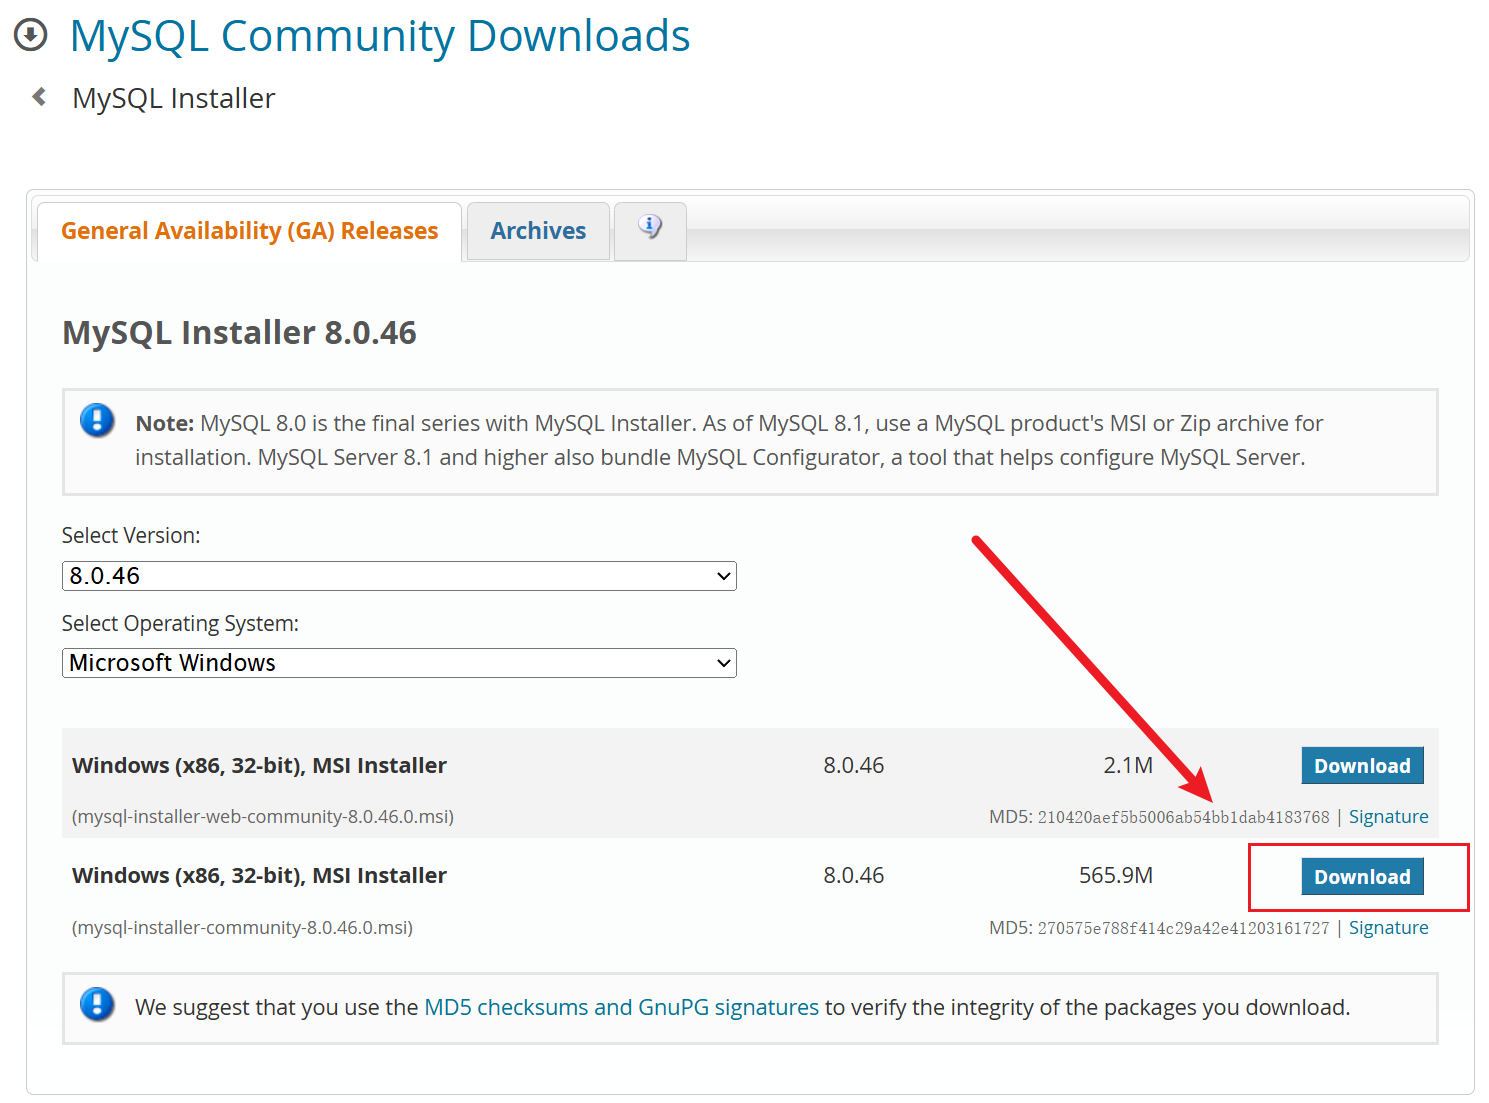
(1)MySQL 下载
MySQL : Download MySQL Installer
(2)MySQL 启动与停止
1)win + R 输入 services.msc
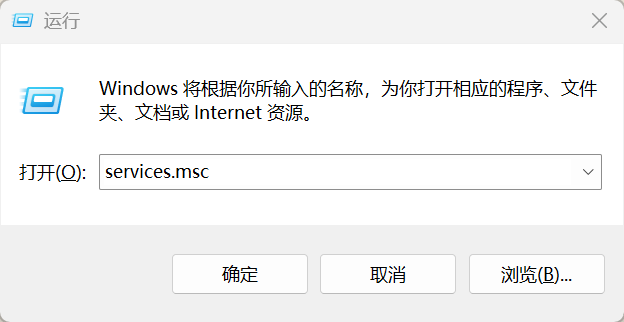
回车,找到 MySQL 相关服务,启动即可
1)命令行输入指令
启动
net start mysql80停止
net stop mysql80(3)客户端连接
1)方式一
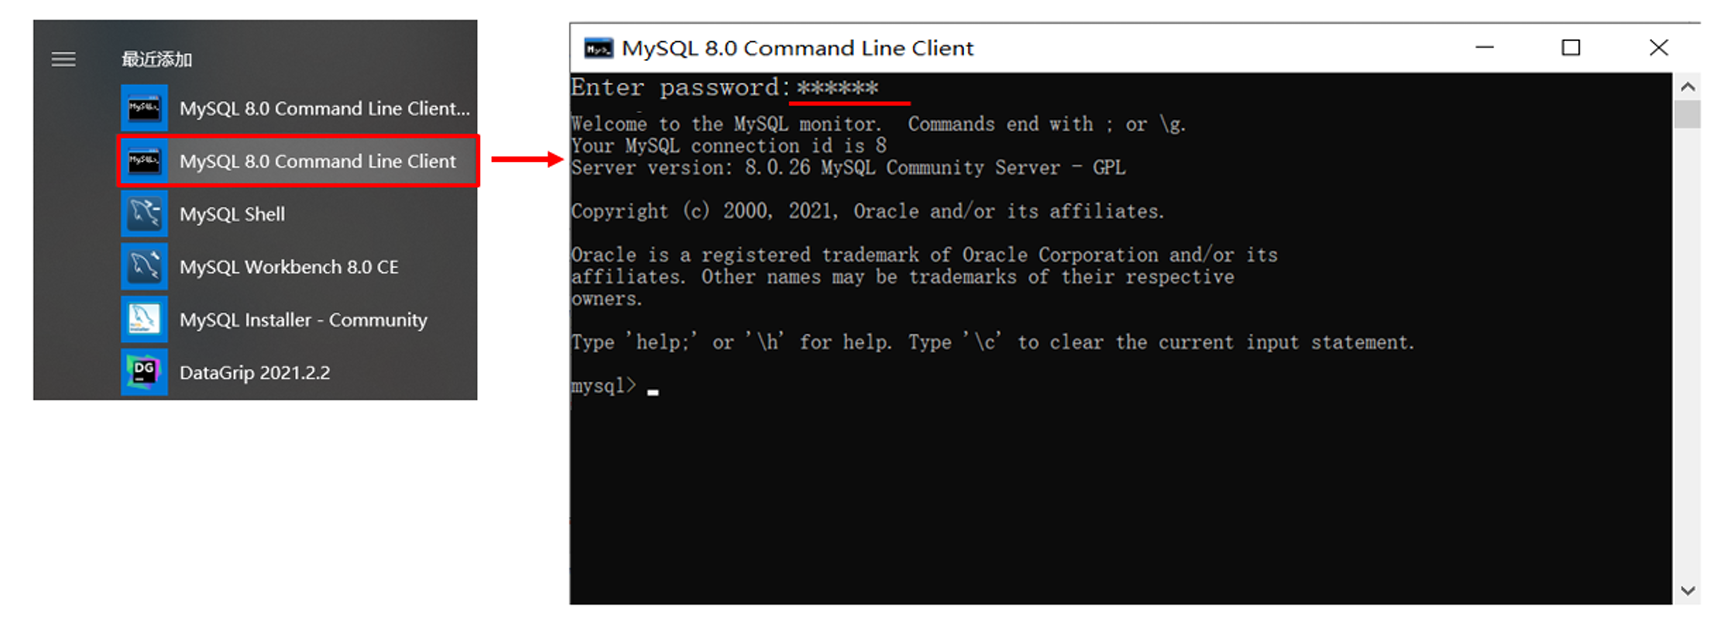
使用 MySQL 提供的客户端命令行工具
在开始菜单找到 MySQL 8.0 Command Line Client,点击进入,输入密码
2)方式二
使用系统自带的命令行工具执行指令
mysql [-h 127.0.0.1] [-P 3306] -u root -p[] 内为可选参数,如果需要连接远程的 MySQL,需要加上这两个参数来指定远程主机 IP、端口,如果连接本地的 MySQL,则无需指定这两个参数
| 参数 | 说明 |
|---|---|
-h | MySQL 服务所在的主机 IP |
-P | MySQL 服务端口号,默认 3306 |
-u | MySQL 数据库用户名 |
-p | MySQL 数据库用户名对应的密码 |
注意:
使用这种方式进行连接时,需要安装完毕后配置 PATH 环境变量
4、数据模型
(1)关系型数据库(RDBMS)
概念:建立在关系模型基础上,由多张相互连接的二维表组成的数据库
二维表,指的是由行和列组成的表,如下图(类似于 Excel 表格数据,有表头、有列、有行, 还可以通过一列关联另外一个表格中的某一列数据)
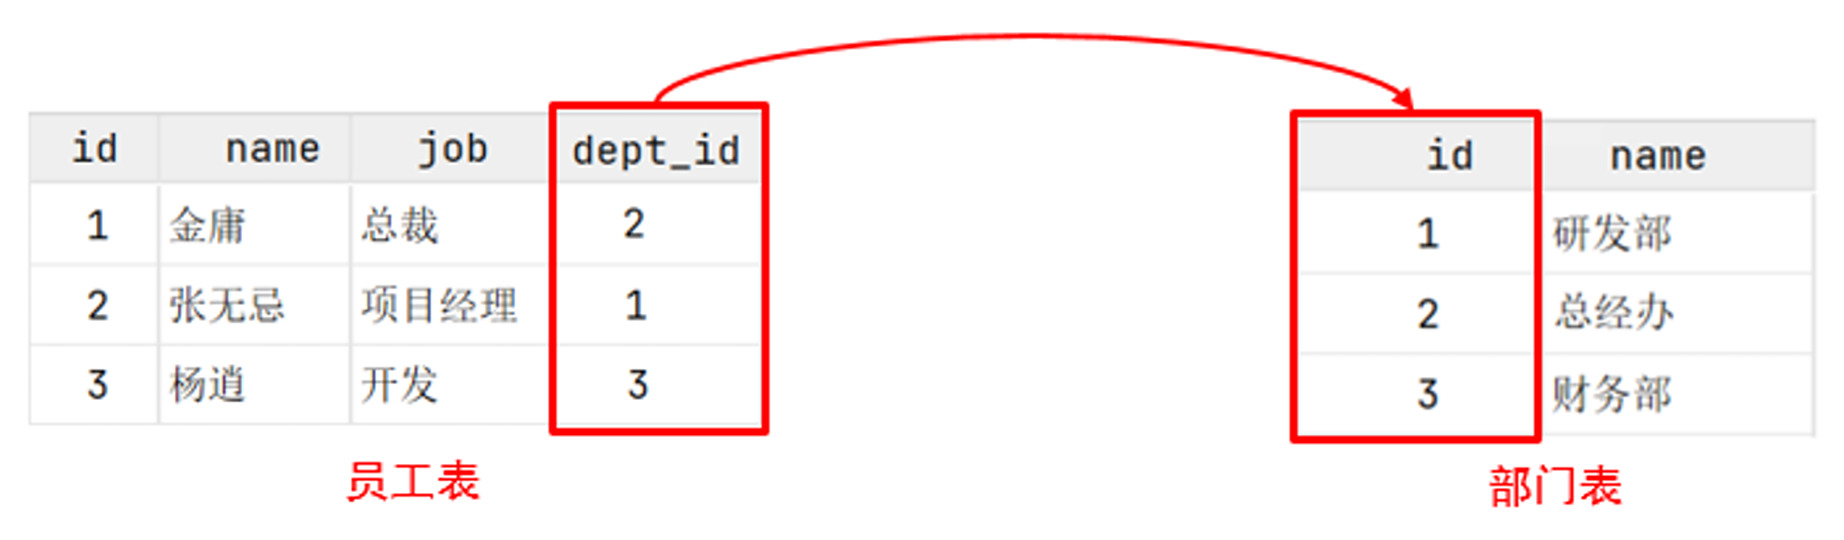
我们之前提到的 MySQL、Oracle、DB2、 SQLServer 这些都是属于关系型数据库,里面都是基于二维表存储数据的。简单说,基于二维表存储 数据的数据库就成为关系型数据库,不是基于二维表存储数据的数据库,就是非关系型数据库
特点:
- 使用表存储数据,格式统一,便于维护
- 使用SQL语言操作,标准统一,使用方便
(2)数据模型
MySQL是关系型数据库,是基于二维表进行数据存储的的,具体的结构图下:
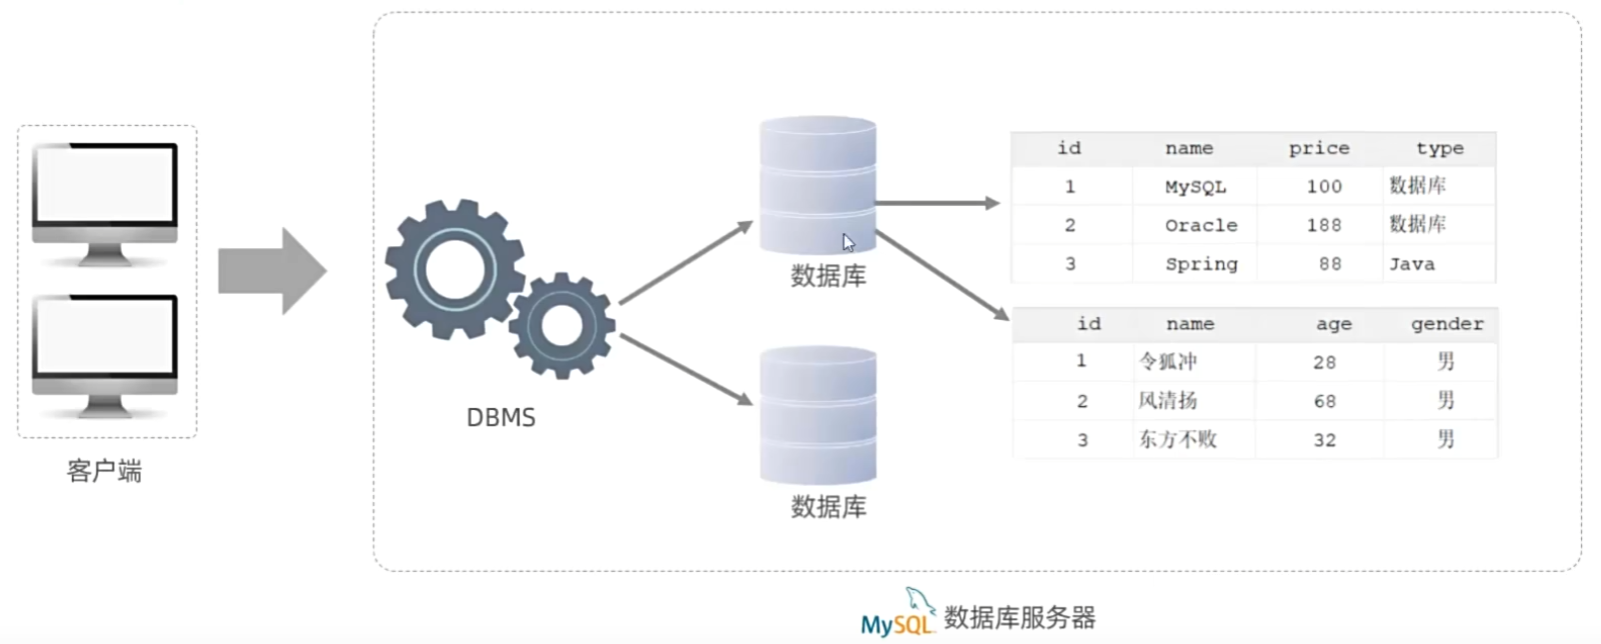
- 我们可以通过 MySQL 客户端连接数据库管理系统 DBMS,然后通过 DBMS 操作数据库
- 可以使用 SQL 语句,通过数据库管理系统操作数据库,以及操作数据库中的表结构及数据
- 一个数据库服务器中可以创建多个数据库,一个数据库中也可以包含多张表,而一张表中又可以包含多行记录
二、MySQL 基础之 —— SQL
1、通用语法及分类
(1)通用语法
-
SQL 语句可以单行或多行书写,以分号结尾
-
SQL 语句可以使用空格 / 缩进来增强语句的可读性
-
MySQL 数据库的 SQL 语句不区分大小写,关键字建议使用大写
-
注释:
单行注释: — 注释内容 或 # 注释内容
多行注释:/* 注释内容 */
(2)分类
SQL 语句,根据其功能,主要分为四类:DDL、DML、DQL、DCL
| 分类 | 全称 | 说明 |
|---|---|---|
| DDL | Data Definition Language | 数据定义语言,用来定义数据库对象 (数据库,表,字段) |
| DML | Data Manipulation Language | 数据操作语言,用来对数据库表中的数据进行增、删、改 |
| DQL | Data Query Language | 数据查询语言,用来查询数据库中表的记录 |
| DCL | Data Control Language | 数据控制语言,用来创建数据库用户、控制数据库的访问权限 |
2、MySQL 中的数据类型
MySQL中的数据类型有很多,主要分为三类:数值类型、字符串类型、日期时间类型
(1)数值类型
| 类型 | 大小 | 有符号 (SIGNED) 范围 | 无符号 (UNSIGNED) 范围 | 描述 |
|---|---|---|---|---|
| TINYINT | 1byte | (-128, 127) | (0, 255) | 小整数值 |
| SMALLINT | 2 bytes | (-32768, 32767) | (0, 65535) | 大整数值 |
| MEDIUMINT | 3 bytes | (-8388608, 8388607) | (0, 16777215) | 大整数值 |
| INT/INTEGER | 4 bytes | (-2147483648, 2147483647) | (0, 4294967295) | 大整数值 |
| BIGINT | 8 bytes | (-2^63, 2^63-1) | (0, 2^64-1) | 极大整数值 |
| FLOAT | 4 bytes | (-3.402823466 E+38, 3.402823466351 E+38) | 0 和 (1.175494351 E-38, 3.402823466 E+38) | 单精度浮点数值 |
| DOUBLE | 8 bytes | (-1.7976931348623157 E+308, 1.7976931348623157 E+308) | 0 和 (2.2250738585072014 E-308, 1.7976931348623157 E+308) | 双精度浮点数值 |
| DECIMAL | 依赖于 M (精度) 和 D (标度) 的值 | 依赖于 M (精度) 和 D (标度) 的值 | 小数值 (精确定点数) |
其中 M (精度) 表示整个长度,D (标度) 表示小数位数
例子:
age tinyint unsigend comment '年龄'score double(4,1)总分100分, 最多出现一位小数
# 总分 100 分, 最多出现一位小数(2)字符串类型
| 类型 | 大小 | 描述 |
|---|---|---|
| CHAR | 0-255 bytes | 定长字符串 (需要指定长度) |
| VARCHAR | 0-65535 bytes | 变长字符串 (需要指定长度) |
| TINYBLOB | 0-255 bytes | 不超过 255 个字符的二进制数据 |
| TINYTEXT | 0-255 bytes | 短文本字符串 |
| BLOB | 0-65535 bytes | 二进制形式的长文本数据 |
| TEXT | 0-65535 bytes | 长文本数据 |
| MEDIUMBLOB | 0-16 777 215 bytes | 二进制形式的中等长度文本数据 |
| MEDIUMTEXT | 0-16 777 215 bytes | 中等长度文本数据 |
| LONGBLOB | 0-4 294 967 295 bytes | 二进制形式的极大文本数据 |
| LONGTEXT | 0-4 294 967 295 bytes | 极大文本数据 |
二进制形式的数据,如音频、视频、软件安装包等,我们一般不存在数据库中(性能并不高,且不方便管理),一般用专门的文件服务器存储
char 与 varchar 都可以描述字符串,char 是定长字符串,指定长度多长,就占用多少个字符,和字段值的长度无关 。而 varchar 是变长字符串,指定的长度为最大占用长度 。相对来说,char 的性能会更高些
- char:性能好
- varchar:性能较差,因为会根据内容计算需要占用的空间
如:
1)用户名 username ------> 长度不定,最长不会超过50
    username varchar(50)

2)性别 gender ---------> 存储值,不是男,就是女
    gender char(1)

3)手机号 phone --------> 固定长度为11
    phone char(11)
(3)日期时间类型
| 类型 | 大小 | 范围 | 格式 | 描述 |
|---|---|---|---|---|
| DATE | 3 | 1000-01-01 至 9999-12-31 | YYYY-MM-DD | 日期值 |
| TIME | 3 | -838:59:59 至 838:59:59 | HH:MM:SS | 时间值或持续时间 |
| YEAR | 1 | 1901 至 2155 | YYYY | 年份值 |
| DATETIME | 8 | 1000-01-01 00:00:00 至 9999-12-31 23:59:59 | YYYY-MM-DD HH:MM:SS | 混合日期和时间值 |
| TIMESTAMP | 4 | 1970-01-01 00:00:01 至 2038-01-19 03:14:07 | YYYY-MM-DD HH:MM:SS | 混合日期和时间值,时间戳 |
3、图形化界面工具 DataGrip
在命令进行操作,主要存在以下两点问题:
- 会影响开发效率
- 使用起来,并不直观,并不方便
所以在日常的开发中,我们会借助于 MySQL 的图形化界面,来简化开发,提高开发效率
目前 mysql主流的图形化界面工具,有以下几种:
我们选择最后一种 DataGrip,这种图形化界面工具功能更加强大,界面提示更加友好, 是我们使用 MySQL 的不二之选
4、DDL
(1)DDL —— 数据库操作
1)查询数据库
查询所有数据库
show databases;查询当前数据库
select database();2)创建数据库
create database [ if not exists ] 数据库名 [ default charset 字符集 ] [ collate 排序规则 ];在同一个数据库服务器中,不能创建两个名称相同的数据库,否则将会报错
可以通过 if not exists 参数来解决这个问题,数据库不存在,则创建该数据库,如果存在,则不创建:
create database if not exists 数据库名;创建一个数据库,并且指定字符集:
create database 数据库名 default charset utf8mb4;MySQL 数据库中不建议设置 utf8,因为 utf8 只占三个字节,一些特殊字符占四个字节,所以推荐用 utf8mb4,支持四个字节
3)删除数据库
drop database 数据库名;如果删除一个不存在的数据库,将会报错。此时,可以加上参数 if exists,如果数据库存在,再执行删除,否则不执行删除
drop database [ if exists ] 数据库名;4)切换数据库
我们要操作某一个数据库下的表时,就需要通过该指令,切换到对应的数据库下,否则是不能操作的
use 数据库名;(2)DDL —— 表操作
1) 表操作 — 查询
查询当前数据库所有表
show tables;比如,我们可以切换到 sys 这个系统数据库,并查看系统数据库中的所有表结构:
use sys;
show tables;
查看指定表结构
desc 表名;通过这条指令,我们可以查看到指定表的字段,字段的类型、是否可以为NULL,是否存在默认值等信息
查询指定表的建表语句
show create table 表名;通过这条指令,主要是用来查看建表语句的,而有部分参数我们在创建表的时候,并未指定也会查询到,因为这部分是数据库的默认值,如:存储引擎、字符集等
2) 表操作 — 创建
# 创建表结构
CREATE TABLE 表名(
    字段1 字段1类型 [COMMENT 字段1注释 ],
    字段2 字段2类型 [COMMENT 字段2注释 ],
    字段3 字段3类型 [COMMENT 字段3注释 ],
    ......
    字段n 字段n类型 [COMMENT 字段n注释 ]
) [ COMMENT 表注释 ] ;
注意:[…] 内为可选参数,最后一个字段后面没有逗号
比如,我们创建一张表 tb_user,对应的结构如下,那么建表语句为:
| id | name | age | gender |
|---|---|---|---|
| 1 | 令狐冲 | 28 | 男 |
| 2 | 风清扬 | 68 | 男 |
| 3 | 东方不败 | 32 | 男 |
create table emp(
    id int comment '编号',
    name varchar(10) comment '姓名',
    age tinyint unsigned comment '年龄',
    gender varchar(1) comment '性别',
    entrydate date comment '入职时间'
) comment '员工表';
3) 表操作 — 修改
-
添加字段
ALTER TABLE 表名 ADD 字段名 类型(长度) [ COMMENT 注释 ] [ 约束 ]; -
修改数据类型
ALTER TABLE 表名 MODIFY 字段名 新数据类型(长度); -
修改字段名和数据类型
ALTER TABLE 表名 CHANGE 旧字段名 新字段名 类型(长度) [ COMMENT 注释 ] [ 约束 ];例子:将 emp 表的 nickname 字段修改为 username,类型为 varchar (30)
ALTER TABLE emp CHANGE nickname username varchar(30) COMMENT '昵称'; -
删除字段
ALTER TABLE 表名 DROP 字段名; -
修改表名
ALTER TABLE 表名 RENAME TO 新表名;
4)表操作 — 删除
-
删除表
DROP TABLE [ IF EXISTS ] 表名; -
删除指定表,并重新创建表
TRUNCATE TABLE 表名;注意:在删除表的时候,表中的全部数据都会被删除
(3)总结
-
DDL - 数据库操作
SHOW DATABASES; CREATE DATABASE 数据库名; USE 数据库名; SELECT DATABASE(); DROP DATABASE 数据库名; -
DDL - 表操作
SHOW TABLES;
CREATE TABLE 表名(字段 字段类型, 字段 字段类型);
DESC 表名;
SHOW CREATE TABLE 表名;
ALTER TABLE 表名 ADD/MODIFY/CHANGE/DROP/RENAME TO ...;
DROP TABLE 表名;
5、DML
DML 英文全称是 Data Manipulation Language (数据操作语言),用来对数据库中表的数据记录进行增、删、改操作
- 添加数据(INSERT)
- 修改数据(UPDATE)
- 删除数据(DELETE)
(1)添加数据
1) 给指定字段添加数据
INSERT INTO 表名(字段名1, 字段名2, ...) VALUES(值1, 值2, ...);插入数据完成之后,查询数据库的数据:
select * from 表名;2)给全部字段添加数据
INSERT INTO 表名 VALUES (值1, 值2, ...);3)批量添加数据
INSERT INTO 表名 (字段名1, 字段名2, ...) VALUES (值1, 值2, ...), (值1, 值2, ...), (值1, 值2, ...);
INSERT INTO 表名 VALUES (值1, 值2, ...), (值1, 值2, ...), (值1, 值2, ...);
注意事项:
- 插入数据时,指定的字段顺序需要与值的顺序是一一对应的
- 字符串和日期型数据应该包含在引号中
- 插入的数据大小,应该在字段的规定范围内
(2)修改数据
UPDATE 表名 SET 字段名1 = 值1 , 字段名2 = 值2 , .... [ WHERE 条件 ] ;注意事项:
修改语句的条件可以有,也可以没有,如果没有条件,则会修改整张表的所有数据
(3)删除数据
DELETE FROM 表名 [ WHERE 条件 ];注意事项:
- DELETE 语句的条件可以有,也可以没有,如果没有条件,则会删除整张表的所有数据
- DELETE 语句不能删除某一个字段的值(可以使用 UPDATE,将该字段值置为 NULL 即可)
- 当进行删除全部数据操作时,datagrip 会提示我们,询问是否确认删除,我们直接点击 Execute 即可
6、DQL
DQL 英文全称是 Data Query Language(数据查询语言),数据查询语言,用来查询数据库中表的记录
查询关键字:SELECT
在一个正常的业务系统中,查询操作的频次是要远高于增删改的,在查询的过程中,可能还会涉及到条件、排序、分页等操作
(1)基本语法
SELECT
    字段列表
FROM
    表名列表
WHERE
    条件列表
GROUP BY
    分组字段列表
HAVING
    分组后条件列表
ORDER BY
    排序字段列表
LIMIT
    分页参数
将上面的完整语法进行拆分,分为以下几个部分:
- 基本查询(不带任何条件)
- 条件查询(WHERE)
- 聚合函数(count、max、min、avg、sum)
- 分组查询(group by)
- 排序查询(order by)
- 分页查询(limit)
(2)基础查询(不带任何查询条件)
1)查询多个字段
SELECT 字段1, 字段2, 字段3 ... FROM 表名 ;
SELECT * FROM 表名 ;
注意:* 号代表查询所有字段,在实际开发中尽量少用(不直观、影响效率)
2)字段设置别名
SELECT 字段1 [ AS 别名1 ] , 字段2 [ AS 别名2 ] ... FROM 表名;
SELECT 字段1 [ 别名1 ] , 字段2 [ 别名2 ] ... FROM 表名;
3)去除重复记录
SELECT DISTINCT 字段列表 FROM 表名;案例:
A. 查询指定字段 name,workno,age 并返回
select name,workno,age from emp;B. 查询返回所有字段
select id ,workno,name,gender,age,idcard,workaddress,entrydate from emp;
select * from emp;
C. 查询所有员工的工作地址,起别名
select workaddress as '工作地址' from emp;
-- as 可以省略
select workaddress '工作地址' from emp;
D. 查询公司员工的上班地址有哪些(不要重复)
select distinct workaddress '工作地址' from emp;(3)条件查询
1)语法
SELECT 字段列表 FROM 表名 WHERE 条件列表 ;2)条件
常用的比较运算符:
| 比较运算符 | 功能 |
|---|---|
| > | 大于 |
| >= | 大于等于 |
| < | 小于 |
| <= | 小于等于 |
| = | 等于 |
| <> 或 != | 不等于 |
| BETWEEN … AND … | 在某个范围之内(含最小、最大值) |
| IN(…) | 在in之后的列表中的值,多选一 |
| LIKE 占位符 | 模糊匹配(_匹配单个字符,%匹配任意个字符) |
| IS NULL | 是NULL |
常用的逻辑运算符:
| 逻辑运算符 | 功能 |
|---|---|
| AND 或 && | 并且(多个条件同时成立) |
| OR 或 || | 或者(多个条件任意一个成立) |
| NOT 或 ! | 非,不是 |
案例:
-- A. 查询年龄等于 88 的员工
select * from emp where age = 88;

-- B. 查询年龄小于 20 的员工信息
select * from emp where age < 20;

-- C. 查询年龄小于等于 20 的员工信息
select * from emp where age <= 20;

-- D. 查询没有身份证号的员工信息
select * from emp where idcard is null;

-- E. 查询有身份证号的员工信息
select * from emp where idcard is not null;

-- F. 查询年龄不等于 88 的员工信息
select * from emp where age != 88;
select * from emp where age <> 88;

-- G. 查询年龄在 15 岁(包含) 到 20 岁(包含)之间的员工信息
select * from emp where age >=15 && age <=20;
select * from emp where age >= 15 and age <= 20;
select * from emp where age between 15 and 20;

-- H. 查询性别为 女 且年龄小于 25 岁的员工信息
select * from emp where gender = '女' and age < 25;

-- I. 查询年龄等于 18 或 20 或 40 的员工信息
select * from emp where age = 18 or age = 20 or age =40;
select * from emp where age in(18,20,40);

-- J. 查询姓名为两个字的员工信息
select * from emp where name like '__';

-- K. 查询身份证号最后一位是 X 的员工信息
select * from emp where idcard like '%X';      # % : 前面是多少个字符都无所谓
select * from emp where idcard like '___________X';
(4)聚合函数
1)介绍
将一列数据作为一个整体,进行纵向计算
2)常见的聚合函数
| 函数 | 功能 |
|---|---|
| count | 统计数量 |
| max | 最大值 |
| min | 最小值 |
| avg | 平均值 |
| sum | 求和 |
3)语法
SELECT 聚合函数(字段列表) FROM 表名 ;注意:NULL 值是不参与所有聚合函数运算的
案例:
A. 统计该企业员工数量
select count(*) from emp;        -- 统计的是总记录数
select count(idcard) from emp;   -- 统计的是 idcard 字段不为 null 的记录数
对于 count 聚合函数,统计符合条件的总记录数,还可以通过 count(数字/字符串)的形式进行统计查询,比如:
select count(1) from emp;对于count(*)、count(字段)、count(1) 的具体原理,我们在进阶篇中 SQL 优化部分会详细讲解,此处大家只需要知道如何使用即可
B. 统计该企业员工的平均年龄
select avg(age) from emp;C. 统计该企业员工的最大年龄
select max(age) from emp;D. 统计该企业员工的最小年龄
select min(age) from emp;E. 统计西安地区员工的年龄之和
select sum(age) from emp where workaddress = '西安';(5)分组查询
1)语法
SELECT 字段列表 FROM 表名 [ WHERE 条件 ] GROUP BY 分组字段名 [ HAVING 分组后过滤条件 ];2)where 与 having 区别
-
执行时机不同
where 是分组之前进行过滤,不满足 where 条件,不参与分组;而 having 是分组之后对结果进行过滤
-
判断条件不同
where 不能对聚合函数进行判断,而 having 可以
注意事项:
- 分组之后,查询的字段一般为聚合函数和分组字段,查询其他字段无任何意义
- 执行顺序:where > 聚合函数 > having
- 支持多字段分组,具体语法为:group by columnA,columnB
案例:
A. 根据性别分组,统计男性员工和女性员工的数量
select gender, count(*) from emp group by gender ;B. 根据性别分组,统计男性员工 和 女性员工的平均年龄
select gender, avg(age) from emp group by gender ;C. 查询年龄小于 45 的员工,并根据工作地址分组,获取员工数量大于等于 3 的工作地址
select workaddress, count(*) address_count from emp where age < 45 group by workaddress having address_count >= 3;D. 统计各个工作地址上班的男性及女性员工的数量
select workaddress, gender, count(*) '数量' from emp group by gender , workaddress;(6)排序查询
排序在日常开发中是非常常见的一个操作,有升序排序,也有降序排序
1)语法
SELECT 字段列表 FROM 表名 ORDER BY 字段1 排序方式1 , 字段2 排序方式2 ;2)排序方式
- ASC:升序(默认值)
- DESC:降序
注意事项:
- 如果是升序,可以不指定排序方式 ASC
- 如果是多字段排序,当第一个字段值相同时,才会根据第二个字段进行排序
案例:
A. 根据年龄对公司的员工进行升序排序
select * from emp order by age asc;
select * from emp order by age;
B. 根据入职时间,对员工进行降序排序
select * from emp order by entrydate desc;C. 根据年龄对公司的员工进行升序排序,年龄相同,再按照入职时间进行降序排序
select * from emp order by age asc , entrydate desc;(7)分页查询
分页操作在业务系统开发时,也是非常常见的一个功能,我们在网站中看到的各种各样的分页条,后台都需要借助于数据库的分页操作
语法
SELECT 字段列表 FROM 表名 LIMIT 起始索引, 查询记录数 ;注意事项:
- 起始索引从 0 开始,起始索引 =(查询页码 - 1)* 每页显示记录数
- 分页查询是数据库的方言,不同的数据库有不同的实现,MySQL 中是 LIMIT
- 如果查询的是第一页数据,起始索引可以省略,直接简写为 limit 10
案例:
A. 查询第 1 页员工数据,每页展示 10 条记录
select * from emp limit 0,10;

select * from emp limit 10;
B. 查询第 2 页员工数据,每页展示 10 条记录 --------> (页码 - 1) * 页展示记录数
select * from emp limit 10,10;(8)DQL执行顺序
在讲解DQL语句的具体语法之前,我们已经讲解了DQL语句的完整语法,及编写顺序,接下来,我们要来说明的是DQL语句在执行时的执行顺序,也就是先执行哪一部分,后执行哪一部分
编写顺序
SELECT → FROM → WHERE → GROUP BY → HAVING → ORDER BY → LIMIT执行顺序
FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT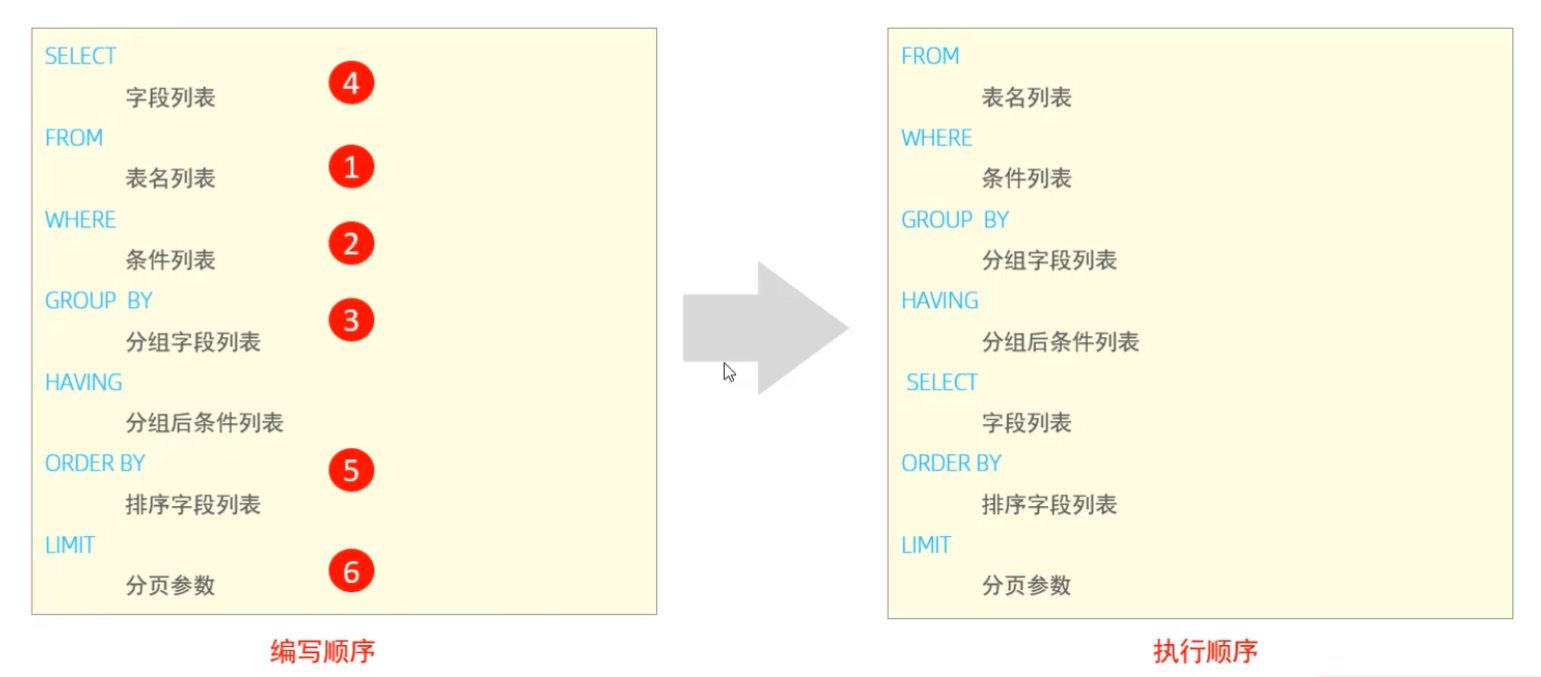
验证:
查询年龄大于15的员工姓名、年龄,并根据年龄进行升序排序
select name , age from emp where age > 15 order by age asc;在查询时,我们给 emp 表起一个别名 e,然后在 select 及 where 中使用该别名
select e.name , e.age from emp e where e.age > 15 order by age asc;执行上述 SQL 语句后,我们看到依然可以正常的查询到结果,此时就说明:from 先执行,然后 where 和 select 执行。那 where 和 select 到底哪个先执行呢?
此时,此时我们可以给 select 后面的字段起别名,然后在 where 中使用这个别名,然后看看是否可以执行成功
select e.name ename , e.age eage from emp e where eage > 15 order by age asc;执行上述 SQL 报错:
Unknown column 'eage' in 'where clause'由此我们可以得出结论:from 先执行,然后执行 where , 再执行 select
接下来,我们再执行如下 SQL 语句,查看执行效果:
select e.name ename , e.age eage from emp e where e.age > 15 order by eage asc;结果执行成功。那么也就验证了:order by 是在select 语句之后执行的
综上所述,我们可以看到 DQL 语句的执行顺序为: from → where → group by → having → select → order by → limit
7、DCL
DCL 英文全称是 Data Control Language(数据控制语言),用来管理数据库用户、控制数据库的访问权限
DCL 主要控制两个方面:
- 数据库有哪些用户可以访问
- 每个用户具有哪些访问权限
(1)DCL —— 管理用户
1)查询用户
select * from mysql.user;查询结果字段说明:
-
Host:代表当前用户访问的主机,如果为
localhost,仅代表只能够在当前本机访问,不可以远程访问 -
User:代表的是访问该数据库的用户名
在 MySQL 中需要通过 Host 和 User 来唯一标识一个用户
2)创建用户
CREATE USER '用户名'@'主机名' IDENTIFIED BY '密码';案例:
-- 创建用户 itcast ,只能够在当前主机localhost访问,密码123456;
create user 'itcast'@'localhost' identified by '123456';

-- 创建用户 heima ,可以在任意主机访问该数据库,密码123456 ;
create user 'heima'@'%' identified by '123456';

-- 修改用户 heima 的访问密码为 1234 ;
alter user 'heima'@'%' identified with mysql_native_password by '1234';

-- 删除itcast@localhost用户
drop user 'itcast'@'localhost';
3)修改用户密码
ALTER USER '用户名'@'主机名' IDENTIFIED WITH mysql_native_password BY '新密码';4)删除用户
DROP USER '用户名'@'主机名';注意事项:
- 在 MySQL 中需要通过
用户名@主机名的方式,来唯一标识一个用户- 主机名可以使用 % 通配
- 这类 SQL 开发人员操作的比较少,主要是DBA(Database Administrator 数据库管理员)使用
(2)权限控制
MySQL中定义了很多种权限,但是常用的就以下几种:
| 权限 | 说明 |
|---|---|
| ALL, ALL PRIVILEGES | 所有权限 |
| SELECT | 查询数据 |
| INSERT | 插入数据 |
| UPDATE | 修改数据 |
| DELETE | 删除数据 |
| ALTER | 修改表 |
| DROP | 删除数据库/表/视图 |
| CREATE | 创建数据库/表 |
上述只是简单罗列了常见的几种权限描述,其他权限描述及含义,可以直接参考官方文档
-- 1). 查询权限
SHOW GRANTS FOR '用户名'@'主机名';

-- 2). 授予权限
GRANT 权限列表 ON 数据库名.表名 TO '用户名'@'主机名';

-- 3). 撤销权限
REVOKE 权限列表 ON 数据库名.表名 FROM '用户名'@'主机名';
注意事项
- 多个权限之间,使用逗号分隔
- 授权时,数据库名和表名可以使用
*进行通配,代表所有
案例:
-- A. 查询 'harper'@'%' 用户的权限
show grants for 'harper'@'%';

-- B. 授予 'harper'@'%' 用户 itcast 数据库所有表的所有操作权限
grant all on itcast.* to 'harper'@'%';

-- C. 撤销 'harper'@'%' 用户的itcast数据库的所有权限
revoke all on itcast.* from 'harper'@'%';
三、MySQL 基础之 —— 函数
函数是指一段可以直接被另一段程序调用的程序或代码。也就意味着,这一段程序或代码在 MySQL 中已经给我们提供了,我们要做的就是在合适的业务场景调用对应的函数完成对应的业务需求即可
MySQL 中的函数主要分为以下四类:
- 字符串函数
- 数值函数
- 日期函数
- 流程函数
1、字符串函数
MySQL中内置了很多字符串函数,常用的几个如下:
| 函数 | 功能 |
|---|---|
| CONCAT(s1,s2,…Sn) | 字符串拼接,将 s1,s2,… Sn 拼接成一个字符串 |
| LOWER(str) | 将字符串 str 全部转为小写 |
| UPPER(str) | 将字符串 str 全部转为大写 |
| LPAD(str,n,pad) | 左填充,用字符串 pad 对 str 的左边进行填充,达到 n 个字符串长度 |
| RPAD(str,n,pad) | 右填充,用字符串 pad 对 str 的右边进行填充,达到 n 个字符串长度 |
| TRIM(str) | 去掉字符串头部和尾部的空格 |
| SUBSTRING(str,start,len) | 返回从字符串 str 从 start 位置起的 len 个长度的字符串 |
案例 1:
-- A. concat:字符串拼接
select concat('Hello', ' MySQL');

-- B. lower:全部转小写
select lower('Hello');

-- C. upper:全部转大写
select upper('Hello');

-- D. lpad:左填充
select lpad('01', 5, '-');

-- E. rpad:右填充
select rpad('01', 5, '-');

-- F. trim:去除空格
select trim(' Hello MySQL ');

-- G. substring:截取子字符串
select substring('Hello MySQL',1,5);
案例 2:
由于业务需求变更,企业员工的工号,统一为 5 位数,目前不足 5 位数的全部在前面补 0
update emp set workno = lpad(workno, 5, '0');2、数值函数
常见的数值函数如下:
| 函数 | 功能 |
|---|---|
| CEIL(x) | 向上取整 |
| FLOOR(x) | 向下取整 |
| MOD(x,y) | 返回 x / y 的模 |
| RAND() | 返回 0~1内的随机数 |
| ROUND(x,y) | 求参数 x 的四舍五入的值,保留 y 位小数 |
案例 1:
-- A. ceil:向上取整
select ceil(1.1);

-- B. floor:向下取整
select floor(1.9);

-- C. mod:取模
select mod(7,4);

-- D. rand:获取随机数
select rand();

-- E. round:四舍五入
select round(2.344,2);
案例 2:
通过数据库的函数,生成一个六位数的随机验证码
思路:获取随机数可以通过 rand() 函数,但是获取出来的随机数是在 0~1 之间的,所以可以在其基础上乘以1000000,然后舍弃小数部分,如果长度不足 6 位,补 0
select lpad(round(rand()*1000000 , 0), 6, '0');3、日期函数
常见的日期函数如下:
| 函数 | 功能 |
|---|---|
| CURDATE() | 返回当前日期 |
| CURTIME() | 返回当前时间 |
| NOW() | 返回当前日期和时间 |
| YEAR(date) | 获取指定 date 的年份 |
| MONTH(date) | 获取指定 date 的月份 |
| DAY(date) | 获取指定 date 的日期 |
| DATE_ADD(date, INTERVAL expr type) | 返回一个日期/时间值加上一个时间间隔 expr 后的时间值 |
| DATEDIFF(date1,date2) | 返回起始时间 date1 和 结束时间 date2 之间的天数 |
案例 1:
-- A. curdate: 当前日期
select curdate();

-- B. curtime: 当前时间
select curtime();

-- C. now: 当前日期和时间
select now();

-- D. YEAR , MONTH , DAY:当前年、月、日
select YEAR(now());
select MONTH(now());
select DAY(now());

-- E. date_add: 增加指定的时间间隔
select date_add(now(), INTERVAL 70 YEAR );

-- F. datediff: 获取两个日期相差的天数
select datediff('2021-10-01', '2021-12-01');
案例 2:
查询所有员工的入职天数,并根据入职天数倒序排序
思路:入职天数,就是通过当前日期 - 入职日期,所以需要使用 datediff 函数来完成
select name, datediff(curdate(), entrydate) as 'entrydays' from emp order by entrydays desc;4、流程函数
流程函数也是很常用的一类函数,可以在 SQL 语句中实现条件筛选,从而提高语句的效率
| 函数 | 功能 |
|---|---|
| IF(value , t , f) | 如果 value 为 true,则返回 t,否则返回 f |
| IFNULL(value1 , value2) | 如果 value1 不为空,返回 value1,否则返回 value2 |
| CASE WHEN [ val1 ] THEN [res1] … ELSE [ default ] END | 如果 val1 为 true,返回 res1,… 否则返回 default 默认值 |
| CASE [ expr ] WHEN [ val1 ] THEN [res1] … ELSE [ default ] END | 如果 expr 的值等于 val1,返回 res1,… 否则返回 default 默认值 |
案例 1:
-- A. if
select if(false, 'Ok', 'Error');

-- B. ifnull
select ifnull('Ok','Default');
select ifnull('','Default');
select ifnull(null,'Default');

-- C. case when then else end
-- 需求:查询 emp 表的员工姓名和工作地址(北京/上海 ----> 一线城市,其他 ----> 二线城市)
select
    name,
    case workaddress when '北京' then '一线城市' when '上海' then '一线城市' else '二线城市' end as '工作地址'
from emp;
案例 2:
create table score(
    id int comment 'ID',
    name varchar(20) comment '姓名',
    math int comment '数学',
    english int comment '英语',
    chinese int comment '语文'
) comment '学员成绩表';

insert into score(id, name, math, english, chinese) VALUES (1, 'Tom', 67, 88, 95 ), (2, 'Rose' , 23, 66, 90),(3, 'Jack', 56, 98, 76);
select
id,
name,
(case when math >= 85 then '优秀' when math >=60 then '及格' else '不及格' end ) '数学',
(case when english >= 85 then '优秀' when english >=60 then '及格' else '不及格' end ) '英语',
(case when chinese >= 85 then '优秀' when chinese >=60 then '及格' else '不及格' end ) '语文'
from score;四、MySQL 基础之 —— 约束
1、约束概述
约束是作用于表中字段上的规则,用于限制存储在表中的数据
目的:保证数据库中数据的正确、有效性和完整性
| 约束 | 描述 | 关键字 |
|---|---|---|
| 非空约束 | 限制该字段的数据不能为 null | NOT NULL |
| 唯一约束 | 保证该字段的所有数据都是唯一、不重复的 | UNIQUE |
| 主键约束 | 主键是一行数据的唯一标识,要求非空且唯一 | PRIMARY KEY |
| 默认约束 | 保存数据时,如果未指定该字段的值,则采用默认值 | DEFAULT |
| 检查约束(8.0.16版本之后) | 保证字段值满足某一个条件 | CHECK |
| 外键约束 | 用来让两张表的数据之间建立连接,保证数据的一致性和完整性 | FOREIGN KEY |
注意:约束是作用于表中字段上的,可以在创建表 / 修改表的时候添加约束
2、约束案例
案例需求:根据需求,完成表结构的创建
| 字段名 | 字段含义 | 字段类型 | 约束条件 | 约束关键字 |
|---|---|---|---|---|
| id | ID 唯一标识 | int | 主键,并且自动增长 | PRIMARY KEY, AUTO_INCREMENT |
| name | 姓名 | varchar(10) | 不为空,并且唯一 | NOT NULL , UNIQUE |
| age | 年龄 | int | 大于 0,并且小于等于 120 | CHECK |
| status | 状态 | char(1) | 如果没有指定该值,默认为 1 | DEFAULT |
| gender | 性别 | char(1) | 无 |
对应的建表语句:
CREATE TABLE tb_user(
    id int AUTO_INCREMENT PRIMARY KEY COMMENT 'ID 唯一标识',
    name varchar(10) NOT NULL UNIQUE COMMENT '姓名',
    age int check (age > 0 && age <= 120) COMMENT '年龄',
    status char(1) default '1' COMMENT '状态',
    gender char(1) COMMENT '性别'
);
在为字段添加约束时,我们只需要在字段之后加上约束的关键字即可,需要关注其语法
insert into tb_user(name,age,status,gender) values ('Tom1',19,'1','男'),('Tom2',25,'0','男');
insert into tb_user(name,age,status,gender) values ('Tom3',19,'1','男');
insert into tb_user(name,age,status,gender) values (null,19,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom3',19,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom4',80,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom5',-1,'1','男');
insert into tb_user(name,age,status,gender) values ('Tom5',121,'1','男');
insert into tb_user(name,age,gender) values ('Tom5',120,'男');
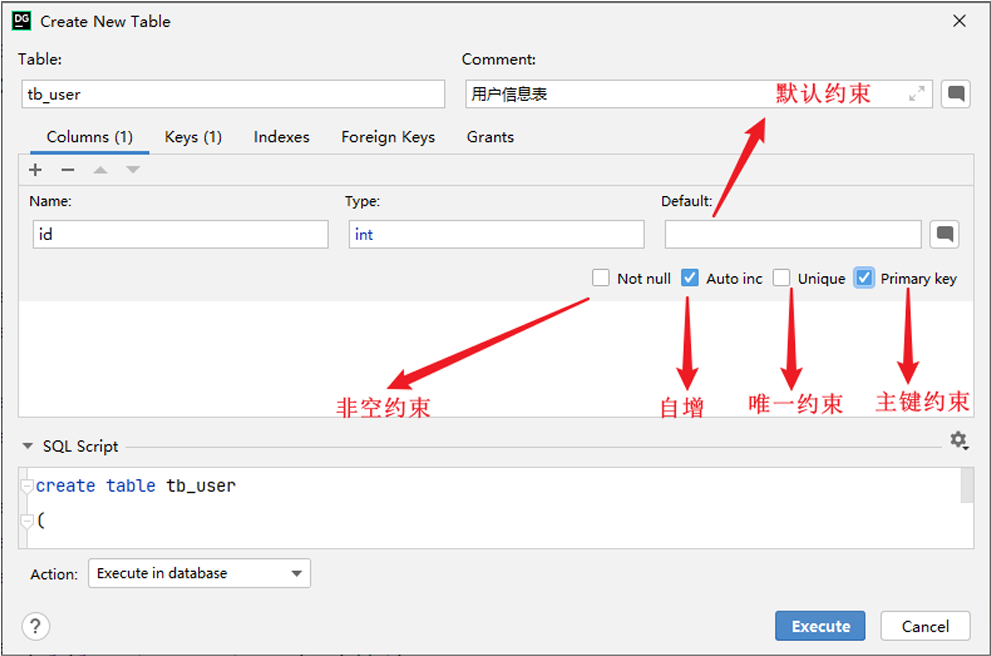
通过图形化界面来创建表结构时选择约束:
3、外键约束
(1)介绍
外键:用来让两张表的数据之间建立连接,从而保证数据的一致性和完整性
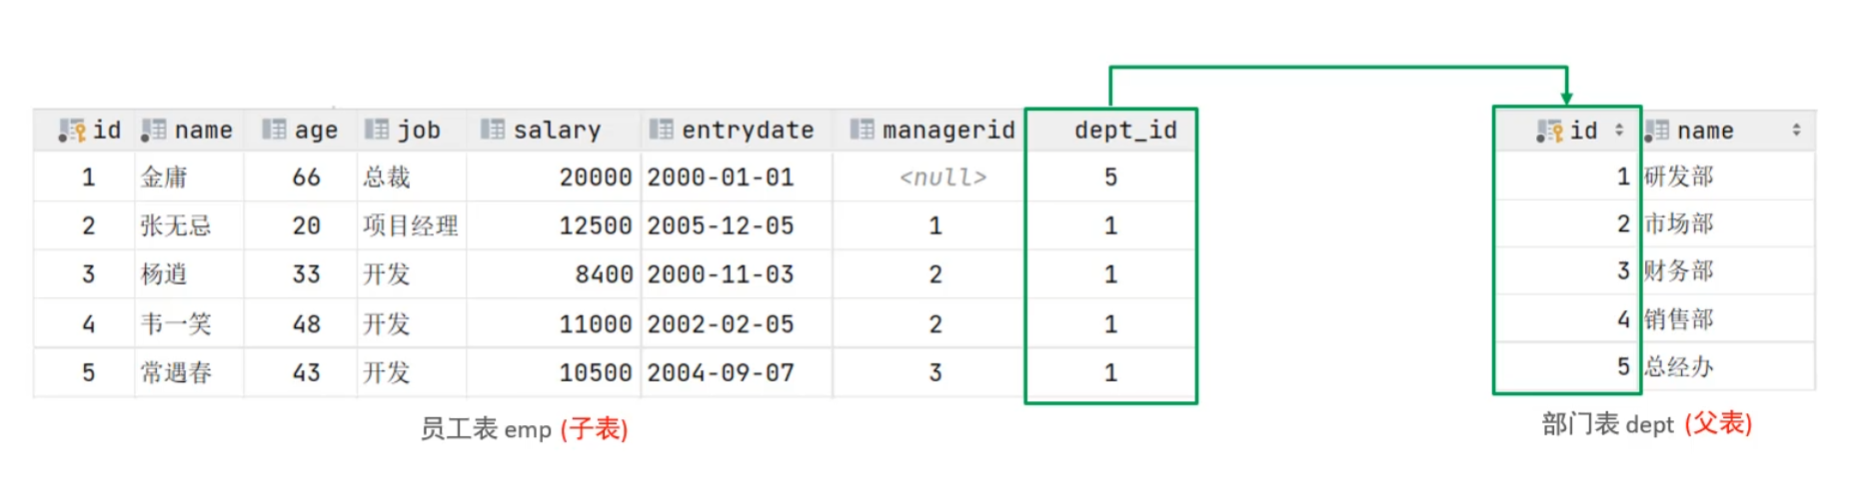
上图中,emp 表的 dept_id 就是外键,关联的是另一张表的主键,也可以称“主表 - 从表”
注意:
目前上述两张表,只是在逻辑上存在这样一层关系,在数据库层面,并未建立外键关联,所以是无法保证数据的一致性和完整性的
没有数据库外键关联的情况下,能够保证一致性和完整性呢,我们来测试一下
(2)语法
1)添加外键
建表时添加外键语法:
CREATE TABLE 表名(
    字段名  数据类型,
    ...
    [CONSTRAINT] [外键名称] FOREIGN KEY (外键字段名) REFERENCES 主表 (主表列名)
);
已有表添加外键语法:
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段名) REFERENCES 主表 (主表列名);案例:
为 emp 表的 dept_id 字段添加外键约束,关联 dept 表的主键 id,数据准备详见文末:数据准备—外键约束部分
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references dept(id);添加了外键约束之后,我们在 dept 表(父表)删除 id 为 1 的记录,此时将会报错,不能删除或更新父表记录,因为存在外键约束
2)删除外键
语法:
ALTER TABLE 表名 DROP FOREIGN KEY 外键名称;案例:
删除 emp 表的外键 fk_emp_dept_id
alter table emp drop foreign key fk_emp_dept_id;(3)外键删除 / 更新行为
添加了外键之后,再删除父表数据时产生的约束行为,我们就称为删除 / 更新行为。具体的删除 / 更新行为有以下几种:
| 行为 | 说明 |
|---|---|
| NO ACTION | 当在父表中删除 / 更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除 / 更新(与 RESTRICT 一致)默认行为 |
| RESTRICT | 当在父表中删除 / 更新对应记录时,首先检查该记录是否有对应外键,如果有则不允许删除 / 更新(与 NO ACTION 一致)默认行为 |
| CASCADE | 当在父表中删除 / 更新对应记录时,首先检查该记录是否有对应外键,如果有,则也删除 / 更新外键在子表中的记录 |
| SET NULL | 当在父表中删除对应记录时,首先检查该记录是否有对应外键,如果有则设置子表中该外键值为 null(这就要求该外键允许取 null) |
| SET DEFAULT | 父表有变更时,子表将外键列设置成一个默认的值(Innodb 不支持) |
具体语法:
ALTER TABLE 表名 ADD CONSTRAINT 外键名称 FOREIGN KEY (外键字段) REFERENCES 主表名 (主表字段名) ON UPDATE CASCADE ON DELETE CASCADE;1)CASCADE
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references dept(id) on update cascade on delete cascade ;A.修改父表 id 为 1的记录,将 id 修改为 6 我们发现,原来在子表中 dept_id 值为 1 的记录,现在也变为 6 了,这就是 cascade 级联的效果
在一般的业务系统中,不会修改一张表的主键值
B.删除父表 id 为 6 的记录,我们发现父表的数据删除成功了,但是子表中关联的记录也被级联删除了
2)SET NULL
alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references dept(id) on update set null on delete set null ;我们发现父表的记录是可以正常的删除的,父表的数据删除之后,再打开子表 emp,我们发现子表原来 dept_id为 1 的数据,现在都被置为 NULL 了
五、MySQL 基础之 —— 多表查询
1、多表关系
项目开发中,在进行数据库表结构设计时,会根据业务需求及业务模块之间的关系,分析并设计表结构,由于业务之间相互关联,所以各个表结构之间也存在着各种联系,基本上分为三种:
- 一对多(多对一)
- 多对多
- 一对一
(1) 一对多
- 案例:部门与员工的关系
- 关系:一个部门对应多个员工,一个员工对应一个部门
- 实现:在多的一方建立外键,指向一的一方的主键
员工表(emp)N端,部门表(dept) 1端,员工表 dept_id 外键关联部门表主键 id
(2)多对多
- 案例:学生与课程的关系
- 关系:一个学生可以选修多门课程,一门课程也可以供多个学生选择
- 实现:建立第三张中间表,中间表至少包含两个外键,分别关联两方主键
学生表(student) N端,课程表(course) N端,中间表 student_course,studentid 关联学生 id,courseid 关联课程 id
create table student(
    id int auto_increment primary key comment '主键ID',
    name varchar(10) comment '姓名',
    no varchar(10) comment '学号'
) comment '学生表';

insert into student values (null, '黛绮丝', '2000100101'),(null, '谢逊','2000100102'),(null, '殷天正', '2000100103'),(null, '韦一笑', '2000100104');

create table course(
    id int auto_increment primary key comment '主键ID',
    name varchar(10) comment '课程名称'
) comment '课程表';

insert into course values (null, 'Java'), (null, 'PHP'), (null , 'MySQL') , (null, 'Hadoop');

create table student_course(
    id int auto_increment comment '主键' primary key,
    studentid int not null comment '学生ID',
    courseid int not null comment '课程ID',
    constraint fk_courseid foreign key (courseid) references course (id),
    constraint fk_studentid foreign key (studentid) references student (id)
) comment '学生课程中间表';

insert into student_course values (null,1,1),(null,1,2),(null,1,3),(null,2,2),(null,2,3),(null,3,4);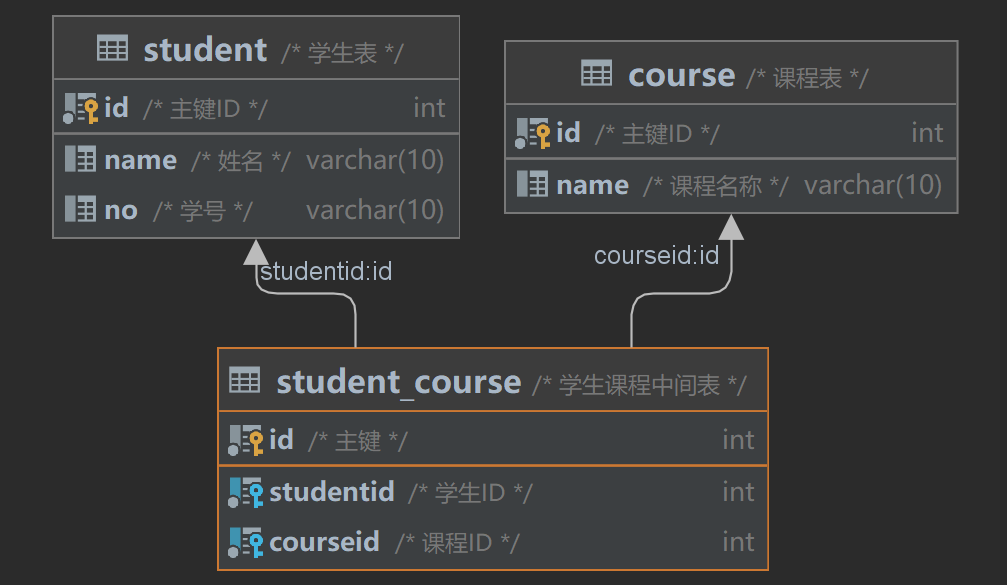
(3)一对一
- 案例:用户与用户详情的关系
- 关系:一对一关系,多用于单表拆分,将一张表的基础字段放在一张表中,其他详情字段放在另一张表中,以提升操作效率
- 实现:在任意一方加入外键,关联另外一方的主键,并且设置外键为唯一的(UNIQUE)
- 用户基本信息表(tb_user):存储用户基础信息
- 用户教育信息表(tb_user_edu):存储用户详情,userid 为外键且加唯一约束,关联 tb_user 的 id
create table tb_user(
    id int auto_increment primary key comment '主键ID',
    name varchar(10) comment '姓名',
    age int comment '年龄',
    gender char(1) comment '1: 男 , 2: 女',
    phone char(11) comment '手机号'
) comment '用户基本信息表';

create table tb_user_edu(
    id int auto_increment primary key comment '主键ID',
    degree varchar(20) comment '学历',
    major varchar(50) comment '专业',
    primaryschool varchar(50) comment '小学',
    middleschool varchar(50) comment '中学',
    university varchar(50) comment '大学',
    userid int unique comment '用户ID',
    constraint fk_userid foreign key (userid) references tb_user(id)
) comment '用户教育信息表';

insert into tb_user(id, name, age, gender, phone) values
    (null,'黄渤',45,'1','18800001111'),
    (null,'冰冰',35,'2','18800002222'),
    (null,'码云',55,'1','18800008888'),
    (null,'李彦宏',50,'1','18800009999');

insert into tb_user_edu(id, degree, major, primaryschool, middleschool, university, userid) values
    (null,'本科','舞蹈','静安区第一小学','静安区第一中学','北京舞蹈学院',1),
    (null,'硕士','表演','朝阳区第一小学','朝阳区第一中学','北京电影学院',2),
    (null,'本科','英语','杭州市第一小学','杭州市第一中学','杭州师范大学',3),
    (null,'本科','应用数学','阳泉第一小学','阳泉区第一中学','清华大学',4);
2、多表查询介绍
(1)概述
多表查询就是指从多张表中查询数据
原来查询单表数据,执行的SQL形式为:
select * from emp;那么我们要执行多表查询,就只需要使用逗号分隔多张表即可,如:
select * from emp , dept;此时,我们看到查询结果中包含了大量的结果集,总共 102 条记录,而这其实就是员工表 emp 所有的记录(17)与部门表dept所有记录(6)的所有组合情况,这种现象称之为笛卡尔积
笛卡尔积:笛卡尔积是指在数学中,两个集合 A 集合 和 B 集合的所有组合情况
注意:多表查询必须添加条件消除笛卡尔积,否则会产生大量无效数据
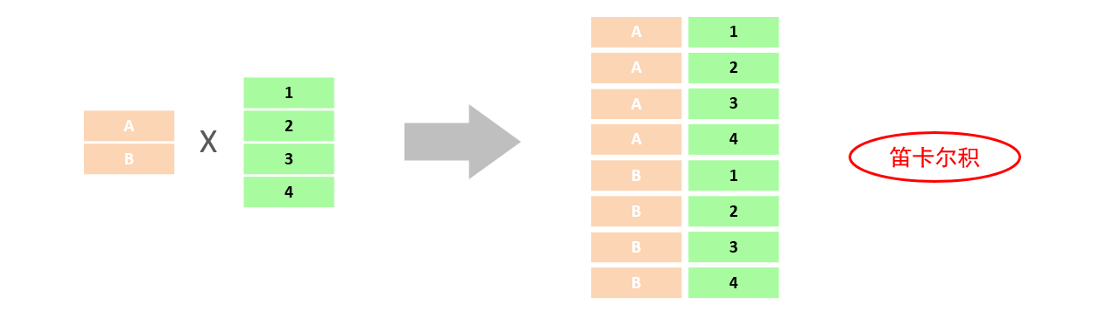
而在多表查询中,我们是需要消除无效的笛卡尔积的,只保留两张表关联部分的数据
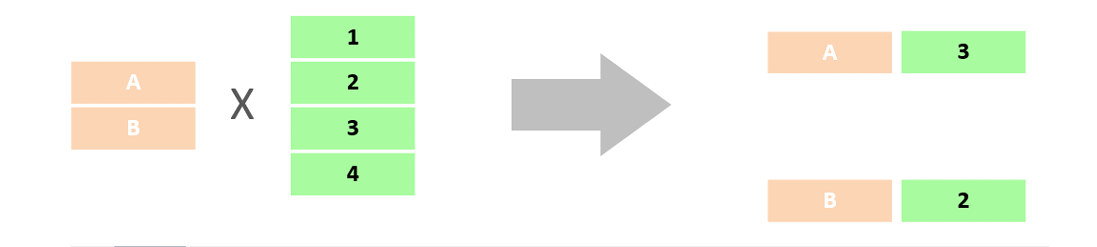
select * from emp , dept where emp.dept_id = dept.id;(2)分类
- 连接查询
- 内连接:相当于查询A、B交集部分数据
- 外连接
- 左外连接:查询左表所有数据,以及两张表交集部分数据
- 右外连接:查询右表所有数据,以及两张表交集部分数据
- 自连接:当前表与自身的连接查询,自连接必须使用表别名
- 子查询
3、内连接
内连接查询的是两张表交集部分的数据
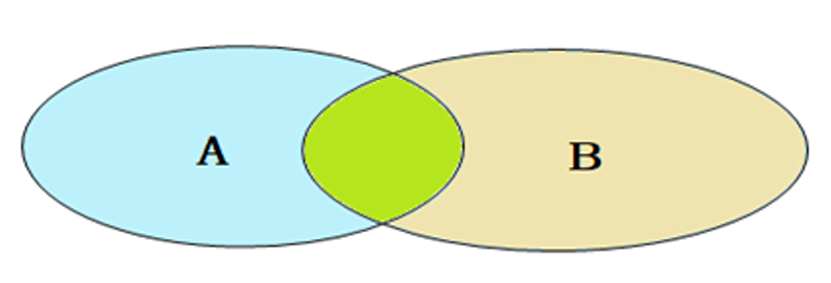
内连接的语法分为两种:
- 隐式内连接
- 显式内连接
(1)隐式内连接
SELECT 字段列表 FROM 表1 , 表2 WHERE 条件 ... ;(2)显式内连接
SELECT 字段列表 FROM 表1 [ INNER ] JOIN 表2 ON 连接条件 ... ;(3)案例
A. 查询每一个员工的姓名,及关联的部门的名称(隐式内连接实现) :
select emp.name , dept.name from emp , dept where emp.dept_id = dept.id ;

-- 为每一张表起别名,简化SQL编写
select e.name,d.name from emp e , dept d where e.dept_id = d.id;
B. 查询每一个员工的姓名,及关联的部门的名称(显式内连接实现)
select e.name, d.name from emp e inner join dept d on e.dept_id = d.id;

-- 为每一张表起别名,简化SQL编写
select e.name, d.name from emp e join dept d on e.dept_id = d.id;
表的别名:
tablea as 别名 1 , tableb as 别名 2 ;tablea 别名 1 , tableb 别名 2 ;- 一旦为表起了别名,就不能再使用表名来指定对应的字段了,此时只能够使用别名来指定字段
4、外连接
外连接分为两种,分别是:左外连接 和 右外连接
(1)左外连接
SELECT 字段列表 FROM 表1 LEFT [ OUTER ] JOIN 表2 ON 条件 ... ;左外连接相当于查询表1(左表)的所有数据,当然也包含表 1 和表 2 交集部分的数据
(2)右外连接
SELECT 字段列表 FROM 表1 RIGHT [ OUTER ] JOIN 表2 ON 条件 ... ;右外连接相当于查询表 2(右表)的所有数据,当然也包含表 1 和表 2 交集部分的数据
(3)案例
A. 查询 emp 表的所有数据,和对应的部门信息
由于要查询 emp 的所有数据,所以是不能内连接查询的,需要考虑使用外连接查询(左外连接)
select e.*, d.name from emp e left outer join dept d on e.dept_id = d.id;

select e.*, d.name from emp e left join dept d on e.dept_id = d.id;
B. 查询 dept 表的所有数据,和对应的员工信息(右外连接)
select d.*, e.* from emp e right outer join dept d on e.dept_id = d.id;

select d.*, e.* from dept d left outer join emp e on e.dept_id = d.id;
(4)注意事项
左外连接和右外连接是可以相互替换的,只需要调整在连接查询时 SQL 中,表结构的先后顺序就可以了。而我们在日常开发使用时,更偏向于左外连接
5、自连接
(1)自连接查询
自连接查询,顾名思义,就是自己连接自己,也就是把一张表连接查询多次
自连接语法:
SELECT 字段列表 FROM 表A 别名A JOIN 表A 别名B ON 条件 ... ;自连接查询,可以是内连接查询,也可以是外连接查询
案例
A. 查询员工 及其所属领导的名字
select a.name , b.name from emp a , emp b where a.managerid = b.id;B. 查询所有员工 emp 及其领导的名字 emp,如果员工没有领导,也需要查询出来
select a.name '员工', b.name '领导' from emp a left join emp b on a.managerid = b.id;注意事项
在自连接查询中,必须要为表起别名,要不然我们不清楚所指定的条件、返回的字段,到底是哪一张表的字段
(2)UNION 联合查询
对于 union 查询,就是把多次查询的结果合并起来,形成一个新的查询结果集
SELECT 字段列表 FROM 表 A ...
UNION [ ALL ]
SELECT 字段列表 FROM 表 B ...;- 联合查询的多张表的列数必须保持一致,字段类型也需要保持一致
union all:将全部的数据直接合并在一起,不去重union:会对合并之后的数据自动去重
案例
A. 将薪资低于 5000 的员工,和年龄大于 50 岁的员工全部查询出来
该需求也可以用 or 多条件查询实现,这里演示 union all
select * from emp where salary < 5000
union all
select * from emp where age > 50;
union all 查询出来的结果,仅仅进行简单的合并,并未去重,如果改成 union,重复记录只会保留一条:
select * from emp where salary < 5000
union
select * from emp where age > 50;
6、子查询
(1)概述
1)概念
SQL语句中嵌套SELECT语句,称为嵌套查询,又称子查询
SELECT * FROM t1 WHERE column1 = ( SELECT column1 FROM t2 );子查询外部的语句可以是 INSERT / UPDATE / DELETE / SELECT 的任何一个
2)分类
- 根据子查询结果不同,分为:
- A. 标量子查询(子查询结果为单个值)
- B. 列子查询(子查询结果为一列)
- C. 行子查询(子查询结果为一行)
- D. 表子查询(子查询结果为多行多列)
- 根据子查询位置,分为:
- A. WHERE 之后
- B. FROM 之后
- C. SELECT 之后
(2)标量子查询
子查询返回的结果是单个值(数字、字符串、日期等),最简单的形式,这种子查询称为标量子查询
常用的操作符:= <> > >= < <=
案例
A. 查询 “销售部” 的所有员工信息
完成这个需求时,我们可以将需求分解为两步:
① 查询 “销售部” 部门ID
select id from dept where name = '销售部';② 根据 “销售部” 部门ID,查询员工信息
select * from emp where dept_id = (select id from dept where name = '销售部');B. 查询在 “方东白” 入职之后的员工信息
完成这个需求时,我们可以将需求分解为两步:
① 查询 “方东白” 的入职日期
select entrydate from emp where name = '方东白';② 查询指定入职日期之后入职的员工信息
select * from emp where entrydate > (select entrydate from emp where name = '方东白');(3)列子查询
子查询返回的结果是一列(可以是多行),这种子查询称为列子查询
常用的操作符:IN、NOT IN、ANY、SOME、ALL
| 操作符 | 描述 |
|---|---|
| IN | 在指定的集合范围之内,多选一 |
| NOT IN | 不在指定的集合范围之内 |
| ANY | 子查询返回列表中,有任意一个满足即可 |
| SOME | 与 ANY 等同,使用 SOME 的地方都可以使用 ANY |
| ALL | 子查询返回列表的所有值都必须满足 |
案例
A. 查询 “销售部” 和 “市场部” 的所有员工信息
分解为以下两步:
① 查询 “销售部” 和 “市场部” 的部门 ID
select id from dept where name = '销售部' or name = '市场部';② 根据部门 ID,查询员工信息
select * from emp where dept_id in (select id from dept where name = '销售部' or name = '市场部');B. 查询比 “财务部” 所有人工资都高的员工信息
分解为以下两步:
① 查询所有 “财务部” 人员工资
select id from dept where name = '财务部';
select salary from emp where dept_id = (select id from dept where name = '财务部');
② 比财务部所有人工资都高的员工信息
select * from emp where salary > all (select salary from emp where dept_id = (select id from dept where name = '财务部'));C. 查询比研发部其中任意一人工资高的员工信息
分解为以下两步:
① 查询研发部所有人工资
select salary from emp where dept_id = (select id from dept where name = '研发部');② 比研发部其中任意一人工资高的员工信息
select * from emp where salary > any (select salary from emp where dept_id = (select id from dept where name = '研发部'))(4)行子查询
子查询返回的结果是一行(可以是多列),这种子查询称为行子查询
常用的操作符:=、<>、IN、NOT IN
案例
A. 查询与 “张无忌” 的薪资及直属领导相同的员工信息
拆解为两步进行:
① 查询 “张无忌” 的薪资及直属领导
select salary, managerid from emp where name = '张无忌';② 查询与 “张无忌” 的薪资及直属领导相同的员工信息;
select * from emp where (salary,managerid) = (select salary, managerid from emp where name = '张无忌');(5)表子查询
子查询返回的结果是多行多列,这种子查询称为表子查询
常用的操作符:IN
案例
A. 查询与 “鹿杖客”,“宋远桥” 的职位和薪资相同的员工信息
分解为两步执行:
① 查询 “鹿杖客”,“宋远桥” 的职位和薪资
select job, salary from emp where name = '鹿杖客' or name = '宋远桥';② 查询与 “鹿杖客”,“宋远桥” 的职位和薪资相同的员工信息
select * from emp where (job,salary) in ( select job, salary from emp where name = '鹿杖客' or name = '宋远桥' );B. 查询入职日期是 “2006-01-01” 之后的员工信息,及其部门信息
分解为两步执行:
① 入职日期是 “2006-01-01” 之后的员工信息
select * from emp where entrydate > '2006-01-01';② 查询这部分员工,对应的部门信息;
select e.*, d.* from (select * from emp where entrydate > '2006-01-01') e left join dept d on e.dept_id = d.id ;7、多表查询案例
数据准备
数据准备详见文末:数据准备—多表查询部分部分
create table salgrade(
    grade int,
    losal int,
    hisal int
) comment '薪资等级表';

insert into salgrade values (1,0,3000);
insert into salgrade values (2,3001,5000);
insert into salgrade values (3,5001,8000);
insert into salgrade values (4,8001,10000);
insert into salgrade values (5,10001,15000);
insert into salgrade values (6,15001,20000);
insert into salgrade values (7,20001,25000);
insert into salgrade values (8,25001,30000);
案例涉及三张表:
emp员工表dept部门表salgrade薪资等级表
(1)查询员工的姓名、年龄、职位、部门信息(隐式内连接)
select e.name , e.age , e.job , d.name from emp e , dept d where e.dept_id = d.id;(2)查询年龄小于30岁的员工的姓名、年龄、职位、部门信息(显式内连接)
select e.name , e.age , e.job , d.name from emp e inner join dept d on e.dept_id = d.id where e.age < 30;(3)查询拥有员工的部门ID、部门名称
select distinct d.id , d.name from emp e , dept d where e.dept_id = d.id;(4)查询所有年龄大于40岁的员工,及其归属的部门名称;如果员工没有分配部门,也需要展示出来(外连接)
select e.*, d.name from emp e left join dept d on e.dept_id = d.id where e.age > 40 ;(5)查询所有员工的工资等级
-- 方式一
select e.* , s.grade , s.losal, s.hisal from emp e , salgrade s where e.salary >= s.losal and e.salary <= s.hisal;
-- 方式二
select e.* , s.grade , s.losal, s.hisal from emp e , salgrade s where e.salary between s.losal and s.hisal;
(6)查询 “研发部” 所有员工的信息及 工资等级
select e.* , s.grade from emp e , dept d , salgrade s where e.dept_id = d.id and (e.salary between s.losal and s.hisal ) and d.name = '研发部';(7)查询 “研发部” 员工的平均工资
select avg(e.salary) from emp e, dept d where e.dept_id = d.id and d.name = '研发部';(8)查询工资比 “灭绝” 高的员工信息。
① 查询 “灭绝” 的薪资
select salary from emp where name = '灭绝';② 查询比她工资高的员工数据
select * from emp where salary > ( select salary from emp where name = '灭绝' );(9)查询比平均薪资高的员工信息
① 查询员工的平均薪资
select avg(salary) from emp;② 查询比平均薪资高的员工信息
select * from emp where salary > ( select avg(salary) from emp );(10)查询低于本部门平均工资的员工信息
① 查询指定部门平均薪资
select avg(e1.salary) from emp e1 where e1.dept_id = 1;
select avg(e1.salary) from emp e1 where e1.dept_id = 2;
② 查询低于本部门平均工资的员工信息
select * from emp e2 where e2.salary < ( select avg(e1.salary) from emp e1 where e1.dept_id = e2.dept_id );(11)查询所有的部门信息,并统计部门的员工人数
select d.id, d.name , ( select count(*) from emp e where e.dept_id = d.id ) '人数' from dept d;(12)查询所有学生的选课情况,展示出学生名称,学号,课程名称
select s.name , s.no , c.name from student s , student_course sc , course c where s.id = sc.studentid and sc.courseid = c.id ;备注:以上需求的实现方式可能会很多,SQL写法也有很多,只要能满足我们的需求,查询出符合条件的记录即可
六、MySQL 基础之 —— 事务
1、事务简介
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败
就比如:张三给李四转账 1000 块钱,张三银行账户的钱减少 1000,而李四银行账户的钱要增加 1000。这一组操作就必须在一个事务的范围内,要么都成功,要么都失败
正常情况:转账这个操作,需要分为三步来完成(查询张三账户余额、张三账户余额 - 1000、李四账户余额 + 1000) ,三步完成之后,张三减少 1000,而李四增加 1000,转账成功
异常情况:转账这个操作,也是分为以下这么三步来完成,在执行第三步是报错了,这样就导致张三减少 1000 块钱,而李四的金额没变,这样就造成了数据的不一致,就出现问题了
为了解决上述的问题,就需要通过数据的事务来完成,我们只需要在业务逻辑执行之前开启事务,执行完毕后提交事务。如果执行过程中报错,则回滚事务,把数据恢复到事务开始之前的状态
-
开启事务(抛异常 → 回滚事务)
-
查询张三账户余额
-
张三账户余额 - 1000
-
李四账户余额 + 1000
-
-
提交事务
注意:默认 MySQL 的事务是自动提交的,也就是说,当执行完一条 DML 语句时,MySQL 会立即隐式的提交事务
2、事务操作
数据准备
drop table if exists account;

create table account(
    id int primary key AUTO_INCREMENT comment 'ID',
    name varchar(10) comment '姓名',
    money double(10,2) comment '余额'
) comment '账户表';

insert into account(name, money) VALUES ('张三',2000), ('李四',2000);
(1)控制事务方式一
1)查看 / 设置事务提交方式
SELECT @@autocommit ;   # 查看事务是否自动提交
SET @@autocommit = 0 ;  # 事务设置为手动提交
2)提交事务
COMMIT;3)回滚事务
ROLLBACK;注意:
上述的这种方式,我们是修改了事务的自动提交行为,把默认的自动提交修改为了手动提交,此时我们执行的 DML 语句都不会提交,需要手动的执行 commit 进行提交
(2)控制事务方式二
1)开启事务
START TRANSACTION 或 BEGIN ;2)提交事务
COMMIT;3)回滚事务
ROLLBACK;案例
-- 开启事务
start transaction

-- 1. 查询张三余额
select * from account where name = '张三';

-- 2. 张三的余额减少 1000
update account set money = money - 1000 where name = '张三';

-- 3. 李四的余额增加 1000
update account set money = money + 1000 where name = '李四';

-- 如果正常执行完毕,则提交事务
commit;

-- 如果执行过程中报错,则回滚事务
rollback;
3、事务四大特性
- 原子性(Atomicity):事务是不可分割的最小操作单元,要么全部成功,要么全部失败
- 一致性(Consistency):事务完成时,必须使所有的数据都保持一致状态
- 隔离性(Isolation):数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行
- 持久性(Durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的
上述就是事务的四大特性,简称 ACID
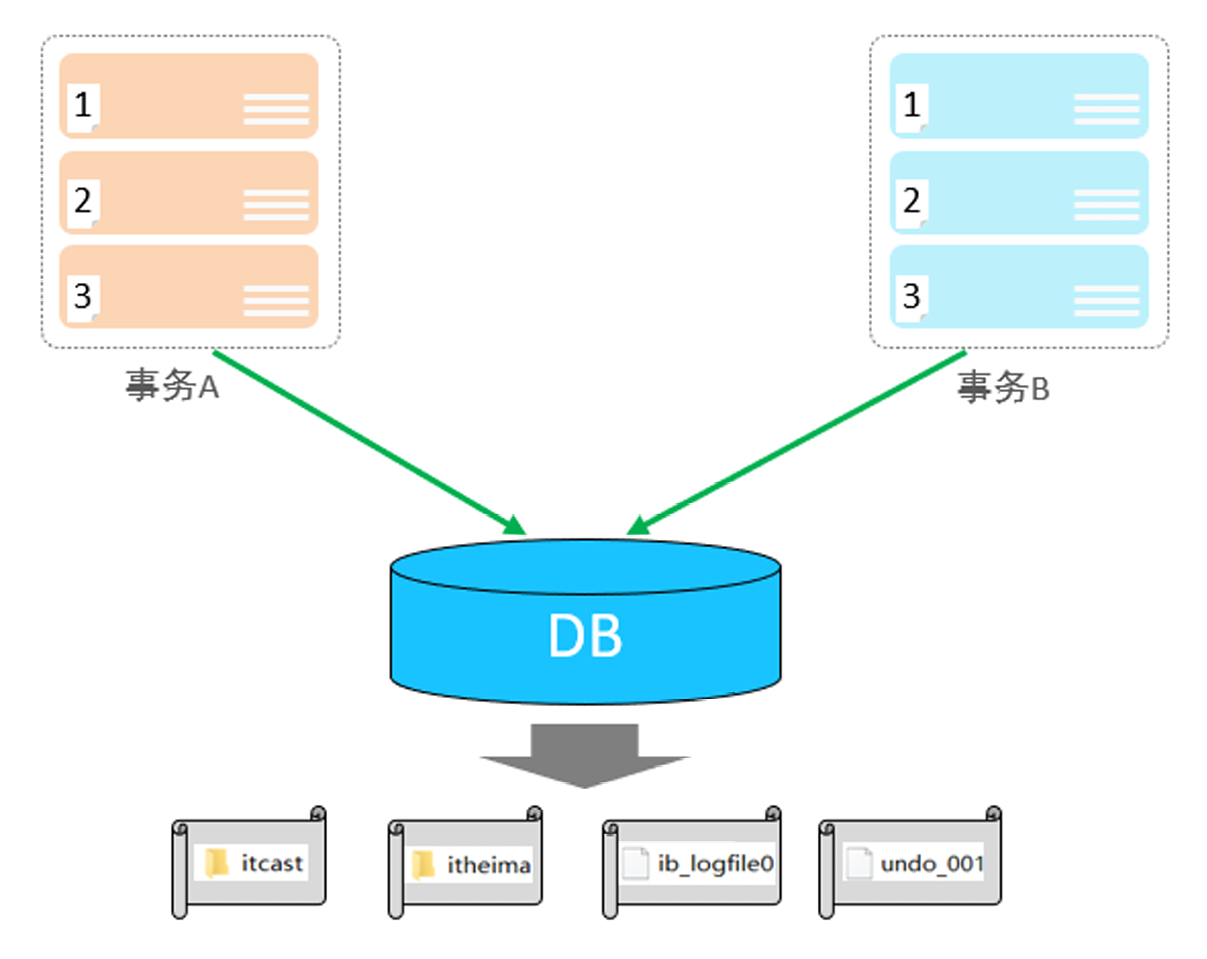
4、并发事务问题
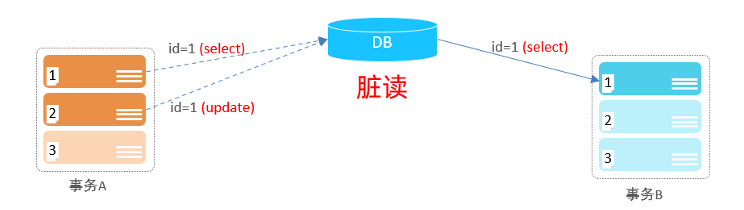
-
脏读:一个事务读到另外一个事务还没有提交的数据。 比如事务 B 读取到了事务 A 未提交的数据
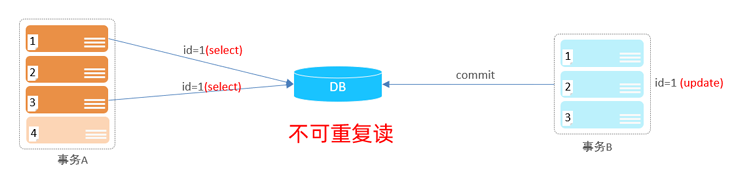
-
不可重复读:一个事务先后读取同一条记录,但两次读取的数据不同,称之为不可重复读。事务 A 两次读取同一条记录,但是读取到的数据却是不一样的(事务 B 在中间执行了 update 并提交)
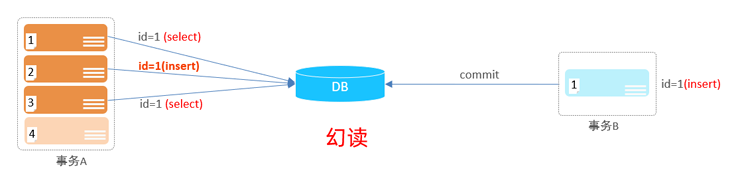
-
幻读:一个事务按照条件查询数据时,没有对应的数据行,但是在插入数据时,又发现这行数据已经存在,好像出现了“幻影”
5、事务隔离级别
为了解决并发事务所引发的问题,在数据库中引入了事务隔离级别。主要有以下几种:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| Read uncommitted 读未提交 | √ | √ | √ |
| Read committed 读已提交 | × | √ | √ |
| Repeatable Read 可重复读(MySQL 的默认级别) | × | × | √ |
| Serializable 串行化 | × | × | × |
1)查看事务隔离级别
SELECT @@TRANSACTION_ISOLATION;2)设置事务隔离级别
SET [ SESSION | GLOBAL ] TRANSACTION ISOLATION LEVEL { READ UNCOMMITTED | READ COMMITTED | REPEATABLE READ | SERIALIZABLE }- SESSION:针对当前会话窗口有效
- GLOBAL:针对所有会话窗口有效
注意:
事务隔离级别越高,数据越安全,但是性能越低,所以我们在设置事务隔离级别的时候需要权衡安全性和性能,一般会用默认级别,不会做修改
七、MySQL 进阶之 —— 存储引擎
1、MySQL 体系结构
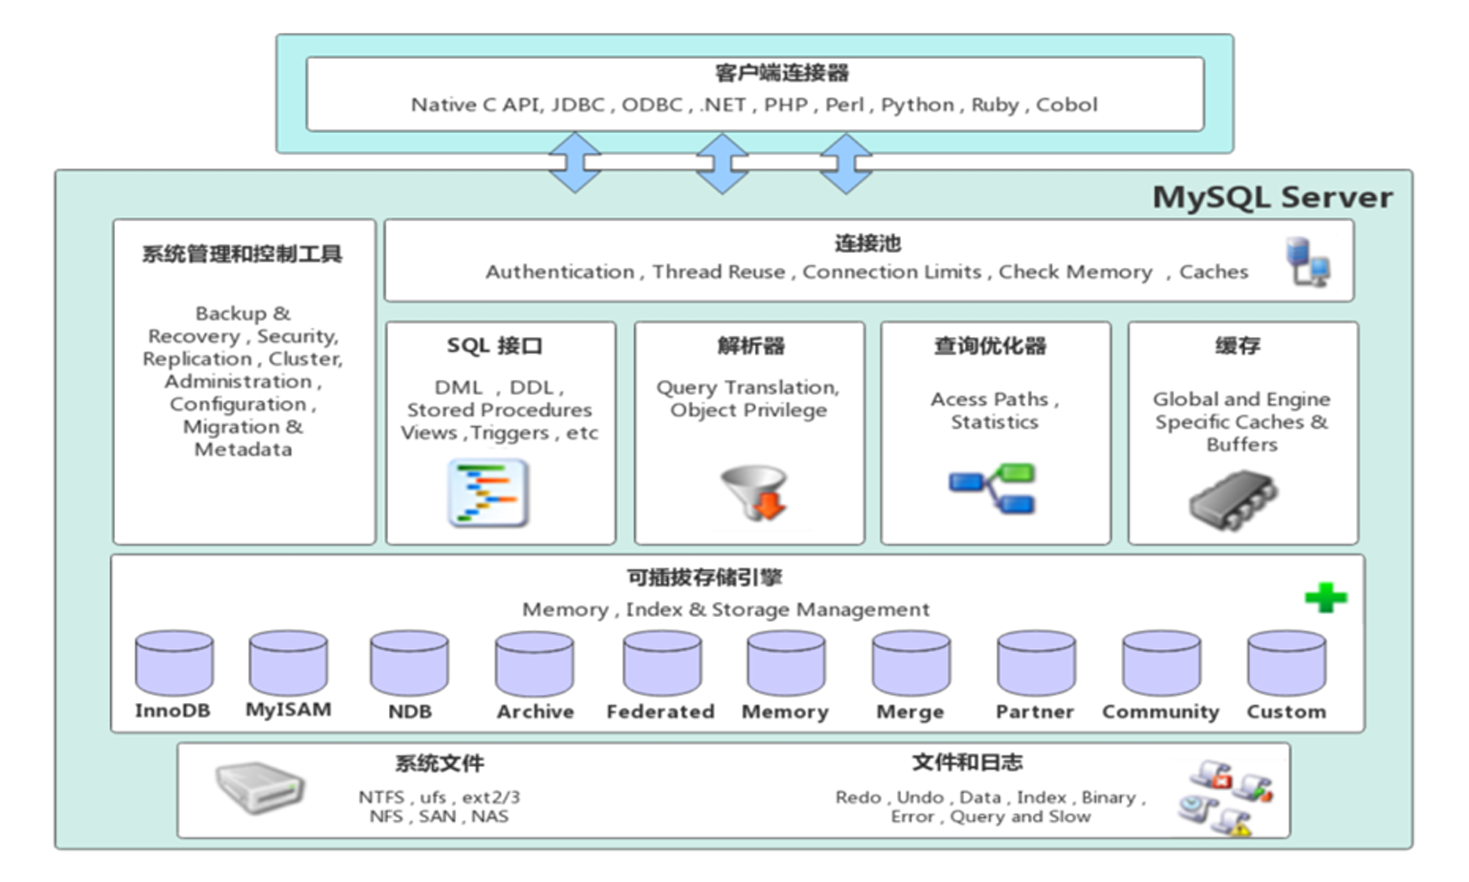
(1)连接层(最上层)
负责客户端连接处理:
- 通信:本地 socket、TCP / IP 通信
- 功能:连接管理、授权认证、安全方案、SSL 安全链接
- 线程池:认证通过的客户端分配线程
- 权限校验:验证客户端操作权限
最上层是一些客户端和链接服务,包含本地 sock 通信和大多数基于客户端 / 服务端工具实现的类似于 TCP / IP 的通信。主要完成一些类似于连接处理、授权认证、及相关的安全方案。在该层上引入了线程池的概念,为通过认证安全接入的客户端提供线程。同样在该层上可以实现基于 SSL 的安全链接。服务器也会为安全接入的每个客户端验证它所具有的操作权限
(2)服务层(核心层)
MySQL 核心服务功能,是架构最重要一层:
- SQL 接口接收 SQL 语句
- 包含:查询缓存、SQL 解析、SQL 优化、内置函数执行
- 存储引擎相关:过程、函数
- 执行流程:解析 SQL → 生成解析树 → 优化(确定查询顺序、索引选择)→ 生成执行计划
- 查询缓存:
select语句优先查缓存,缓存命中直接返回结果,提升大量读操作性能
第二层架构主要完成大多数的核心服务功能,如 SQL 接口,并完成缓存的查询,SQL 的分析和优化,部分内置函数的执行。所有跨存储引擎的功能也在这一层实现,如 过程、函数等。在该层,服务器会解析查询并创建相应的内部解析树,并对其完成相应的优化如确定表的查询的顺序,是否利用索引等,最后生成相应的执行操作。如果是 select 语句,服务器还会查询内部的缓存,如果缓存空间足够大,这样在解决大量读操作的环境中能够很好的提升系统的性能
(3)引擎层(存储引擎层)
真正负责数据存储与提取:
- 服务器通过 AP I和存储引擎交互
- 插件式架构:可按需选择不同存储引擎(InnoDB、MyISAM 等)
- 索引在这一层实现
存储引擎层, 存储引擎真正的负责了 MySQL 中数据的存储和提取,服务器通过 API 和存储引擎进行通信。不同的存储引擎具有不同的功能,这样我们可以根据自己的需要,来选取合适的存储引擎。数据库中的索引是在存储引擎层实现的
(4) 存储层(数据存储层)
文件系统层面保存各类数据文件:
- 存储内容:redo log、undo log、数据表数据、索引、二进制日志、错误日志、慢查询日志等
- 和存储引擎交互,持久化数据
数据存储层, 主要是将数据 (如: redolog、undolog、数据、索引、二进制日志、错误日志、查询日志、慢查询日志等) 存储在文件系统之上,并完成与存储引擎的交互
MySQL 架构特点
插件式存储引擎架构,查询处理任务 和 数据存储提取相互分离,业务场景不同可以选用适配的存储引擎
2、存储引擎简介
存储引擎是 mysql 数据库的核心,我们也需要在合适的场景选择合适的存储引擎
存储引擎就是存储数据、建立索引、更新/查询数据等技术的实现方式 。存储引擎是基于表的,而不是基于库的,所以存储引擎也可被称为表类型
我们可以在创建表的时候,来指定选择的存储引擎,如果没有指定将自动选择默认的存储引擎
1)建表时指定存储引擎
CREATE TABLE 表名(
    字段1 字段1类型 [ COMMENT 字段1注释 ],
    ......
    字段n 字段n类型 [COMMENT 字段n注释 ]
) ENGINE = INNODB [ COMMENT 表注释 ] ;
2)查询当前数据库支持的存储引擎
show engines;示例演示:
A.查询建表语句 --- 默认存储引擎:InnoDB
show create table account;
CREATE TABLE `account` (
  `id` int NOT NULL AUTO_INCREMENT COMMENT 'ID',
  `name` varchar(10) DEFAULT NULL COMMENT '姓名',
  `money` double(10,2) DEFAULT NULL COMMENT '余额',
  PRIMARY KEY (`id`)
) ENGINE=InnoDB AUTO_INCREMENT=3 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci COMMENT='账户表'
我们可以看到,创建表时,即使我们没有指定存储疫情,数据库也会自动选择默认的存储引擎
B.创建表 my_myisam,并指定 MyISAM 存储引擎
create table my_myisam(
    id int,
    name varchar(10)
) engine = MyISAM ;
3、存储引擎特点
(1)InnoDB
1)介绍
InnoDB 是一种兼顾高可靠性和高性能的通用存储引擎,在 MySQL 5.5 之后,InnoDB 是默认的 MySQL 存储引擎
2)特点
- DML 操作遵循 ACID 模型,支持事务
- 行级锁,提高并发访问性能
- 支持外键 FOREIGN KEY 约束,保证数据的完整性和正确性
3)文件
xxx.ibd: xxx 代表的是表名,innoDB 引擎的每张表都会对应这样一个表空间文件,存储该表的表结构(frm-早期的、sdi-新版的)、数据和索引
参数:innodb_file_per_table
查看系统变量:
show variables like 'innodb_file_per_table';| Variable_name | Value |
|---|---|
| innodb_file_per_table | ON |
innodb_file_per_table 默认打开,也就是说,InnoDB 引擎的每一张表对应一个表空间文件
从 xxx.ibd 文件中提取 sdi 信息:
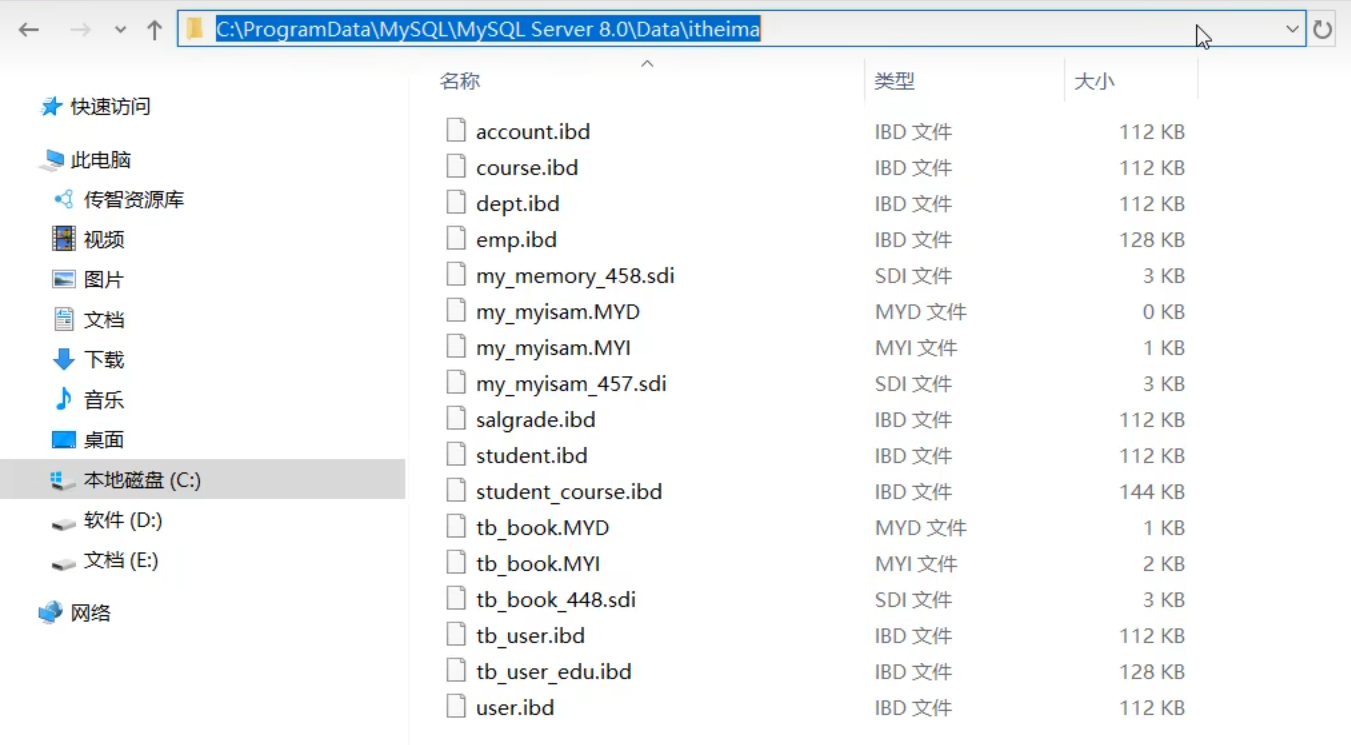
进入 cmd:
ibd2sdi 表名.ibd sdi 数据字典信息中就包含该表的表结构
4)逻辑存储结构
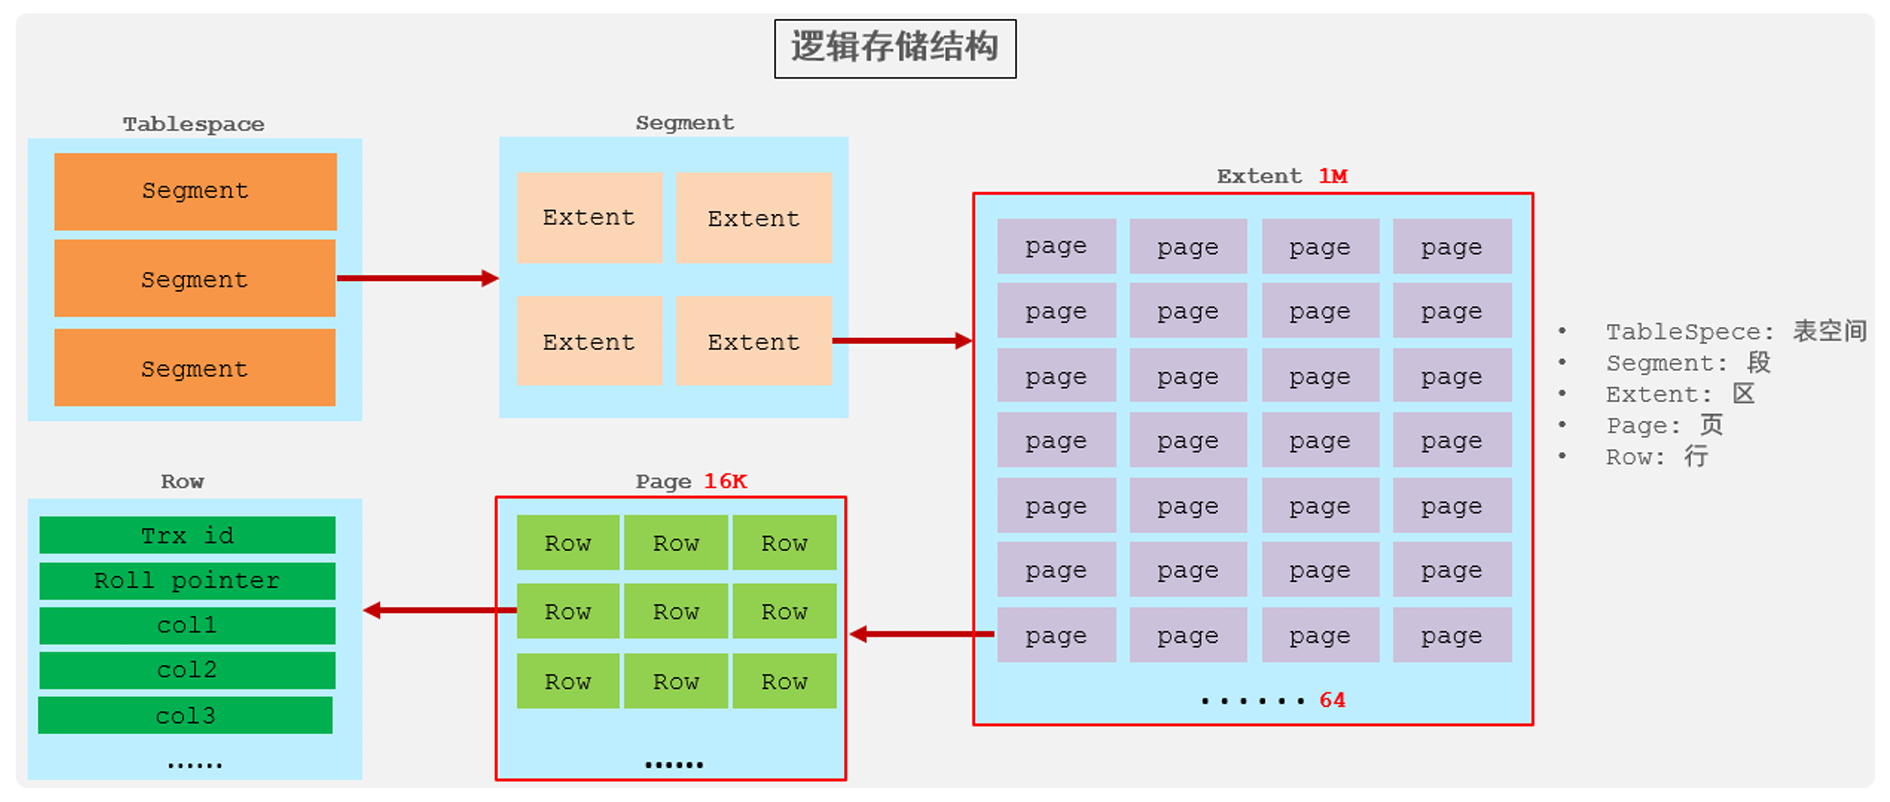
- 表空间:InnoDB 存储引擎逻辑结构的最高层,ibd 文件其实就是表空间文件,在表空间中可以包含多个 Segment 段
- 段:表空间是由各个段组成的,常见的段有数据段、索引段、回滚段等。InnoDB 中对于段的管理,都是引擎自身完成,不需要人为对其控制,一个段中包含多个区
- 区:区是表空间的单元结构,每个区的大小为 1M。 默认情况下, InnoDB 存储引擎页大小为 16K, 即一个区中一共有 64 个连续的页
- 页:页是组成区的最小单元,页也是 InnoDB 存储引擎磁盘管理的最小单元,每个页的大小默认为 16KB。为了保证页的连续性,InnoDB 存储引擎每次从磁盘申请 4-5 个区
- 行:InnoDB 存储引擎是面向行的,也就是说数据是按行进行存放的,在每一行中除了定义表时所指定的字段以外,还包含两个隐藏字段
(2)MyISAM
MyISAM 是 MySQL 早期的默认存储引擎
特点:
- 不支持事务,不支持外键
- 支持表锁,不支持行锁
- 访问速度快
文件:
- xxx.sdi:存储表结构信息,可以直接打开文件查看
- xxx.MYD:存储数据
- xxx.MYI:存储索引
(3)Memory
1)介绍
Memory 引擎的表数据时存储在内存中的,由于受到硬件问题、或断电问题的影响,只能将这些表作为临时表或缓存使用
2)特点
- 内存存放,访问速度快
- hash 索引(默认)
3)文件
xxx.sdi:存储表结构信息
(4)三种引擎区别
| 特点 | InnoDB | MyISAM | Memory |
|---|---|---|---|
| 存储限制 | 64TB | 有 | 有 |
| 事务安全 | 支持 | - | - |
| 锁机制 | 支持行锁 | 只支持表锁 | 表锁 |
| B+tree索引 | 支持 | 支持 | 支持 |
| Hash索引 | - | - | 支持 |
| 全文索引 | 支持(5.6版本之后) | 支持 | - |
| 空间使用 | 高 | 低 | N/A |
| 内存使用 | 高 | 低 | 中等 |
| 批量插入速度 | 低 | 高 | 高 |
| 支持外键 | 支持 | - | - |
面试题:
InnoDB 引擎与 MyISAM 引擎的区别 ?
① InnoDB 引擎,支持事务,而 MyISAM 不支持
② InnoDB 引擎,支持行锁和表锁,而 MyISAM 仅支持表锁,不支持行锁
③ InnoDB 引擎,支持外键,而 MyISAM 是不支持的
主要是上述三点区别,当然也可以从索引结构、存储限制等方面,更加深入的回答,具体参考如下官方文档:
https://dev.mysql.com/doc/refman/8.0/en/innodb-introduction.html
https://dev.mysql.com/doc/refman/8.0/en/myisam-storage-engine.html
4、存储引擎选择
在选择存储引擎时,应该根据应用系统的特点选择合适的存储引擎。对于复杂的应用系统,还可以根据实际情况选择多种存储引擎进行组合
- InnoDB:是 Mysql 的默认存储引擎,支持事务、外键。如果应用对事务的完整性有比较高的要求,在并发条件下要求数据的一致性,数据操作除了插入和查询之外,还包含很多的更新、删除操作,那么 InnoDB 存储引擎是比较合适的选择
- MyISAM:如果应用是以读操作和插入操作为主,只有很少的更新和删除操作,并且对事务的完整性、并发性要求不是很高,那么选择这个存储引擎是非常合适的。如日志、评论等非业务核心的数据
- MEMORY:将所有数据保存在内存中,访问速度快,通常用于临时表及缓存。MEMORY 的缺陷就是对表的大小有限制,太大的表无法缓存在内存中,而且无法保障数据的安全性
补充:
目前实际业务中,MyISAM 和 MEMORY 已经分别被 MongoDB 和 Redis 数据库替代了
八、MySQL 进阶之 —— 索引
1、Linux 系统安装 MySQL
由于在日常生产环境中绝大多数都是使用 Linux 系统,所以以下内容都是基于 Linux 系统的讲解
2、索引概述
1)介绍
索引(index)是帮助 MySQL 高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据, 这样就可以在这些数据结构上实现高级查找算法,这种数据结构就是索引
2)无索引 VS 有索引
无索引:
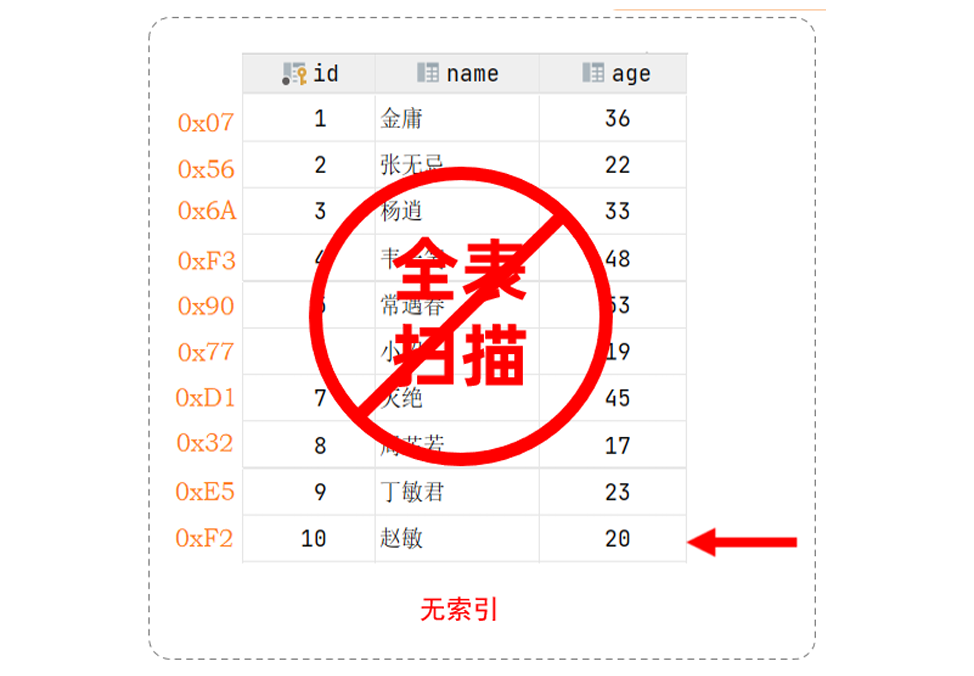
在无索引情况下,就需要从第一行开始扫描,一直扫描到最后一行,我们称之为全表扫描,性能很低
有索引:
如果我们针对于这张表建立了索引,假设索引结构就是二叉树,那么也就意味着,会对 age 这个字段建立一个二叉树的索引结构
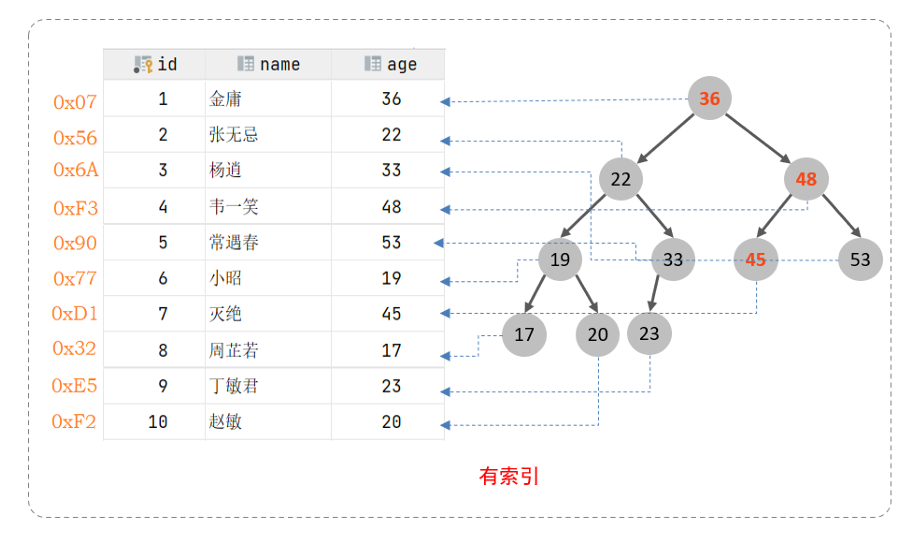
此时我们在进行查询时,只需要扫描三次就可以找到数据了,极大的提高的查询的效率
备注:
这里我们只是假设索引的结构是二叉树,介绍一下索引的大概原理,只是一个示意图,并不是索引的真实结构
2)索引特点
| 优势 | 劣势 |
|---|---|
| 提高数据检索的效率,降低数据库的 IO 成本 | 索引列也是要占用空间的 |
| 通过索引列对数据进行排序,降低数据排序的成本,降低 CPU 的消耗 | 索引大大提高了查询效率,同时却也降低更新表的速度,如对表进行 INSERT、UPDATE、DELETE 时,效率降低 |
简单一句话:
索引可以提高查询以及排序效率,但会占用空间和降低表更新效率,但是它的劣势可以忽略
3、索引结构
1)概述
MySQL 的索引是在存储引擎层实现的,不同的存储引擎有不同的索引结构,主要包含以下几种:
| 索引结构 | 描述 |
|---|---|
| B+Tree 索引 | 最常见的索引类型,大部分引擎都支持 B+ 树索引 |
| Hash 索引 | 底层数据结构是用哈希表实现的,只有精确匹配索引列的查询才有效,不支持范围查询 |
| R-tree (空间索引) | 空间索引是 MyISAM 引擎的一个特殊索引类型,主要用于地理空间数据类型,通常使用较少 |
| Full-text (全文索引) | 是一种通过建立倒排索引,快速匹配文档的方式。类似于Lucene,Solr,ES |
不同的存储引擎对于索引结构的支持情况:
| 索引 | InnoDB | MyISAM | Memory |
|---|---|---|---|
| B+tree 索引 | 支持 | 支持 | 支持 |
| Hash 索引 | 不支持 | 不支持 | 支持 |
| R-tree 索引 | 不支持 | 支持 | 不支持 |
| Full-text | 5.6 版本之后支持 | 支持 | 不支持 |
注意:
我们平常所说的索引,如果没有特别指明,都是指 B+ 树结构组织的索引
4、索引结构
1)二叉树
在讲 B-Tree 之前,我们先讲一下二叉树
假如说 MySQL 的索引结构采用二叉树的数据结构,比较理想的结构如下:
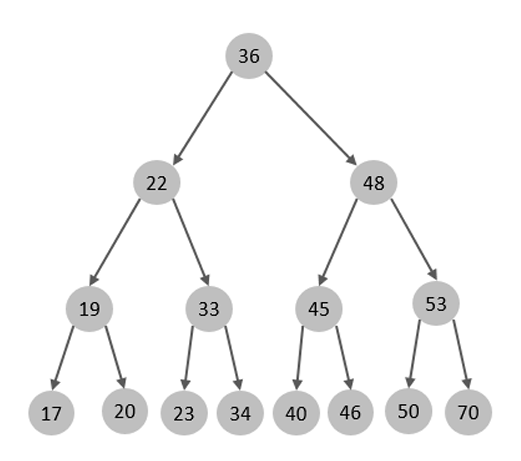
如果主键是顺序插入的,则会形成一个单向链表,结构如下:
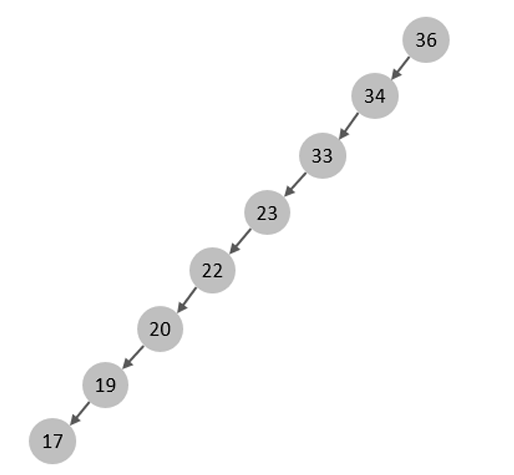
所以,如果选择二叉树作为索引结构,会存在以下缺点:
- 顺序插入时,会形成一个链表,查询性能大大降低
- 大数据量情况下,层级较深,检索速度慢
此时大家可能会想到,我们可以选择红黑树,红黑树是一颗自平衡二叉树,那这样即使是顺序插入数据,最终形成的数据结构也是一颗平衡的二叉树,结构如下:
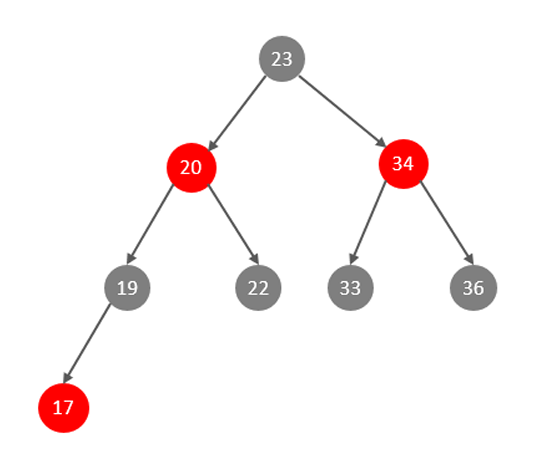
但是,即使如此,由于红黑树也是一颗二叉树,所以也会存在一个缺点:
- 大数据量情况下,层级较深,检索速度慢
所以,在 MySQL 的索引结构中,并没有选择二叉树或者红黑树,而选择的是 B+Tree
2)B-Tree
在详解 B+Tree 之前,先来介绍一个 B-Tree
B-Tree,B 树是一种多路平衡查找树,相对于二叉树,B 树每个节点可以有多个分支,即多叉
以一颗最大度数(max-degree,树的度数指的是一个节点的子节点个数)为 5(5阶)的 b-tree 为例,那这个 B 树每个节点最多存储 4 个 key,5 个指针:
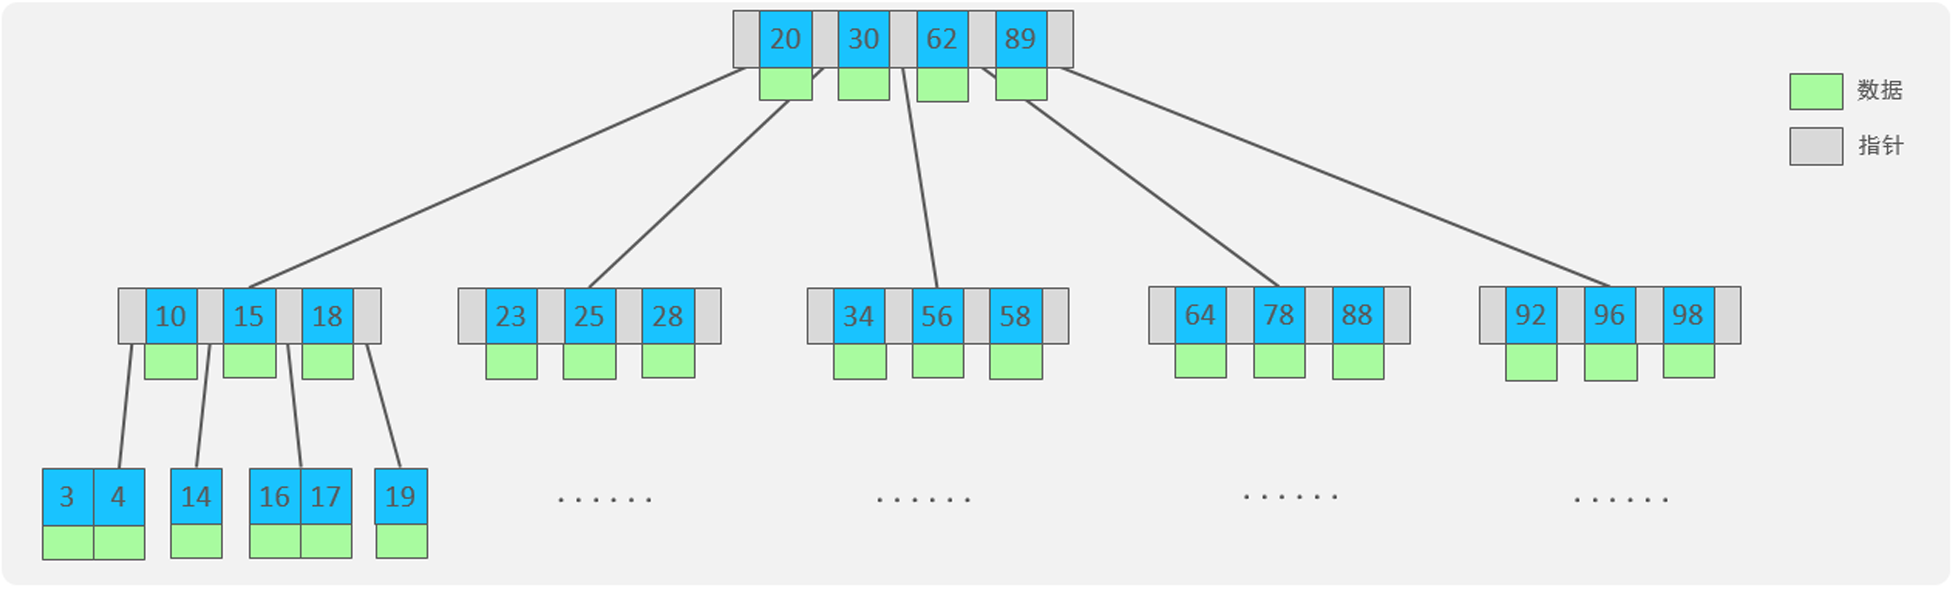
我们可以通过一个数据结构可视化的网站来简单演示一下:B-Trees
设置 Max.Degree = 5,然后插入一组数据:
100 65 169 368 900 556 780 35 215 1200 234 888 158 90 1000 88 120 268 250
观察一些数据插入过程中,节点的变化情况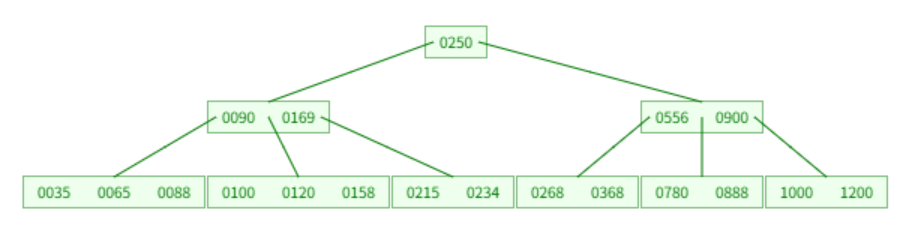
特点:
- 5 阶的 B 树,每一个节点最多存储 4 个 key,对应 5 个指针
- 一旦节点存储的 key 数量到达 5,就会裂变,中间元素向上分裂
- 在 B 树中,非叶子节点和叶子节点都会存放数据
3)B+Tree
B+Tree 是 B-Tree 的变种,我们以一颗最大度数(max-degree)为 4(4阶)的 b+tree 为例,来看一下其结构示意图:
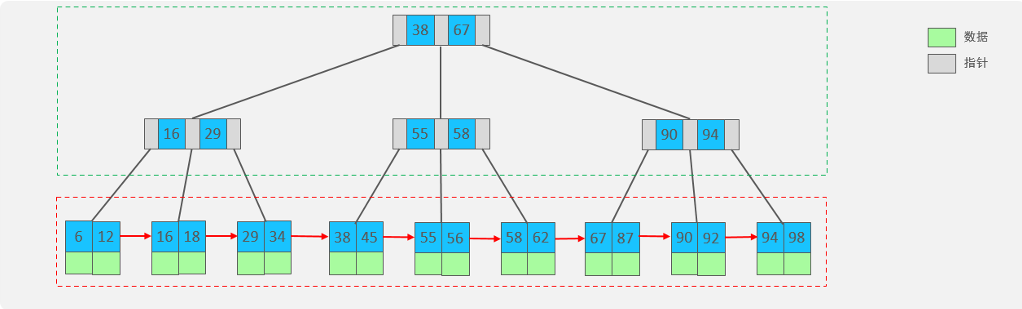
我们可以看到两部分:
- 绿色框框起来的部分,是索引部分,仅仅起到索引数据的作用,不存储数据
- 红色框框起来的部分,是数据存储部分,在其叶子节点中要存储具体的数据
通过一个数据结构可视化网站演示:B+ Trees
设置 Max.Degree = 5,然后插入一组数据:
100 65 169 368 900 556 780 35 215 1200 234 888 158 90 1000 88 120 268 250
观察一些数据插入过程中,节点的变化情况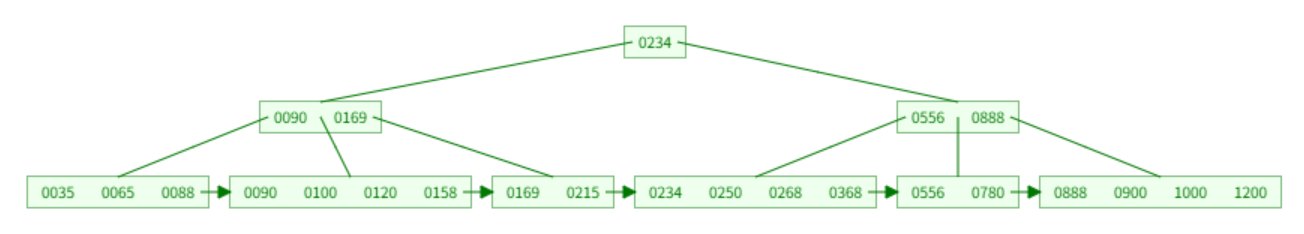
最终我们看到,B+Tree 与 B-Tree 相比,主要有以下三点区别:
- 所有的数据都会出现在叶子节点
- 叶子节点形成一个单向链表
- 非叶子节点仅仅起到索引数据作用,具体的数据都是在叶子节点存放的
4)MySQL 中的 B+Tree
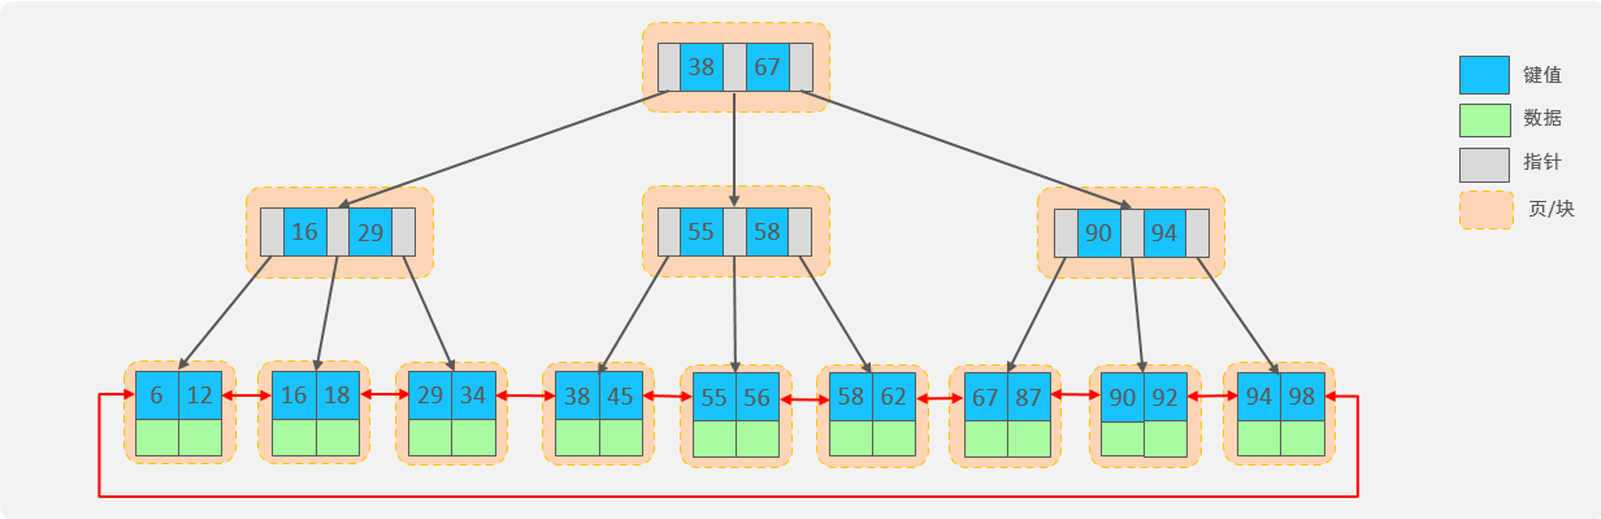
MySQL 索引数据结构对经典的 B+Tree 进行了优化。在原 B+Tree 的基础上,增加一个指向相邻叶子节点的链表指针,就形成了带有顺序指针的 B+Tree,提高区间访问的性能,利于排序
5)Hash 索引
1)结构
哈希索引就是采用一定的 hash 算法,将键值换算成新的 hash 值,映射到对应的槽位上,然后存储在 hash 表中
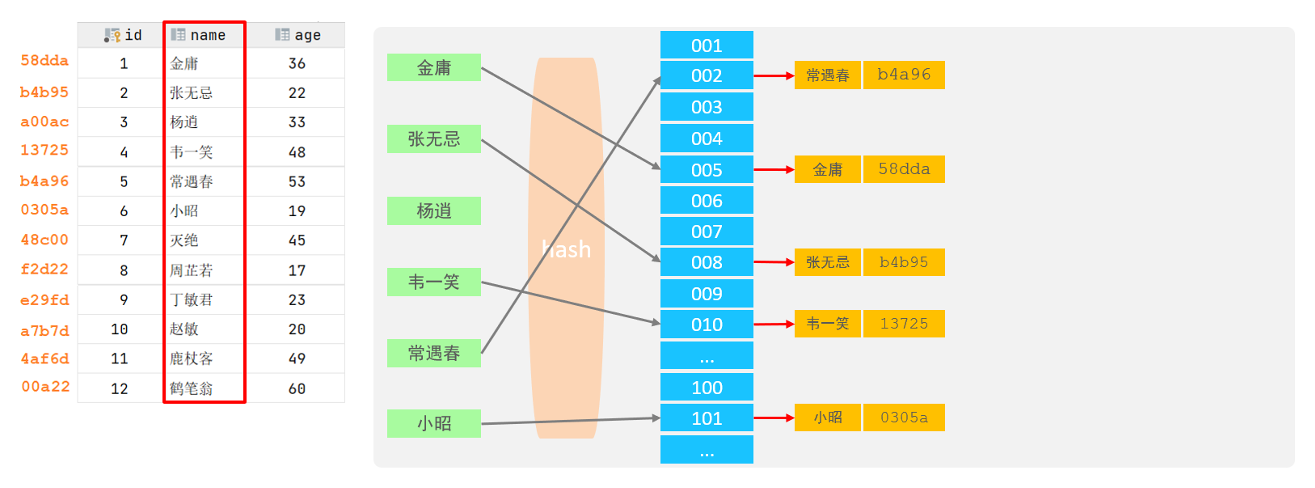
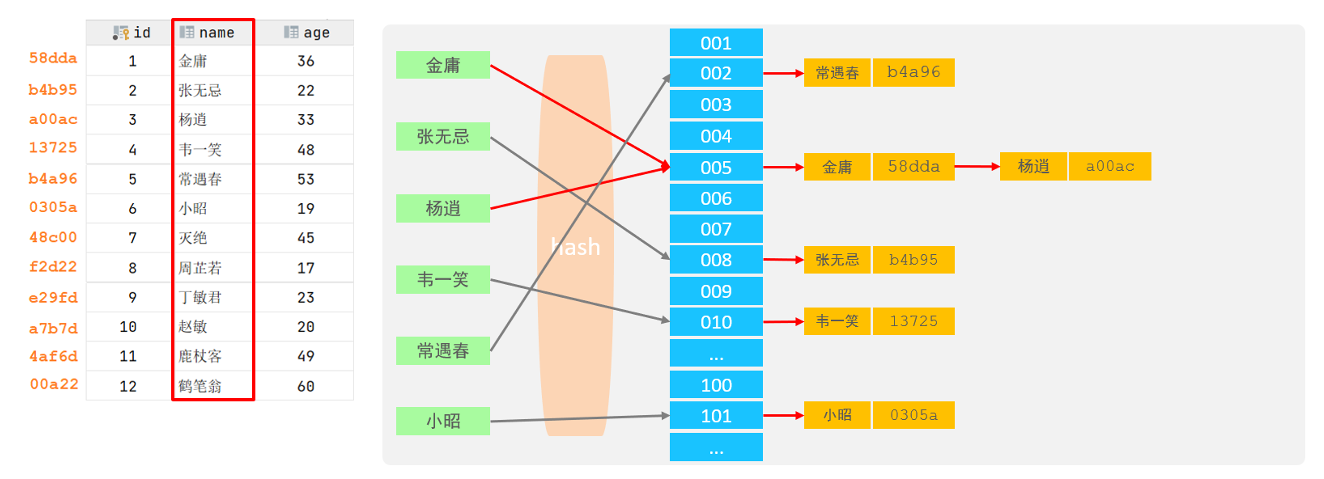
如果两个(或多个)键值,映射到一个相同的槽位上,他们就产生了 hash 冲突(也称为 hash 碰撞),可以通过链表来解决
2)特点
- Hash 索引只能用于对等比较(=,in),不支持范围查询(between,>,<,…)
- 无法利用索引完成排序操作
- 查询效率高,通常(不存在 hash 冲突的情况)只需要一次检索就可以了,效率通常要高于 B+tree 索引
3)存储引擎支持
在 MySQL 中,支持 hash 索引的是 Memory 存储引擎
而 InnoDB 中具有自适应 hash 功能,hash 索引是 InnoDB 存储引擎根据 B+Tree 索引在指定条件下自动构建的
思考题:为什么 InnoDB 存储引擎选择使用 B+tree 索引结构?
A.相对于二叉树,层级更少,搜索效率高
B.对于 B-tree,无论是叶子节点还是非叶子节点,都会保存数据,这样导致一页中存储的键值减少,指针跟着减少,要同样保存大量数据,只能增加树的高度,导致性能降低
C.相对 Hash 索引,B+tree 支持范围匹配及排序操作
5、索引分类
(1)分类
在 MySQL 数据库,将索引的具体类型主要分为以下几类:
| 分类 | 含义 | 特点 | 关键字 |
|---|---|---|---|
| 主键索引 | 针对于表中主键创建的索引 | 默认自动创建,只能有一个 | PRIMARY |
| 唯一索引 | 避免同一个表中某数据列中的值重复 | 可以有多个 | UNIQUE |
| 常规索引 | 快速定位特定数据 | 可以有多个 | |
| 全文索引 | 全文索引查找的是文本中的关键词,而不是比较索引中的值 | 可以有多个 | FULLTEXT |
(2)聚集索引&二级索引
在 InnoDB 存储引擎中,根据索引的存储形式,又可以分为以下两种:
| 分类 | 含义 | 特点 |
|---|---|---|
| 聚集索引(Clustered Index) | 将数据存储与索引放到了一块,索引结构的叶子节点保存了行数据 | 必须有,只有一个 |
| 二级索引(Secondary Index) | 将数据与索引分开存储,索引结构的叶子节点关联的是对应的主键 | 可以存在多个 |
二级索引又称辅助索引或者非聚集索引
聚集索引选取规则:
-
如果存在主键,主键索引就是聚集索引
-
如果不存在主键,将使用第一个唯一(UNIQUE)索引作为聚集索引
-
如果表没有主键,或没有合适的唯一索引,则 InnoDB 会自动生成一个 rowid 作为隐藏的聚集索引
聚集索引和二级索引的具体结构如下:
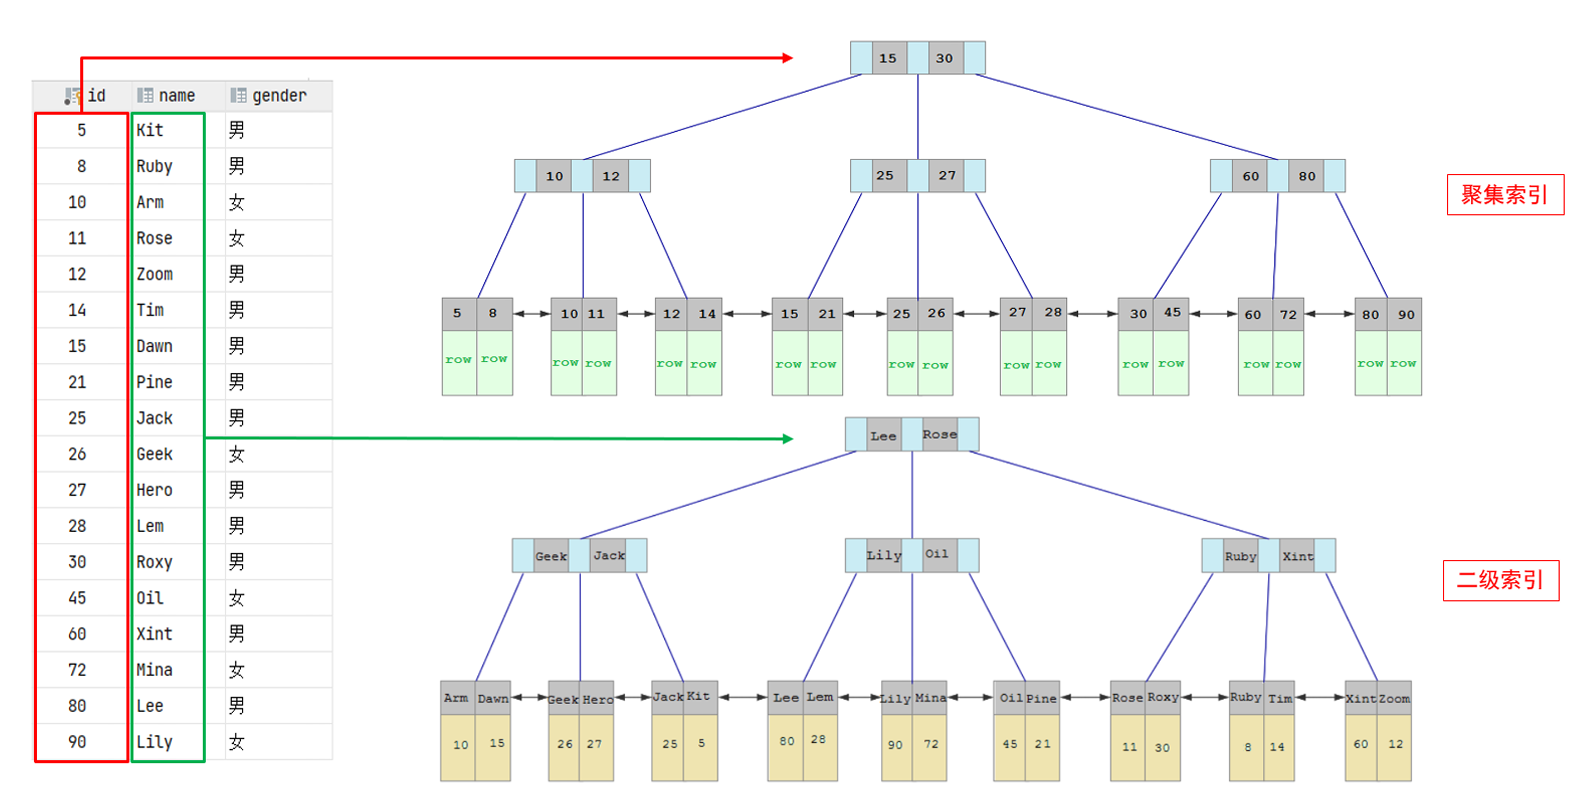
- 聚集索引的叶子节点下挂的是这一行的数据
- 二级索引的叶子节点下挂的是该字段值对应的主键值
当我们执行如下的 SQL 语句时:
select * from user where name = 'Arm';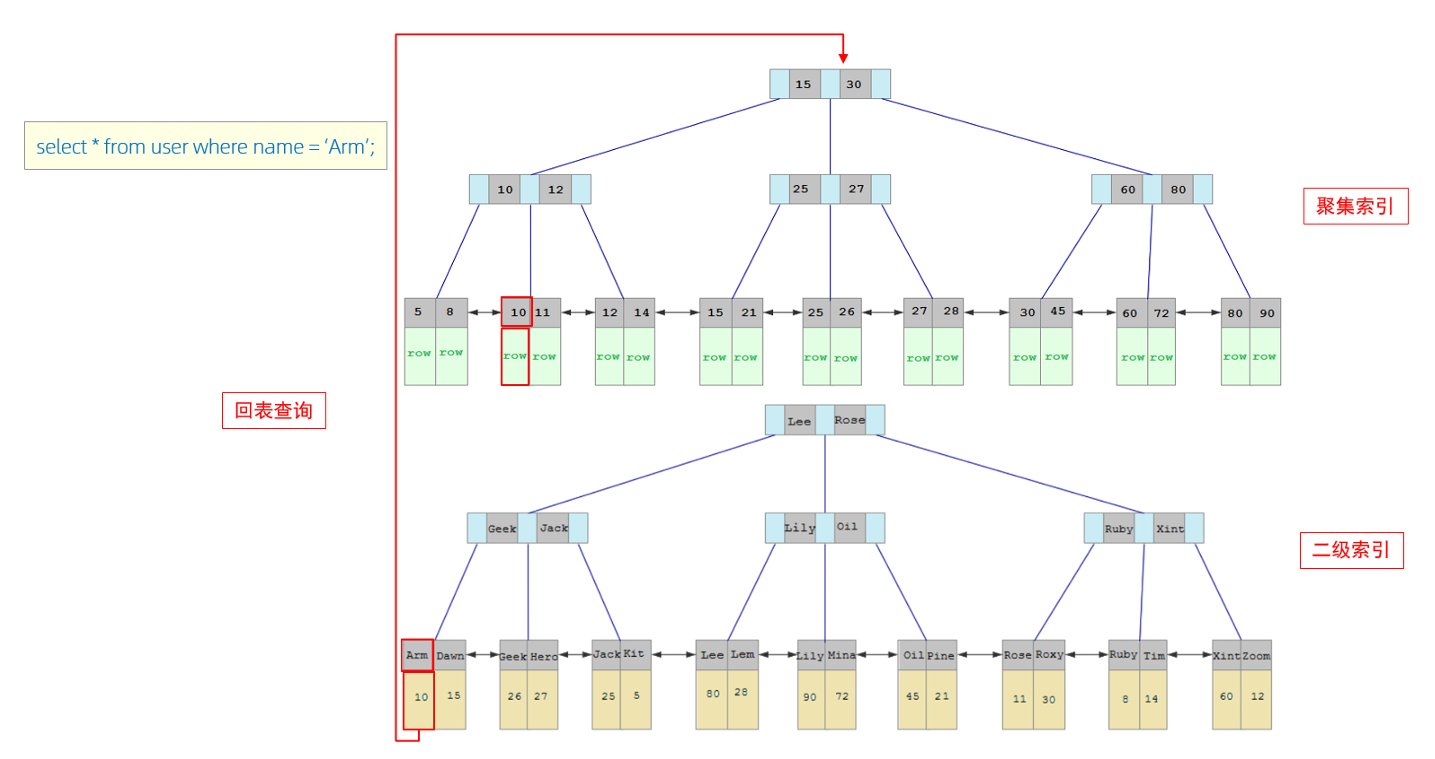
具体过程如下:
①.由于是根据 name 字段进行查询,所以先根据 name=‘Arm’ 到 name 字段的二级索引中进行匹配查找。但是在二级索引中只能查找到 Arm 对应的主键值 10
②.由于查询返回的数据是 *,所以此时,还需要根据主键值 10,到聚集索引中查找 10 对应的记录,最终找到 10 对应的行 row
③.最终拿到这一行的数据,直接返回即可
这个过程有一个专有名词:
回表查询这种先到二级索引中查找数据,找到主键值,然后再到聚集索引中根据主键值,获取数据的方式,就称之为回表查询
思考题:
以下两条 SQL 语句,那个执行效率高?为什么?
A. select * from user where id = 10 ;
B. select * from user where name = ‘Arm’ ;
备注:id 为主键,name 字段创建的有索引
解答:
A 语句的执行性能要高于 B 语句。 因为A语句直接走聚集索引,直接返回数据。 而 B 语句需要先查询 name 字段的二级索引,然后再查询聚集索引,也就是需要进行回表查询
思考题:
InnoDB 主键索引的 B+tree 高度为多高呢?
假设: 一行数据大小为 1k,一页中可以存储 16 行这样的数据。InnoDB 的指针占用 6 个字节的空间,主键即使为 bigint,占用字节数为 8
若高度为 2: n * 8 + (n + 1) * 6 = 16 * 1024,算出 n 约为 1170 1171* 16 = 18736 也就是说,如果树的高度为 2,则可以存储 18000 多条记录
若高度为 3: 1171 * 1171 * 16 = 21939856 也就是说,如果树的高度为 3,则可以存储 2200w 左右的记录
6、索引语法
(1)创建索引
CREATE [ UNIQUE | FULLTEXT ] INDEX index_name ON table_name ( index_col_name,... );- 一个索引只包含单个列 → 单列索引
- 一个索引包含多个列 → 联合(复合)索引
(2)查看索引
SHOW INDEX FROM table_name ;
# 或
SHOW INDEX FROM table_name\G ;
(3)删除索引
DROP INDEX index_name ON table_name ;(4)案例
先来创建一张表 tb_user,并且查询测试数据,数据准备详见文末:数据准备—索引语法部分
A. name 字段为姓名字段,该字段的值可能会重复,为该字段创建索引
CREATE INDEX idx_user_name ON tb_user(name);index_name 一般为 idx_ 表名_ 字段名
B. phone 手机号字段的值,是非空,且唯一的,为该字段创建唯一索引
CREATE UNIQUE INDEX idx_user_phone ON tb_user(phone);C. 为 profession、age、status 创建联合索引
CREATE INDEX idx_user_pro_age_sta ON tb_user(profession, age, status);D. 为 email 建立合适的索引来提升查询效率
CREATE INDEX idx_email ON tb_user(email);E. 删除 idx_email 索引
DROP INDEX idx_email ON tb_user;7、SQL 性能分析
(1)SQL 执行频率
MySQL 客户端连接成功后,通过 show [session|global] status 命令可以提供服务器状态信息。通过如下指令,可以查看当前数据库的 INSERT、UPDATE、DELETE、SELECT 的访问频次:
-- session 是查看当前会话
-- global 是查询全局数据
SHOW GLOBAL STATUS LIKE 'Com_______';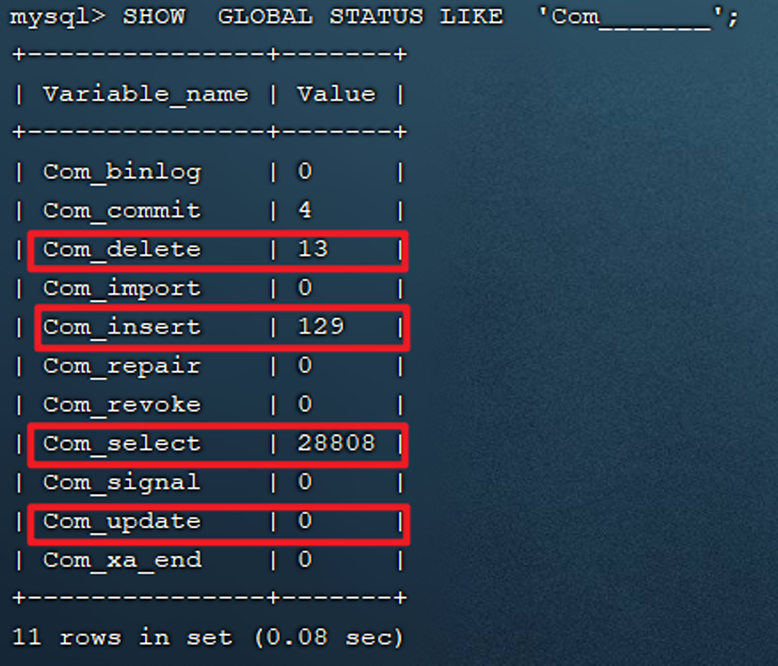
- Com_delete:删除次数
- Com_insert:插入次数
- Com_select:查询次数
- Com_update:更新次数
通过上述指令,我们可以查看到当前数据库到底是以查询为主,还是以增删改为主,从而为数据库优化提供参考依据:
- 如果是以增删改为主,我们可以考虑不对其进行索引的优化
- 如果是以查询为主,那么就要考虑对数据库的索引进行优化了
(2)慢查询日志
慢查询日志记录了所有执行时间超过指定参数(long_query_time,单位:秒,默认10秒)的所有 SQL 语句的日志
MySQL 的慢查询日志默认没有开启,我们可以查看一下系统变量 slow_query_log
show variables like 'slow_query_log';如果要开启慢查询日志,需要在 MySQL 的配置文件(/etc/my.cnf)中配置如下信息:
# 开启 MySQL 慢日志查询开关
slow_query_log=1
# 设置慢日志的时间为 2 秒,SQL 语句执行时间超过 2 秒,就会视为慢查询,记录慢查询日志
long_query_time=2
配置完毕之后,通过以下指令重新启动 MySQL 服务器进行测试,查看慢日志文件中记录的信息 /var/lib/mysql/localhost-slow.log
systemctl restart mysqld此时慢查询日志就已经打开了,我们可以通过如下命令实时显示日志内容:
tail -f localhost-slow.log(3)profile详情
show profiles 能够在做 SQL 优化时帮助我们了解时间都耗费到哪里去了。通过 have_profiling 参数,能够看到当前 MySQL 是否支持 profile 操作:
SELECT @@have_profiling ;通过 set 语句在 session / global 级别开启 profiling:
SET profiling = 1;接下来我们所执行的 SQL 语句,都会被 MySQL 记录,并记录执行时间消耗到哪儿去了
我们直接执行如下的 SQL 语句:
select * from tb_user;
select * from tb_user where id = 1;
select * from tb_user where name = '白起';
select count(*) from tb_sku;
执行一系列的业务 SQL 的操作,然后通过如下指令查看指令的执行耗时:
-- 查看每一条 SQL 的耗时基本情况
show profiles;

-- 查看指定 query_id 的 SQL 语句各个阶段的耗时情况
show profile for query query_id;

-- 查看指定 query_id 的 SQL 语句 CPU 的使用情况
show profile cpu for query query_id;
(4)explain 执行计划
EXPLAIN 或者 DESC 命令获取 MySQL 如何执行 SELECT 语句的信息,包括在 SELECT 语句执行过程中表如何连接和连接的顺序
语法:
-- 直接在select语句之前加上关键字 explain / desc
EXPLAIN SELECT 字段列表 FROM 表名 WHERE 条件;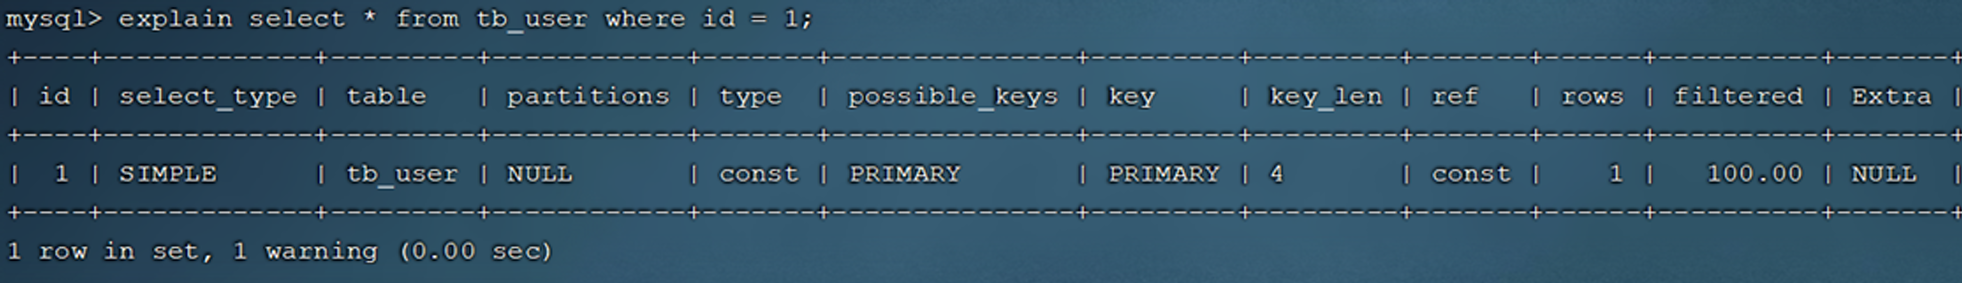
Explain 执行计划中各个字段的含义:
| 字段 | 含义 |
|---|---|
| id | select 查询的序列号,表示查询中执行 select 子句或者是操作表的顺序(id 相同,执行顺序从上到下;id 不同,值越大,越先执行) |
| select_type | 表示 SELECT 的类型,常见的取值有 SIMPLE(简单表,即不使用表连接或者子查询)、PRIMARY(主查询,即外层的查询)、UNION(UNION 中的第二个或者后面的查询语句)、SUBQUERY(SELECT / WHERE 之后包含了子查询)等 |
| type | 表示连接类型,性能由好到差的连接类型为 NULL、system、const、eq_ref、ref、range、index、all |
| possible_key | 显示可能应用在这张表上的索引,一个或多个 |
| key | 实际使用的索引,如果为 NULL,则没有使用索引 |
| key_len | 表示索引中使用的字节数,该值为索引字段最大可能长度,并非实际使用长度,在不损失精确性的前提下,长度越短越好 |
| rows | MySQL 认为必须要执行查询的行数,在 innodb 引擎的表中,是一个估计值,可能并不总是准确的 |
| filtered | 表示返回结果的行数占需读取行数的百分比,filtered 的值越大越好 |
explain select * from student s where s.id in (select studentid from student_course sc where sc.courseid = (select id from course c where c.name = 'MySQL'));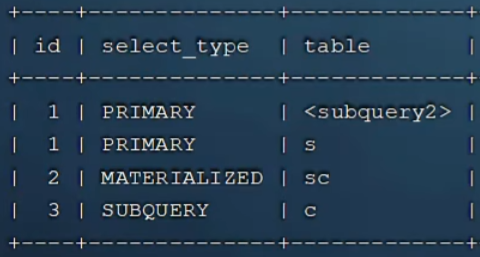
8、索引使用规则
(1)最左前缀法则
如果索引了多列(联合索引),要遵守最左前缀法则。最左前缀法则指的是查询从索引的最左列开始,并且不跳过索引中的列
如果跳跃某一列,索引将会部分失效(后面的字段索引失效)
以 tb_user 表为例,我们先来查看一下之前 tb_user 表所创建的索引:
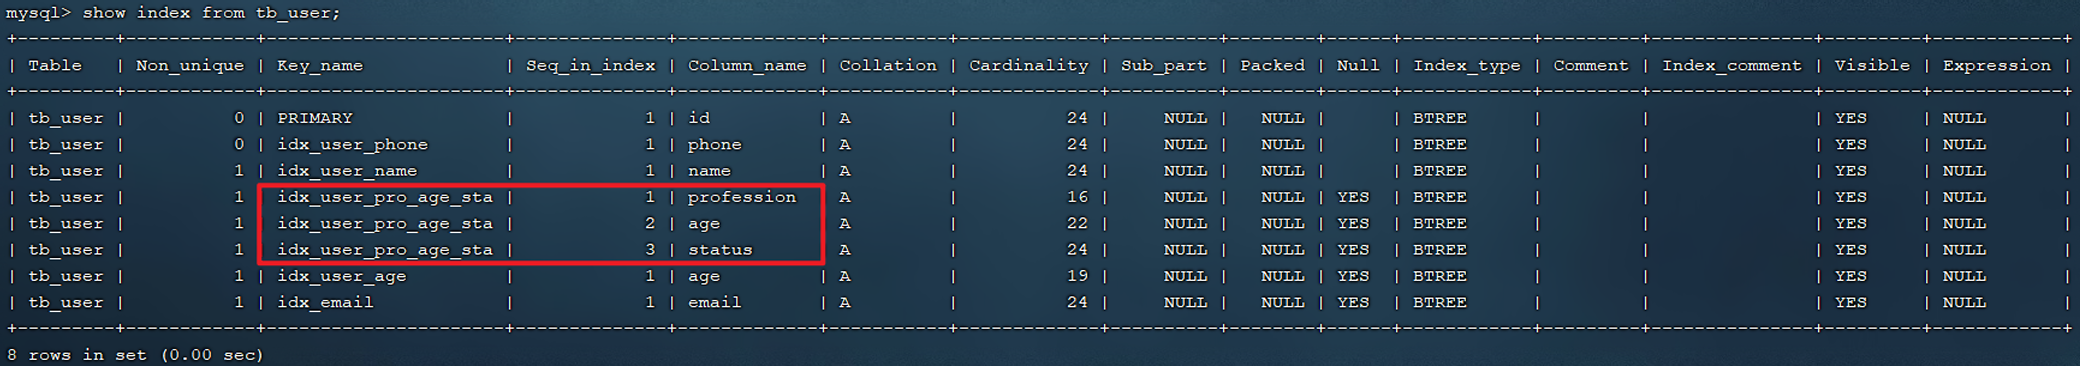
在 tb_user 表中,有一个联合索引,这个联合索引涉及到三个字段,顺序分别为:profession,age,status
对于最左前缀法则指的是,查询时,最左变的列,也就是 profession 必须存在,否则索引全部失效。而且中间不能跳过某一列,否则该列后面的字段索引将失效
案例:
explain select * from tb_user where profession = '软件工程' and age = 31 and status = '0';
explain select * from tb_user where profession = '软件工程' and age = 31;
explain select * from tb_user where profession = '软件工程';
以上的这三组测试中,只要联合索引最左边的字段 profession 存在,索引就会生效,只不过索引的长度不同。由以上三组测试,我们也可以推测出 profession 字段索引长度为 47、age 字段索引长度为 2、status 字段索引长度为 5
explain select * from tb_user where age = 31 and status = '0';
explain select * from tb_user where status = '0';
上面的这两组测试,索引并未生效,原因是因为不满足最左前缀法则,联合索引最左边的列 profession 不存在
explain select * from tb_user where profession = '软件工程' and status = '0';上述的 SQL 查询时,存在 profession 字段,最左边的列是存在的,索引满足最左前缀法则的基本条件。但是查询时,跳过了 age 这个列,所以后面的列索引是不会使用的,也就是索引部分生效,所以索引的长度就是 47
思考题:
当执行下列 SQL 语句时
explain select * from tb_user where age = 31 and status = '0' and profession = '软件工程';是否满足最左前缀法则,走不走上述的联合索引,索引长度?
答案:
完全满足最左前缀法则的,索引长度 54,联合索引是生效的
注意:
最左前缀法则中指的最左边的列,是指在查询时,联合索引的最左边的字段(即是第一个字段)必须存在,与我们编写 SQL 时,条件编写的先后顺序无关
(2)范围查询
联合索引中,出现范围查询(>,<),范围查询右侧的列索引失效
explain select * from tb_user where profession = '软件工程' and age > 30 and status = '0';当范围查询使用 > 或 < 时,走联合索引了,但是索引的长度为 49,就说明范围查询右边的 status 字段是没有走索引的
explain select * from tb_user where profession = '软件工程' and age >= 30 and status = '0';当范围查询使用 >= 或 <= 时,走联合索引了,但是索引的长度为 54,就说明所有的字段都是走索引的
所以,在业务允许的情况下,尽可能的使用类似于 >= 或 <= 这类的范围查询,而避免使用 > 或 <
(3)索引失效情况
1)索引列运算
不要在索引列上进行运算操作,索引将失效
如在 tb_user 表中,有一个 phone 字段的单列索引
A. 当根据 phone 字段进行等值匹配查询时,索引生效
explain select * from tb_user where phone = '17799990015';B. 当根据 phone 字段进行函数运算操作之后,索引失效
explain select * from tb_user where substring(phone,10,2) = '15';2)字符串不加引号
字符串类型字段使用时,不加引号,索引将失效
explain select * from tb_user where phone = '17799990015';
explain select * from tb_user where phone = 17799990015;
经过上面两组示例,我们会发现:如果字符串不加单引号,对于查询结果没什么影响,但是数据库存在隐式类型转换,索引将失效
3)模糊查询
如果仅仅是尾部模糊匹配,索引不会失效。如果是头部模糊匹配,索引失效
explain select * from tb_user where profession like '软件%';
explain select * from tb_user where profession like '%工程';
explain select * from tb_user where profession like '%工%';
经过上述的测试,我们发现:在 like 模糊查询中,在关键字后面加 %,索引可以生效。而如果在关键字前面加了 %,索引将会失效
4)or 连接条件
用 or 分割开的条件,如果 or 前的条件中的列有索引,而后面的列中没有索引,那么涉及的索引都不会被用到
explain select * from tb_user where id = 10 or age = 23;由于 age 没有索引,所以即使 id 有索引,索引也会失效。所以需要针对于 age 也要建立索引:
create index idx_user_age on tb_user(age);5)数据分布影响
如果 MySQL 评估使用索引比全表更慢,则不使用索引
select * from tb_user where phone >= '17799990005';          # 走索引
select * from tb_user where phone >= '17799990015';          # 不走索引
MySQL 在查询时,会评估使用索引的效率与走全表扫描的效率,如果走全表扫描更快,则放弃使用索引,走全表扫描。因为索引是用来索引少量数据的,如果通过索引查询返回大批量的数据,则还不如走全表扫描来的快,此时索引就会失效
(4)SQL 提示
SQL 提示,是优化数据库的一个重要手段,简单来说,就是在 SQL 语句中加入一些人为的提示来达到优化操作的目的
我们在查询的时候可以借助于 MySQL 的 SQL 提示来指定使用哪个索引
1)use index
建议 MySQL 使用哪一个索引完成此次查询(仅仅是建议,mysql 内部还会再次进行评估)
explain select * from tb_user use index(idx_user_pro) where profession = '软件工程';2)ignore index
忽略指定的索引
explain select * from tb_user ignore index(idx_user_pro) where profession = '软件工程';3)force index
强制使用索引
explain select * from tb_user force index(idx_user_pro) where profession = '软件工程';示例:
explain select * from tb_user use index(idx_user_pro) where profession = '软件工程';
explain select * from tb_user ignore index(idx_user_pro) where profession = '软件工程';
(5)覆盖索引 & 回表查询
覆盖索引:查询使用了索引,并且需要返回的列,在该索引中已经全部能够找到
尽量使用覆盖索引,减少 select *
接下来,我们来看一组 SQL 的执行计划,看看执行计划的差别,然后再来具体做一个解析
explain select id, profession from tb_user where profession = '软件工程' and age = 31 and status = '0' ;
explain select id,profession,age, status from tb_user where profession = '软件工程' and age = 31 and status = '0' ;
explain select id,profession,age, status, name from tb_user where profession = '软件工程' and age = 31 and status = '0' ;
explain select * from tb_user where profession = '软件工程' and age = 31 and status = '0';
从上述的执行计划我们可以看到,这四条 SQL 语句的执行计划前面所有的指标都是一样的,看不出来差异。但是此时,我们主要关注的是后面的 Extra,前面两条 SQL 的结果为 Using where; Using Index ; 而后面两条SQL的结果为 Using index condition
| Extra | 含义 |
|---|---|
| Using where; Using Index | 查找使用了索引,但是需要的数据都在索引列中能找到,所以不需要回表查询数据 |
| Using index condition | 查找使用了索引,但是需要回表查询数据 |
因为,在 tb_user 表中有一个联合索引 idx_user_pro_age_sta,该索引关联了三个字段 profession、age、status,而这个索引也是一个二级索引,所以叶子节点下面挂的是这一行的主键 id。 所以当我们查询返回的数据在 id、profession、age、status 之中,则直接走二级索引直接返回数据了。 如果超出这个范围,就需要拿到主键 id,再去扫描聚集索引,再获取额外的数据了,这个过程就是回表。 而我们如果一直使用 select * 查询返回所有字段值,很容易就会造成回表查询(除非是根据主键查询,此时只会扫描聚集索引)
为了更清楚的理解什么是覆盖索引,什么是回表查询,我们一起来看下面的这组 SQL 的执行过程:
A. 表结构及索引示意图:
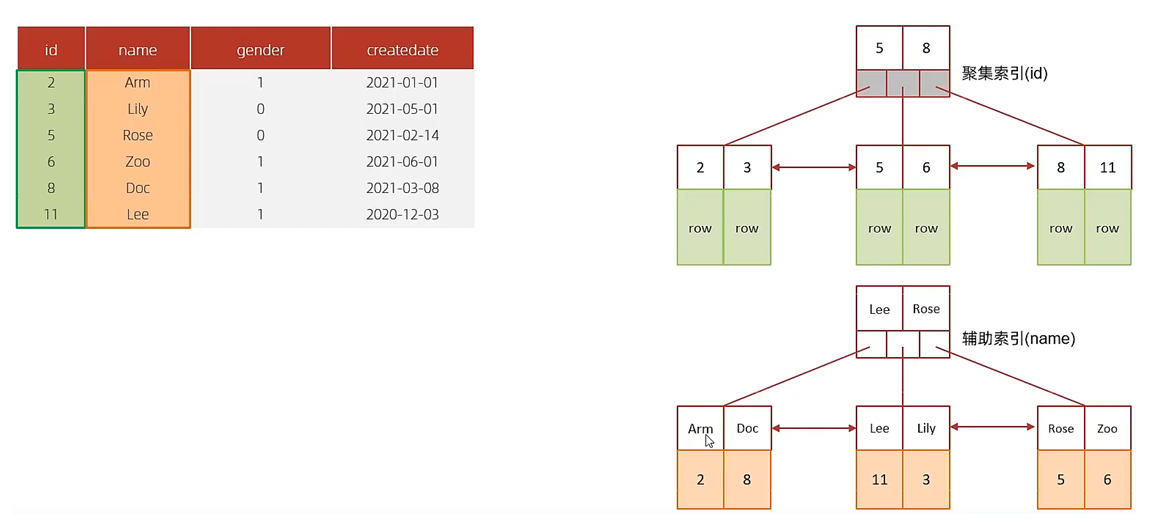
id 是主键,是一个聚集索引。 name 字段建立了普通索引,是一个二级索引(辅助索引)
B. 执行 SQL: select * from tb_user where id = 2;
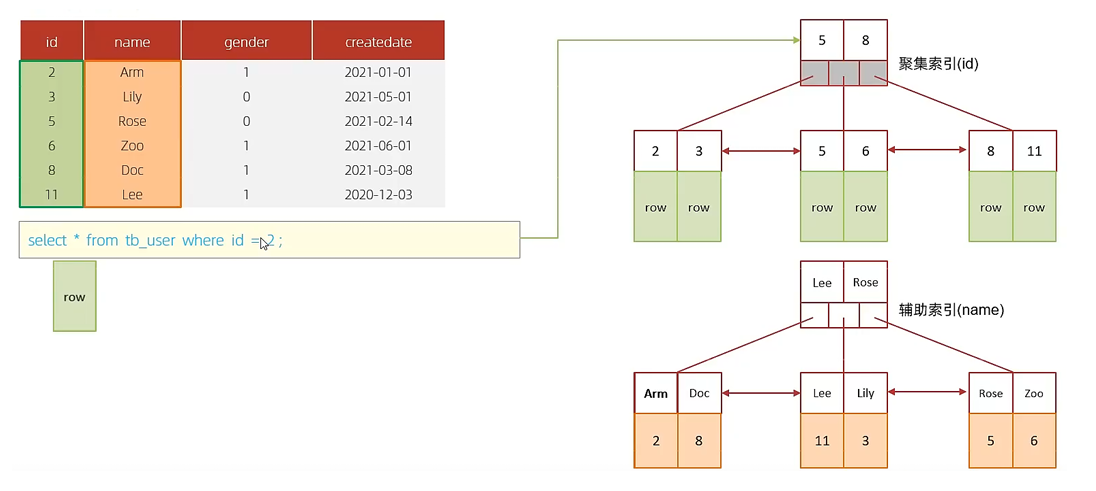
根据 id 查询,直接走聚集索引查询,一次索引扫描,直接返回数据,性能高
C. 执行 SQL: select id,name from tb_user where name = 'Arm';
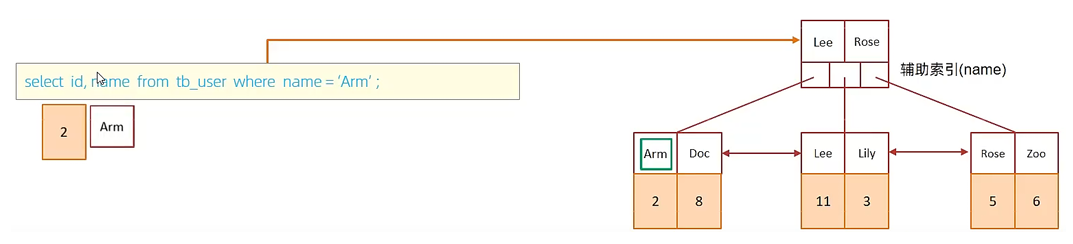
虽然是根据 name 字段查询,查询二级索引,但是由于查询返回在字段为 id,name,在 name 的二级索引中,这两个值都是可以直接获取到的,因为覆盖索引,所以不需要回表查询,性能高
D. 执行 SQL: select id,name,gender from tb_user where name = 'Arm';
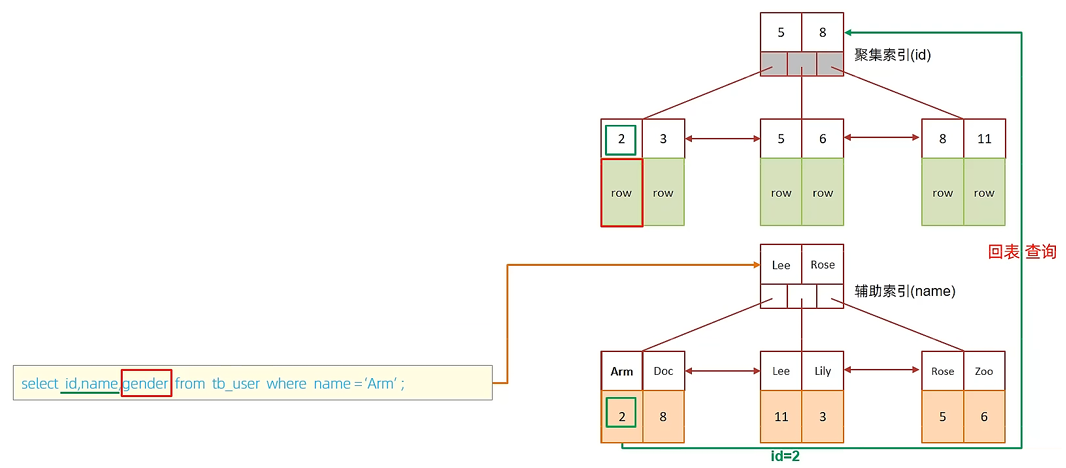
由于在 name 的二级索引中,不包含 gender,所以需要两次索引扫描,也就是需要回表查询,性能相对较差一点
思考题:
一张表,有四个字段(id, username, password, status),由于数据量大,需要对以下 SQL 语句进行优化,该如何进行才是最优方案?
select id,username,password from tb_user where username = 'itcast';答案:
针对于 username, password 建立联合索引,sql 为:
create index idx_user_name_pass on tb_user(username,password);这样可以避免上述的 SQL 语句,在查询的过程中出现回表查询
(6)前缀索引
当字段类型为字符串(varchar,text,longtext 等)时,有时候需要索引很长的字符串,这会让索引变得很大,查询时,浪费大量的磁盘 IO,影响查询效率
此时可以只将字符串的一部分前缀,建立索引,这样可以大大节约索引空间,从而提高索引效率
1)语法
create index idx_xxxx on table_name(column(n));2)前缀长度
可以根据索引的选择性来决定,而选择性是指不重复的索引值(基数)和数据表的记录总数的比值,索引选择性越高则查询效率越高,唯一索引的选择性是 1,这是最好的索引选择性,性能也是最好的
select count(distinct email) / count(*) from tb_user ;
# 求选择性: 1
select count(distinct substring(email,1,10)) / count(*) from tb_user ;
# 截取前 10 个字符的选择性: 1
select count(distinct substring(email,1,5)) / count(*) from tb_user ;
# 截取前 5 个字符的选择性: 0.9583
select count(distinct substring(email,1,4)) / count(*) from tb_user ;
# 截取前 4 个字符的选择性: 0.9167
根据实际业务选择:
-
如果尽可能选择性高:截取前 10 个字符
create index idx_email_10 on tb_user(email(10)); -
如果需要平衡选择性与索引体积:截取前 5 个字符
create index idx_email_5 on tb_user(email(5));
3) 前缀索引的查询流程
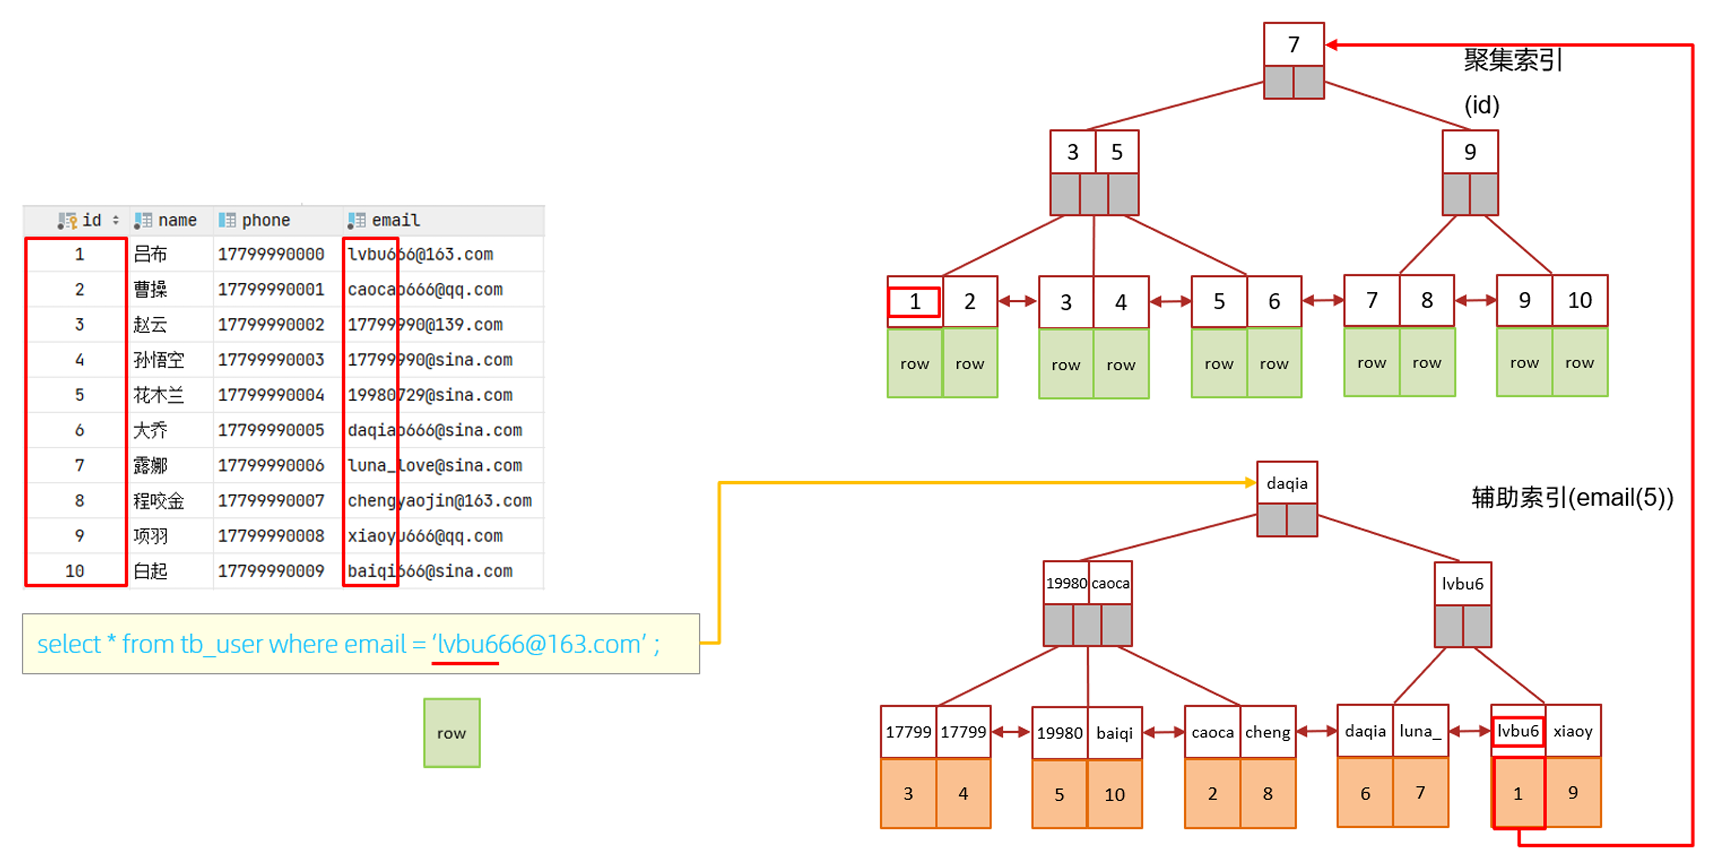
(7)单列 & 联合索引
- 单列索引:即一个索引只包含单个列
- 联合索引:即一个索引包含了多个列
在业务场景中,如果存在多个查询条件,考虑针对于查询字段建立索引时,建议建立联合索引,而非单列索引
如果查询使用的是联合索引,具体的结构示意图如下:
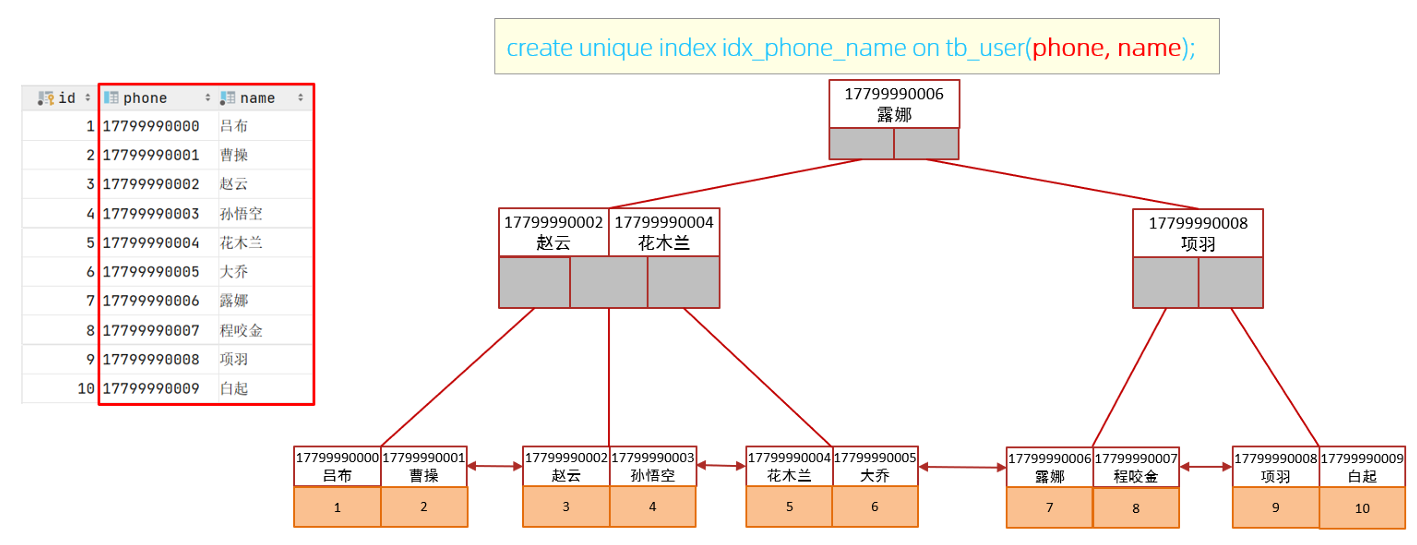
9、索引设计原则
- 针对数据量较大(超过一百万),且查询比较频繁的表建立索引
- 针对于常作为查询条件(where)、排序(order by)、**分组(group by)**操作的字段建立索引
- 尽量选择区分度高的列作为索引,尽量建立唯一索引,区分度越高,使用索引的效率越高
- 如果是字符串类型的字段,字段的长度较长,可以针对于字段的特点,建立前缀索引
- 尽量使用联合索引,减少单列索引,查询时,联合索引很多时候可以覆盖索引,节省存储空间,避免回表,提高查询效率
- 要控制索引的数量,索引并不是多多益善,索引越多,维护索引结构的代价也就越大,会影响增删改的效率
- 如果索引列不能存储 NULL 值,请在创建表时使用 NOT NULL 约束它。当优化器知道每列是否包含 NULL 值时,它可以更好地确定哪个索引最有效地用于查询
九、MySQL 进阶之 —— SQL优化
1、插入数据优化
(1)insert
如果我们需要一次性往数据库表中插入多条记录,可以从以下三个方面进行优化
insert into tb_test values(1,'tom');
insert into tb_test values(2,'cat');
insert into tb_test values(3,'jerry');
......
1)优化方案一
批量插入数据
Insert into tb_test values(1,'Tom'),(2,'Cat'),(3,'Jerry');一次性插入的数据不建议超过 1000 条
2)优化方案二
手动控制事务
start transaction;
insert into tb_test values(1,'Tom'),(2,'Cat'),(3,'Jerry');
insert into tb_test values(4,'Tom'),(5,'Cat'),(6,'Jerry');
insert into tb_test values(7,'Tom'),(8,'Cat'),(9,'Jerry');
commit;
3)优化方案三
主键顺序插入,性能要高于乱序插入
主键乱序插入 : 8 1 9 21 88 2 4 15 89 5 7 3
主键顺序插入 : 1 2 3 4 5 7 8 9 15 21 88 89
(2)大批量插入数据
如果一次性需要插入大批量数据(比如:几百万的记录),使用 insert 语句插入性能较低,此时可以使用 MySQL 数据库提供的 load 指令进行插入
可以执行如下指令,将数据脚本文件中的数据加载到表结构中:
-- 客户端连接服务端时,加上参数 --local-infile
mysql --local-infile -u root -p

-- 设置全局参数 local_infile 为 1,开启从本地加载文件导入数据的开关
set global local_infile = 1;

-- 执行 load 指令将准备好的数据,加载到表结构中
load data local infile '/root/sql1.log' into table tb_user fields
terminated by ',' lines terminated by '\n' ;
插入 100w 的记录,17s 就完成了,性能很好
在 load 时,主键顺序插入性能高于乱序插入
2、主键优化
(1)数据组织方式
在 InnoDB 存储引擎中,表数据都是根据主键顺序组织存放的,这种存储方式的表称为索引组织表(index organized table IOT)
行数据,都是存储在聚集索引的叶子节点上的
在 InnoDB 引擎中,数据行是记录在逻辑结构 page 页中的,而每一个页的大小是固定的,默认16K。那也就意味着, 一个页中所存储的行也是有限的,如果插入的数据行 row 在该页存储不小,将会存储到下一个页中,页与页之间会通过指针连接
(2)页分裂
页可以为空,也可以填充一半,也可以填充 100%。每个页包含了 2-N 行数据(如果一行数据过大,会行溢出),根据主键排列
A.主键顺序插入效果
①.从磁盘中申请页,主键顺序插入
②.第一个页没有满,继续往第一页插入
③.当第一个也写满之后,再写入第二个页,页与页之间会通过指针连接
④.当第二页写满了,再往第三页写入
B.主键乱序插入效果
①.加入 1#,2# 页都已经写满了,存放了如图所示的数据
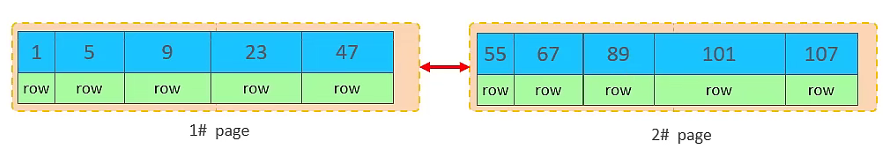
②.此时再插入 id 为 50 的记录,按照顺序,应该存储在 47 之后。但是 47 所在的 1# 页,已经写满了。 那么此时会开辟一个新的页 3#,将 1# 页后一半的数据,移动到 3# 页,然后在 3# 页,插入50。 移动数据,并插入 id 为 50 的数据之后,重新设置链表指针
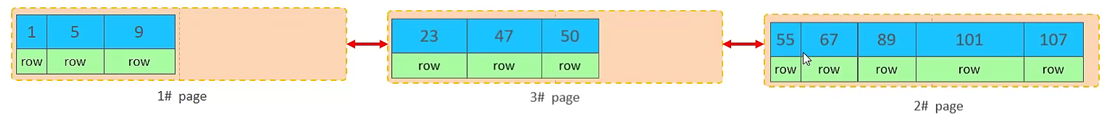
上述的这种现象,称之为“页分裂”,是比较耗费性能的操作
(3)页合并
当删除一行记录时,实际上记录并没有被物理删除,只是记录被标记(flaged)为删除并且它的空间变得允许被其他记录声明使用
当我们继续删除数据记录,当页中删除的记录达到 MERGE_THRESHOLD(默认为页的 50%),InnoDB 会开始寻找最靠近的页(前或后)看看是否可以将两个页合并以优化空间使用
MERGE_THRESHOLD:合并页的阈值,可以自己设置,在创建表或者创建索引时指定
(4)索引设计原则
- 满足业务需求的情况下,尽量降低主键的长度
- 插入数据时,尽量选择顺序插入,选择使用 AUTO_INCREMENT 自增主键
- 尽量不要使用 UUID 做主键或者是其他自然主键,如身份证号
- 业务操作时,避免对主键的修改
3、order by 优化
MySQL 的排序,有两种方式:
- Using filesort:通过表的索引或全表扫描,读取满足条件的数据行,然后在排序缓冲区 sort buffer 中完成排序操作,所有不是通过索引直接返回排序结果的排序都叫 FileSort 排序
- Using index:通过有序索引顺序扫描直接返回有序数据,这种情况即为 using index,不需要额外排序,操作效率高
对于以上的两种排序方式,Using index 的性能高,而 Using filesort 的性能低,我们在优化排序操作时,尽量要优化为 Using index
接下来,我们来做一个测试:
A.执行排序 SQL
explain select id,age,phone from tb_user order by age ;
explain select id,age,phone from tb_user order by age, phone ;
由于 age,phone 都没有索引,所以排序时,出现 Using filesort,排序性能较低
B.创建索引
-- 创建索引
create index idx_user_age_phone_aa on tb_user(age,phone);
C.创建索引后,根据 age,phone 进行升序排序
explain select id,age,phone from tb_user order by age;
explain select id,age,phone from tb_user order by age , phone;
建立索引之后,再次进行排序查询,就由原来的 Using filesort, 变为了 Using index,性能就是比较高的了
D.创建索引后,根据 age,phone 进行降序排序
explain select id,age,phone from tb_user order by age desc , phone desc ;也出现 Using index, 但是此时 Extra 中出现了 Backward index scan,代表反向扫描索引,因为在 MySQL 中我们创建的索引,默认索引的叶子节点是从小到大排序的,而此时我们查询排序时,是从大到小,所以在扫描时,就是反向扫描,就会出现 Backward index scan
在 MySQL8 版本中,支持降序索引,我们也可以创建降序索引
E.根据 phone,age 进行升序排序,phone 在前,age 在后
explain select id,age,phone from tb_user order by phone , age;排序时,也需要满足最左前缀法则,否则也会出现 filesort。因为在创建索引的时候,age 是第一个字段,phone 是第二个字段,所以排序时,也就该按照这个顺序来,否则就会出现 Using filesort
F.根据 age,phone 进行一个升序,一个降序
explain select id,age,phone from tb_user order by age asc , phone desc ;因为创建索引时,如果未指定顺序,默认都是按照升序排序的,而查询时,一个升序一个降序,此时就会出现 Using filesort
为了解决上述的问题,我们可以创建一个索引,这个联合索引中 age 升序排序,phone 倒序排序
G.创建联合索引(age 升序排序,phone 倒序排序)
create index idx_user_age_phone_ad on tb_user(age asc ,phone desc);由上述的测试,我们得出 order by 优化原则:
-
根据排序字段建立合适的索引,多字段排序时,也遵循最左前缀法则
-
尽量使用覆盖索引
-
多字段排序, 一个升序一个降序,此时需要注意联合索引在创建时的规则(ASC / DESC)
-
如果不可避免的出现 filesort,大数据量排序时,可以适当增大排序缓冲区大小 sort_buffer_size (默认 256k)
show variables like 'sort_buffer_size';
4、group by 优化
分组操作,我们主要来看看索引对于分组操作的影响
在没有索引的情况下,执行如下 SQL,查询执行计划:
explain select profession , count(*) from tb_user group by profession ;然后,我们在针对于 profession , age, status 创建一个联合索引
create index idx_user_pro_age_sta on tb_user(profession , age , status);紧接着,再执行前面相同的 SQL 查看执行计划
explain select profession , count(*) from tb_user group by profession ;再执行如下的分组查询 SQL,查看执行计划:
explain select profession , count(*) from tb_user group by profession , age;
explain select age , count(*) from tb_user group by age;
我们发现,如果仅仅根据 age 分组,就会出现 Using temporary;而如果是根据 profession,age 两个字段同时分组,则不会出现 Using temporary。原因是因为对于分组操作,在联合索引中,也是符合最左前缀法则的
所以,在分组操作中,我们需要通过以下两点进行优化,以提升性能:
- A.在分组操作时,可以通过索引来提高效率
- B.分组操作时,索引的使用也是满足最左前缀法则的
5、limit 优化
在数据量比较大时,如果进行 limit 分页查询,在查询时,越往后,分页查询效率越低
我们一起来看看执行 limit 分页查询耗时对比:
select * from tb_sku limit 0,10;
select * from tb_sku limit 100000,10;
select * from tb_sku limit 500000,10;
select * from tb_sku limit 900000,10;
通过测试我们会看到,越往后,分页查询效率越低,这就是分页查询的问题所在
因为,当在进行分页查询时,如果执行 limit 2000000,10,此时需要 MySQL 排序前 2000010 记录,仅仅返回 2000000 ~ 2000010 的记录,其他记录丢弃,查询排序的代价非常大
优化思路:
一般分页查询时,通过创建覆盖索引能够比较好地提高性能,可以通过覆盖索引加子查询形式进行优化
explain select * from tb_sku t , (select id from tb_sku order by id limit 2000000,10) a where t.id = a.id;6、count 优化
(1)概述
select count(*) from tb_user ;如果数据量很大,在执行 count 操作时,是非常耗时的
- MyISAM 引擎把一个表的总行数存在了磁盘上,因此执行 count(*) 的时候会直接返回这个数,效率很高; 但是如果是带条件的 count,MyISAM 也慢
- InnoDB 引擎就麻烦了,它执行 count(*) 的时候,需要把数据一行一行地从引擎里面读出来,然后累积计数
如果说要大幅度提升 InnoDB 表的 count 效率,主要的优化思路:
自己计数(可以借助于 redis 这样的数据库进行,但是如果是带条件的 count 又比较麻烦了)
(2)count 用法
count() 是一个聚合函数,对于返回的结果集,一行行地判断,如果 count 函数的参数不是 NULL,累计值就加 1,否则不加,最后返回累计值
用法:
- count(*)
- count(主键)
- count(字段)
- count(数字)
| count 用法 | 含义 |
|---|---|
| count(主键) | InnoDB 引擎会遍历整张表,把每一行的主键 id 值都取出来,返回给服务层。服务层拿到主键后,直接按行进行累加(主键不可能为 null) |
| count(字段) | 没有 not null 约束:InnoDB 引擎会遍历整张表把每一行的字段值都取出来,返回给服务层,服务层判断是否为 null,不为 null,计数累加。 有 not null 约束:InnoDB 引擎遍历整张表把每一行的字段值都取出来,返回给服务层,直接按行进行累加 |
| count(数字) | InnoDB 引擎遍历整张表,但不取值。服务层对于返回的每一行,放一个数字进去,直接按行进行累加 |
| count(*) | InnoDB 引擎并不会把全部字段取出来,而是专门做了优化,不取值,服务层直接按行进行累加 |
按照效率排序的话,count(字段) < count(主键 id) < count(数字) ≈ count( * ),所以尽量使用 count( * )
7、update 优化
我们主要需要注意一下 update 语句执行时的注意事项
update course set name = 'javaEE' where id = 1 ;当我们在执行这条 SQL 语句时,会锁定 id 为 1 这一行的数据,然后事务提交之后,行锁释放
但是当我们在执行如下 SQL 时
update course set name = 'SpringBoot' where name = 'PHP' ;当我们开启多个事务,在执行上述的 SQL 时,我们发现行锁升级为了表锁,会锁定所有的数据,导致该 update 语句的性能大大降低
我们可以对 name 字段加索引,再执行上述 SQL 就不会出现表锁
InnoDB 的行锁是针对索引加的锁,不是针对记录加的锁,并且该索引不能失效,否则会从行锁升级为表锁
十、MySQL 进阶之 —— 视图
1、视图介绍
视图(View)是一种虚拟存在的表。视图中的数据并不在数据库中实际存在,行和列数据来自定义视图的查询中使用的表(基表),并且是在使用视图时动态生成的
通俗的讲,视图只保存了查询的 SQL 逻辑,不保存查询结果。所以我们在创建视图的时候,主要的工作就落在创建这条 SQL 查询语句上
2、基础语法
(1)创建
CREATE [OR REPLACE] VIEW 视图名称[(列名列表)] AS SELECT语句 [ WITH [ CASCADED | LOCAL ] CHECK OPTION ](2)查询
-- 查看创建视图语句
SHOW CREATE VIEW 视图名称;
-- 查看视图数据
SELECT * FROM 视图名称 ...... ;
(3)修改
-- 方式一
CREATE [OR REPLACE] VIEW 视图名称[(列名列表)] AS SELECT语句 [ WITH [ CASCADED | LOCAL ] CHECK OPTION ]
-- 方式二
ALTER VIEW 视图名称[(列名列表)] AS SELECT语句 [ WITH [ CASCADED | LOCAL ] CHECK OPTION ]
(4)删除
DROP VIEW [IF EXISTS] 视图名称 [,视图名称 ...](5)演示示例
-- 创建视图
create or replace view stu_v_1 as select id,name from student where id <= 10;

-- 查询视图
show create view stu_v_1;
select * from stu_v_1;
select * from stu_v_1 where id < 3;

-- 修改视图
create or replace view stu_v_1 as select id,name,no from student where id <= 10;
alter view stu_v_1 as select id,name from student where id <= 10;

-- 删除视图
drop view if exists stu_v_1;
(6)增删改
create or replace view stu_v_1 as select id,name from student where id <= 10 ;
select * from stu_v_1;
insert into stu_v_1 values(6,'Tom');
insert into stu_v_1 values(17,'Tom22');
执行上述的 SQL,我们会发现,id 为 6 和 17 的数据都是可以成功插入的。 但是我们执行查询,查询出来的数据,却没有 id 为 17 的记录
因为我们在创建视图的时候,指定的条件为 id<=10,id 为 17 的数据不符合条件,所以没有查询出来,但是这条数据确实是已经成功的插入到了基表中
如果我们定义视图时,如果指定了条件,然后我们在插入、修改、删除数据时,是否可以做到必须满足条件才能操作,否则不能够操作呢? 答案是可以的,这就需要借助于视图的检查选项了
3、检查选项
(1)CASCADED 级联
当使用 WITH CHECK OPTION 子句创建视图时,MySQL 会通过视图检查正在更改的每个行,例如插入,更新,删除,以使其符合视图的定义。MySQL 允许基于另一个视图创建视图,它还会检查依赖视图中的规则以保持一致性
为了确定检查的范围,mysql 提供了两个选项:CASCADED 和 LOCAL,默认值为 CASCADED
比如,v2 视图是基于 v1 视图的,如果在 v2 视图创建的时候指定了检查选项为 cascaded,但是 v1 视图创建时未指定检查选项。则在执行检查时,不仅会检查v2,还会级联检查 v2 的关联视图 v1
create view v1 as select id,name from student where id <= 20;
create view v2 as select id,name from v1 where id >= 10 with cascaded check option;
create view v3 as select id,name from v2 where id <= 15;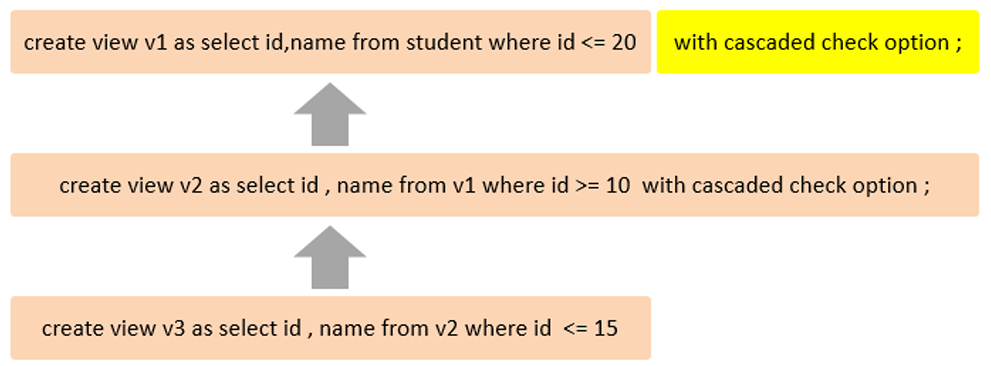
(2)LOCAL 本地
比如,v2 视图是基于 v1 视图的,如果在 v2 视图创建的时候指定了检查选项为 local ,但是 v1 视图创建时未指定检查选项。 则在执行检查时,只会检查 v2,不会检查v2的关联视图 v1;v3 视图是基于 v2 视图的,但是 v3 视图创建时未指定检查选项。则在执行检查时,只会检查 v2,不会 v3 和检查 v2 的关联视图 v1
create view v1 as select id,name from student where id <= 15;
create view v2 as select id,name from v1 where id >= 10 with local check option;
create view v3 as select id,name from v2 where id < 20;
4、视图更新
要使视图可更新,视图中的行与基础表中的行之间必须存在一对一的关系。如果视图包含以下任何一项,则该视图不可更新:
- 聚合函数或窗口函数(SUM()、 MIN()、 MAX()、 COUNT()等)
- DISTINCT
- GROUP BY
- HAVING
- UNION 或者 UNION ALL
示例:
create view stu_v_count as select count(*) from student;
insert into stu_v_count values(10);
# 报错
5、视图作用
(1)简单
视图不仅可以简化用户对数据的理解,也可以简化他们的操作。那些被经常使用的查询可以被定义为视图,从而使得用户不必为以后的操作每次指定全部的条件
(2)安全
数据库可以授权,但不能授权到数据库特定行和特定的列上。通过视图用户只能查询和修改他们所能见到的数据
(3)数据独立
视图可帮助用户屏蔽真实表结构变化带来的影响
6、视图案例
A. 为了保证数据库表的安全性,开发人员在操作 tb_user 表时,只能看到的用户的基本字段,屏蔽手机号和邮箱两个字段
create view tb_user_view as select id,name,profession,age,gender,status,createtime from tb_user;
select * from tb_user_view;
B. 查询每个学生所选修的课程(三张表联查),这个功能在很多的业务中都有使用到,为了简化操作,定义一个视图
create view tb_stu_course_view as select s.name student_name , s.no student_no , c.name course_name from student s, student_course sc , course c where s.id = sc.studentid and sc.courseid = c.id;
select * from tb_stu_course_view;
十一、MySQL 进阶之 —— 存储过程
1、介绍
存储过程是事先经过编译并存储在数据库中的一段 SQL 语句的集合,调用存储过程可以简化应用开发人员的很多工作,减少数据在数据库和应用服务器之间的传输,对于提高数据处理的效率是有好处的。 存储过程思想上很简单,就是数据库 SQL 语言层面的代码封装与重用
特点:
- 封装,复用:可以把某一业务 SQL 封装在存储过程中,需要用到的时候直接调用即可
- 可以接收参数,也可以返回数据:在存储过程中,可以传递参数,也可以接收返回值
- 减少网络交互,效率提升:如果涉及到多条 SQL,每执行一次都是一次网络传输。而如果封装在存储过程中,我们只需要网络交互一次可能就可以了
2、基础语法
(1)创建
CREATE PROCEDURE 存储过程名称 ([参数列表])
BEGIN
    -- sql语句
END ;
(2)调用
CALL 名称 ([参数]);(3)查看
-- 查询指定数据库的存储过程及状态信息
SELECT * FROM INFORMATION_SCHEMA.ROUTINES WHERE ROUTINE_SCHEMA = 'xxx';
-- 查询某个存储过程的定义
SHOW CREATE PROCEDURE 存储过程名称 ;
(4)删除
DROP PROCEDURE [ IF EXISTS ] 存储过程名称 ;注意:
在命令行中,执行创建存储过程的 SQL时,需要通过关键字 delimiter 指定 SQL 语句的结束符
delimiter $$示例:
-- 存储过程基本语法
-- 创建
create procedure p1()
begin
    select count(*) from student;
end;

-- 调用
call p1();

-- 查看
select * from information_schema.ROUTINES where ROUTINE_SCHEMA = 'itcast';
show create procedure p1;

-- 删除
drop procedure if exists p1;
3、变量
在 MySQL 中变量分为三种类型:
- 系统变量
- 用户定义变量
- 局部变量
(1)系统变量
系统变量是 MySQL 服务器提供,不是用户定义的,属于服务器层面。分为全局变量(GLOBAL)、会话变量(SESSION)
- 全局变量(GLOBAL):全局变量针对于所有的会话
- 会话变量(SESSION):会话变量针对于单个会话,在另外一个会话窗口就不生效了
1)查看系统变量
-- 查看所有系统变量
SHOW [ SESSION | GLOBAL ] VARIABLES ;
-- 可以通过 LIKE 模糊匹配方式查找变量
SHOW [ SESSION | GLOBAL ] VARIABLES LIKE '......';
-- 查看指定变量的值
SELECT @@[SESSION | GLOBAL] 系统变量名;
2)设置系统变量
SET [ SESSION | GLOBAL ] 系统变量名 = 值 ;
SET @@[SESSION | GLOBAL] 系统变量名 = 值 ;
注意:
如果没有指定 SESSION / GLOBAL,默认是 SESSION,会话变量
mysql 服务重新启动之后,所设置的全局参数会失效,要想不失效,可以在 /etc/my.cnf 中配置
示例:
-- 查看系统变量
show session variables ;
show session variables like 'auto%';
show global variables like 'auto%';
select @@global.autocommit;
select @@session.autocommit;

-- 设置系统变量
set session autocommit = 1;
insert into course(id, name) VALUES (6, 'ES');
set global autocommit = 0;
select @@global.autocommit;
(2)用户定义变量
用户定义变量是用户根据需要自己定义的变量,用户变量不用提前声明,在用的时候直接用“@变量名”使用就可以。其作用域为当前连接
1)赋值
方式一:
SET @var_name = expr [, @var_name = expr] ... ;
SET @var_name := expr [, @var_name := expr] ... ;
赋值时,可以使用 =,也可以使用 :=
方式二:
SELECT @var_name := expr [, @var_name := expr] ... ;
SELECT 字段名 INTO @var_name FROM 表名;
2)使用
SELECT @var_name ;注意:
用户定义的变量无需对其进行声明或初始化,只不过获取到的值为 NULL
示例:
-- 赋值
set @myname = 'itcast';
set @myage := 10;
set @mygender := '男',@myhobby := 'java';

select @mycolor := 'red';
select count(*) into @mycount from tb_user;

-- 使用
select @myname,@myage,@mygender,@myhobby;
select @mycolor , @mycount;

select @abc;
(3)局部变量
局部变量是根据需要定义的在局部生效的变量,访问之前,需要DECLARE声明。可用作存储过程内的局部变量和输入参数,局部变量的范围是在其内声明的 BEGIN ... END块
1)声明
DECLARE 变量名 变量类型 [DEFAULT ... ] ;变量类型就是数据库字段类型:INT、BIGINT、CHAR、VARCHAR、DATE、TIME 等
2)赋值
SET 变量名 = 值 ;
SET 变量名 := 值 ;
SELECT 字段名 INTO 变量名 FROM 表名 ... ;
示例:
-- 声明局部变量 - declare
-- 赋值
create procedure p2()
begin
    declare stu_count int default 0;
    select count(*) into stu_count from student;
    select stu_count;
end;

call p2();
4、if 判断
(1)介绍
if 用于做条件判断,具体的语法结构为:
IF 条件1 THEN
    ......
ELSEIF 条件2 THEN  -- 可选
    ......
ELSE               -- 可选
    ......
END IF;
在 if 条件判断的结构中,ELSE IF 结构可以有多个,也可以没有。ELSE 结构可以有,也可以没有
(2)案例
根据定义的分数 score 变量,判定当前分数对应的分数等级
- score >= 85分,等级为优秀
- score >= 60分 且 score < 85分,等级为及格
- score < 60分,等级为不及格
create procedure p3()
begin
    declare score int default 58;
    declare result varchar(10);

    if score >= 85 then
        set result := '优秀';
    elseif score >= 60 then
        set result := '及格';
    else
        set result := '不及格';
    end if;

    select result;
end;

call p3();
5、参数
(1)介绍
参数的类型,主要分为以下三种:IN、OUT、INOUT
| 类型 | 含义 | 备注 |
|---|---|---|
| IN | 该类参数作为输入,也就是需要调用时传入值 | 默认 |
| OUT | 该类参数作为输出,也就是该参数可以作为返回值 | |
| INOUT | 既可以作为输入参数,也可以作为输出参数 |
用法:
CREATE PROCEDURE 存储过程名称 ([ IN/OUT/INOUT 参数名 参数类型 ])
BEGIN
    -- SQL语句
END ;
(2)案例
案例一
根据传入参数 score,判定当前分数对应的分数等级,并返回
- score >= 85 分,等级为优秀
- score >= 60 分 且 score < 85 分,等级为及格
- score < 60 分,等级为不及格
create procedure p4(in score int, out result varchar(10))
begin
    if score >= 85 then
        set result := '优秀';
    elseif score >= 60 then
        set result := '及格';
    else
        set result := '不及格';
    end if;
end;

-- 定义用户变量 @result 来接收返回的数据,用户变量可以不用声明
call p4(18, @result);
select @result;
案例二
将传入的 200 分制的分数,进行换算,换算成百分制,然后返回
create procedure p5(inout score double)
begin
    set score := score * 0.5;
end;

set @score = 198;
call p5(@score);
select @score;
6、case
(1)介绍
case 结构及作用,和我们在基础篇中所讲解的流程控制函数很类似。有两种语法格式:
语法 1:
-- 含义:当 case_value 的值为 when_value1 时,执行 statement_list1,当值为 when_value2 时,执行statement_list2,否则就执行 statement_list
CASE case_value
    WHEN when_value1 THEN statement_list1
    [ WHEN when_value2 THEN statement_list2 ] ...
    [ ELSE statement_list ]
END CASE;
语法 2:
-- 含义:当条件 search_condition1 成立时,执行 statement_list1,当条件 search_condition2 成立时,执行 statement_list2,否则就执行 statement_list
CASE
    WHEN search_condition1 THEN statement_list1
    [WHEN search_condition2 THEN statement_list2] ...
    [ELSE statement_list]
END CASE;
(2)案例
根据传入的月份,判定月份所属的季节(要求采用 case 结构)
- 1-3 月份,为第一季度
- 4-6 月份,为第二季度
- 7-9 月份,为第三季度
- 10-12 月份,为第四季度
create procedure p6(in month int)
begin
    declare result varchar(10);
    case
        when month >= 1 and month <= 3 then
            set result := '第一季度';
        when month >= 4 and month <= 6 then
            set result := '第二季度';
        when month >= 7 and month <= 9 then
            set result := '第三季度';
        when month >= 10 and month <= 12 then
            set result := '第四季度';
        else
            set result := '非法参数';
    end case ;

    select concat('您输入的月份为:',month, ', 所属的季度为:',result);
end;

call p6(16);
注意:
如果判定条件有多个,多个条件之间,可以使用 and 或 or 进行连接
7、循环
(1)while
1)介绍
while 循环是有条件的循环控制语句。满足条件后,再执行循环体中的 SQL 语句。具体语法为:
-- 先判定条件,如果条件为 true,则执行逻辑,否则,不执行逻辑
WHILE 条件 DO
    SQL 逻辑...
END WHILE;
2)案例
计算从 1 累加到 n 的值,n 为传入的参数值
-- A. 定义局部变量,记录累加之后的值;
-- B. 每循环一次,就会对 n 进行减 1,如果 n 减到 0,则退出循环
create procedure p7(in n int)
begin
    declare total int default 0;
    while n>0 do
        set total := total + n;
        set n := n - 1;
    end while;
    select total;
end;

call p7(100);
(2)repeat
1)介绍
repeat 是有条件的循环控制语句,当满足 until 声明的条件的时候,则退出循环。具体语法为:
-- 先执行一次逻辑,然后判定 UNTIL 条件是否满足,如果满足,则退出,如果不满足,则继续下一次循环
REPEAT
    SQL逻辑...
UNTIL 条件
END REPEAT;
2)案例
计算从 1 累加到 n 的值,n 为传入的参数值(使用 repeat 实现)
-- A. 定义局部变量,记录累加之后的值;
-- B. 每循环一次,就会对 n 进行 - 1,如果 n 减到 0,则退出循环
create procedure p8(in n int)
begin
    declare total int default 0;
    repeat
        set total := total + n;
        set n := n - 1;
    until n<=0
    end repeat;
    select total;
end;

call p8(10);
call p8(100);
(3)loop
1)介绍
LOOP 实现简单的循环,如果不在 SQL 逻辑中增加退出循环的条件,可以用其来实现简单的死循环。 LOOP 可以配合一下两个语句使用:
- LEAVE:配合循环使用,退出循环
- ITERATE:必须用在循环中,作用是跳过当前循环剩下的语句,直接进入下一次循环
[begin_label:] LOOP
    SQL逻辑...
END LOOP [end_label];
LEAVE label;    -- 退出指定标记的循环体
ITERATE label;  -- 直接进入下一次循环
上述语法中出现的 begin_label,end_label,label 指的都是我们所自定义的标记
2)案例
案例一
计算从 1 累加到 n 的值,n 为传入的参数值
-- A. 定义局部变量,记录累加之后的值;
-- B. 每循环一次,就会对n进行-1,如果n减到0,则退出循环 ----> leave xx
create procedure p9(in n int)
begin
    declare total int default 0;
    sum:loop
        if n<=0 then
            leave sum;
        end if;
        set total := total + n;
        set n := n - 1;
    end loop sum;
    select total;
end;

call p9(100);
案例二
计算从 1 到 n 之间的偶数累加的值,n 为传入的参数值
-- A. 定义局部变量,记录累加之后的值;
-- B. 每循环一次,就会对 n 进行 - 1,如果 n 减到 0,则退出循环 ----> leave xx
-- C. 如果当次累加的数据是奇数,则直接进入下一次循环 --------> iterate xx
create procedure p10(in n int)
begin
    declare total int default 0;
    sum:loop
        if n<=0 then
            leave sum;
        end if;
        if n%2 = 1 then
            set n := n - 1;
            iterate sum;
        end if;
        set total := total + n;
        set n := n - 1;
    end loop sum;
    select total;
end;

call p10(100);
8、游标 / 光标
(1)介绍
游标(CURSOR)是用来存储查询结果集的数据类型,在存储过程和函数中可以使用游标对结果集进行循环的处理。游标的使用包括游标的声明、OPEN、FETCH 和 CLOSE,其语法分别如下:
A.声明游标
DECLARE 游标名称 CURSOR FOR 查询语句 ;B.打开游标
OPEN 游标名称 ;C.获取游标记录
FETCH 游标名称 INTO 变量 [, 变量 ] ;D.关闭游标
CLOSE 游标名称 ;(2)案例
根据传入的参数 uage,来查询用户表 tb_user 中,所有的用户年龄小于等于 uage 的用户姓名(name)和专业(profession),并将用户的姓名和专业插入到所创建的一张新表(id,name,profession)中
-- 逻辑:
-- A. 声明游标,存储查询结果集
-- B. 准备:创建表结构
-- C. 开启游标
-- D. 获取游标中的记录
-- E. 插入数据到新表中
-- F. 关闭游标
create procedure p11(in uage int)
begin
	# 先声明普通变量,再声明游标
    declare uname varchar(100);
    declare upro varchar(100);
    declare u_cursor cursor for select name,profession from tb_user where age <= uage;

    drop table if exists tb_user_pro;
    create table if not exists tb_user_pro(
        id int primary key auto_increment,
        name varchar(100),
        profession varchar(100)
    );

    open u_cursor;
    while true do
        fetch u_cursor into uname,upro;
        insert into tb_user_pro values (null, uname, upro);
    end while;
    close u_cursor;
end;

call p11(30);
上述的存储过程,会报错,因为上面的 while 循环并没有退出条件。但是此时 tb_user_pro 表结构及其数据都已经插入成功了
要想解决这个问题,就需要通过 MySQL 中提供的条件处理程序 Handler 来解决
9、条件处理程序
(1)介绍
条件处理程序(Handler)可以用来定义在流程控制结构执行过程中遇到问题时相应的处理步骤。具体语法为:
DECLARE handler_action HANDLER FOR condition_value [, condition_value]
    ... statement ;
handler_action 的取值:
- CONTINUE:继续执行当前程序
- EXIT:终止执行当前程序
condition_value 的取值:
- SQLSTATE sqlstate_value:状态码,如 02000
- SQLWARNING:所有以 01 开头的 SQLSTATE 代码的简写
- NOT FOUND:所有以 02 开头的 SQLSTATE 代码的简写
- SQLEXCEPTION:所有没有被 SQLWARNING 或 NOT FOUND 捕获的 SQLSTATE 代码的简写
(2)案例
我们继续解决上一节案例存在的问题
A.通过 SQLSTATE 指定具体的状态码
-- 逻辑:
-- A. 声明游标,存储查询结果集
-- B. 准备:创建表结构
-- C. 开启游标
-- D. 获取游标中的记录
-- E. 插入数据到新表中
-- F. 关闭游标
create procedure p11(in uage int)
begin
    declare uname varchar(100);
    declare upro varchar(100);
    declare u_cursor cursor for select name,profession from tb_user where age <= uage;
    -- 声明条件处理程序: 当 SQL 语句执行抛出的状态码为 02000 时,将关闭游标 u_cursor,并退出
    declare exit handler for SQLSTATE '02000' close u_cursor;

    drop table if exists tb_user_pro;
    create table if not exists tb_user_pro(
        id int primary key auto_increment,
        name varchar(100),
        profession varchar(100)
    );

    open u_cursor;
    while true do
        fetch u_cursor into uname,upro;
        insert into tb_user_pro values (null, uname, upro);
    end while;
    close u_cursor;
end;

call p11(30);
B.通过 SQLSTATE 的代码简写方式 NOT FOUND 02 开头的状态码,代码简写为 NOT FOUND
create procedure p12(in uage int)
begin
    declare uname varchar(100);
    declare upro varchar(100);
    declare u_cursor cursor for select name,profession from tb_user where age <= uage;
    -- 声明条件处理程序 : 当 SQL 语句执行抛出的状态码为 02 开头时,将关闭游标 u_cursor,并退出
    declare exit handler for not found close u_cursor;

    drop table if exists tb_user_pro;
    create table if not exists tb_user_pro(
        id int primary key auto_increment,
        name varchar(100),
        profession varchar(100)
    );

    open u_cursor;
    while true do
        fetch u_cursor into uname,upro;
        insert into tb_user_pro values (null, uname, upro);
    end while;
    close u_cursor;
end;

call p12(30);
具体的错误状态码,可以参考官方文档:
https://dev.mysql.com/doc/refman/8.0/en/declare-handler.html
https://dev.mysql.com/doc/mysql-errors/8.0/en/server-error-reference.html
10、存储函数
(1)介绍
存储函数是有返回值的存储过程,存储函数的参数只能是 IN 类型的。具体语法如下:
CREATE FUNCTION 存储函数名称 ([ 参数列表 ])
RETURNS type [characteristic ...]
BEGIN
    -- SQL 语句
    RETURN ...;
END ;
characteristic 说明:
- DETERMINISTIC:相同的输入参数总是产生相同的结果
- NO SQL:不包含 SQL 语句
- READS SQL DATA:包含读取数据的语句,但不包含写入数据的语句
(2)案例
计算从 1 累加到 n 的值,n 为传入的参数值
create function fun1(n int)
returns int deterministic
begin
    declare total int default 0;

    while n>0 do
        set total := total + n;
        set n := n - 1;
    end while;

    return total;
end;

select fun1(50);
在 mysql8.0 版本中 binlog 默认是开启的,一旦开启了,mysql 就要求在定义存储过程时,需要指定 characteristic 特性,否则报错
存储函数能做的存储过程也能做,而且存储函数有个弊端:必须有返回值,所以存储函数用的比较少
十二、MySQL 进阶之 —— 触发器
1、介绍
触发器是与表有关的数据库对象,指在 insert / update / delete 之前(BEFORE)或之后(AFTER),触发并执行触发器中定义的 SQL 语句集合。触发器的这种特性可以协助应用在数据库端确保数据的完整性,日志记录,数据校验等操作
使用别名 OLD 和 NEW 来引用触发器中发生变化的记录内容,这与其他的数据库是相似的。现在触发器还只支持行级触发,不支持语句级触发
| 触发器类型 | NEW 和 OLD |
|---|---|
| INSERT 型触发器 | NEW 表示将要或者已经新增的数据 |
| UPDATE 型触发器 | OLD 表示修改之前的数据, NEW 表示将要或已经修改后的数据 |
| DELETE 型触发器 | OLD 表示将要或者已经删除的数据 |
2、语法
(1)创建
CREATE TRIGGER trigger_name
BEFORE/AFTER INSERT/UPDATE/DELETE
ON tbl_name FOR EACH ROW  -- 行级触发器
BEGIN
    trigger_stmt ;
END;
(2)查看
SHOW TRIGGERS ;(3)删除
DROP TRIGGER [schema_name.]trigger_name ; -- 如果没有指定 schema_name,默认为当前数据库3、案例
通过触发器记录 tb_user 表的数据变更日志,将变更日志插入到日志表 user_logs 中,包含增加,修改,删除
表结构准备:
-- 准备工作 : 日志表 user_logs
create table user_logs(
  id int(11) not null auto_increment,
  operation varchar(20) not null comment '操作类型,insert/update/delete',
  operate_time datetime not null comment '操作时间',
  operate_id int(11) not null comment '操作的ID',
  operate_params varchar(500) comment '操作参数',
  primary key(`id`)
)engine=innodb default charset=utf8;
A.插入数据触发器
create trigger tb_user_insert_trigger
    after insert on tb_user for each row
begin
    insert into user_logs(id, operation, operate_time, operate_id, operate_params)
VALUES
    (null, 'insert', now(), new.id, concat('插入的数据内容为: id=',new.id,',name=',new.name, ', phone=', NEW.phone, ', email=', NEW.email, ', profession=', NEW.profession));
end;
测试:
-- 查看
show triggers ;

-- 插入数据到tb_user
insert into tb_user(id, name, phone, email, profession, age, gender, status, createtime) VALUES (26,'三皇子','18809091212','erhuangzi@163.com','软件工程',23,'1','1',now());
测试完毕之后,检查日志表中的数据是否可以正常插入,以及插入数据的正确性。
B.修改数据触发器
create trigger tb_user_update_trigger
    after update on tb_user for each row
begin
    insert into user_logs(id, operation, operate_time, operate_id, operate_params)
VALUES
    (null, 'update', now(), new.id,
        concat('更新之前的数据: id=',old.id,',name=',old.name, ', phone=', old.phone, ', email=', old.email, ', profession=', old.profession,
            ' | 更新之后的数据: id=',new.id,',name=',new.name, ', phone=', NEW.phone, ', email=', NEW.email, ', profession=', NEW.profession));
end;
测试:
-- 查看
show triggers ;

-- 更新
update tb_user set profession = '会计' where id = 23;
update tb_user set profession = '会计' where id <= 5;
测试完毕之后,检查日志表中的数据是否可以正常插入,以及插入数据的正确性。
C.删除数据触发器
create trigger tb_user_delete_trigger
    after delete on tb_user for each row
begin
    insert into user_logs(id, operation, operate_time, operate_id, operate_params)
VALUES
    (null, 'delete', now(), old.id,
        concat('删除之前的数据: id=',old.id,',name=',old.name, ', phone=', old.phone, ', email=', old.email, ', profession=', old.profession));
end;
测试:
-- 查看
show triggers ;

-- 删除数据
delete from tb_user where id = 26;
测试完毕之后,检查日志表中的数据是否可以正常插入,以及插入数据的正确性
十三、MySQL 进阶之 —— 锁
1、概述
锁是计算机协调多个进程或线程并发访问某一资源的机制。在数据库中,除传统的计算资源(CPU、RAM、I/O)的争用以外,数据也是一种供许多用户共享的资源。如何保证数据并发访问的一致性、有效性是所有数据库必须解决的一个问题,锁冲突也是影响数据库并发访问性能的一个重要因素。从这个角度来说,锁对数据库而言显得尤其重要,也更加复杂
MySQL 中的锁,按照锁的粒度分,分为以下三类:
- 全局锁:锁定数据库中的所有表
- 表级锁:每次操作锁住整张表
- 行级锁:每次操作锁住对应的行数据
2、全局锁
(1)介绍
全局锁就是对整个数据库实例加锁,加锁后整个实例就处于只读状态,后续的 DML 的写语句,DDL 语句,已经更新操作的事务提交语句都将被阻塞
其典型的使用场景是做全库的逻辑备份,对所有的表进行锁定,从而获取一致性视图,保证数据的完整性
为什么全库逻辑备份,就需要加全就锁呢?
A.不加全局锁,可能存在的问题
假设在数据库中存在这样三张表:tb_stock 库存表,tb_order 订单表,tb_orderlog 订单日志表
- 在进行数据备份时,先备份了 tb_stock 库存表
- 然后接下来,在业务系统中,执行了下单操作,扣减库存,生成订单(更新 tb_stock 表,插入 tb_order 表)
- 然后再执行备份 tb_order 表的逻辑
- 业务中执行插入订单日志操作
- 最后,又备份了 tb_orderlog 表
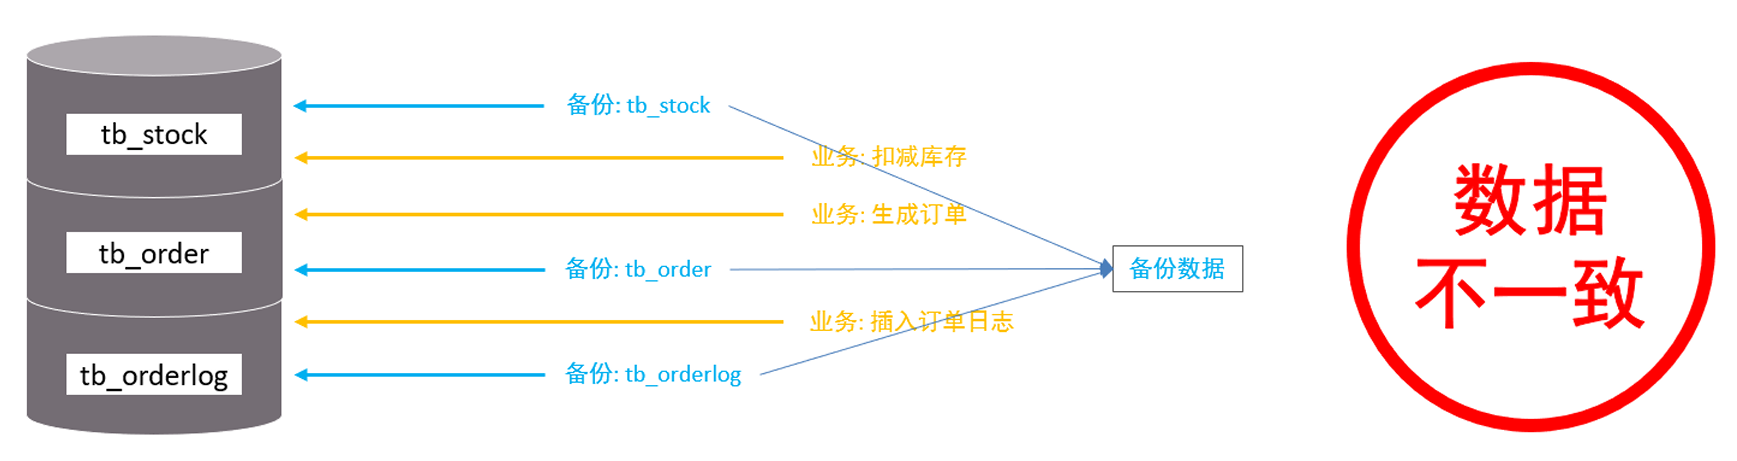
此时备份出来的数据,是存在问题的。因为备份出来的数据,tb_stock 表与 tb_order 表的数据不一致
B.分析加了全局锁后的情况
对数据库进行进行逻辑备份之前,先对整个数据库加上全局锁,一旦加了全局锁之后,其他的 DDL、DML 全部都处于阻塞状态,但是可以执行 DQL 语句,也就是处于只读状态,而数据备份就是查询操作。那么数据在进行逻辑备份的过程中,数据库中的数据就是不会发生变化的,这样就保证了数据的一致性和完整性
(2)语法
1)加全局锁
flush tables with read lock ;2)数据备份
mysqldump -uroot -p1234 itcast > itcast.sql数据备份的命令不是 SQL 语句,需要在命令行中执行
3)释放锁
unlock tables ;(3)特点
数据库中加全局锁,是一个比较重的操作,存在以下问题:
- 如果在主库上备份,那么在备份期间都不能执行更新,业务基本上就得停摆
- 如果在从库上备份,那么在备份期间从库不能执行主库同步过来的二进制日志(binlog),会导致主从延迟
在 InnoDB 引擎中,我们可以在备份时加上参数 —single-transaction 参数来完成不加锁的一致性数据备份
mysqldump --single-transaction -uroot -p123456 itcast > itcast.sql3、表级锁
(1)介绍
表级锁,每次操作锁住整张表。锁定粒度大,发生锁冲突的概率最高,并发度最低。应用在 MyISAM、InnoDB、BDB 等存储引擎中
对于表级锁,主要分为以下三类:
- 表锁
- 元数据锁(meta data lock,MDL)
- 意向锁
(2)表锁
对于表锁,分为两类:
- 表共享读锁(read lock)
- 表独占写锁(write lock)
语法:
-
加锁:
lock tables 表名... read/write; -
释放锁:
unlock tables或客户端断开连接
特点:
- 读锁:客户端一对指定表加了读锁,不会影响右侧客户端二的读,但是会阻塞右侧客户端的写
- 写锁:客户端一对指定表加了写锁,会阻塞右侧客户端的读和写
(3)元数据锁
meta data lock,元数据锁,简写 MDL。 MDL 加锁过程是系统自动控制,无需显式使用,在访问一张表的时候会自动加上。MDL 锁主要作用是维护表元数据的数据一致性,在表上有活动事务的时候,不可以对元数据进行写入操作。为了避免 DML 与 DDL 冲突,保证读写的正确性
这里的元数据,可以简单理解为就是一张表的表结构。也就是说,某一张表涉及到未提交的事务时,是不能够修改这张表的表结构的
在 MySQL5.5 中引入了 MDL,当对一张表进行增删改查的时候,加 MDL 读锁(共享);当对表结构进行变更操作的时候,加 MDL 写锁(排他)
常见的 SQL 操作时,所添加的元数据锁:
| 对应SQL | 锁类型 | 说明 |
|---|---|---|
| lock tables xxx read / write | SHARED_READ_ONLY / SHARED_NO_READ_WRITE | |
| select、select … lock in share mode | SHARED_READ | 与 SHARED_READ、SHARED_WRITE 兼容,与 EXCLUSIVE 互斥 |
| insert、update、delete、select … for update | SHARED_WRITE | 与 SHARED_READ、SHARED_WRITE 兼容,与 EXCLUSIVE 互斥 |
| alter table … | EXCLUSIVE | 与其他的 MDL 都互斥 |
演示:
当执行 SELECT、INSERT、UPDATE、DELETE 等语句时,添加的是元数据共享锁(SHARED_READ / SHARED_WRITE),之间是兼容的
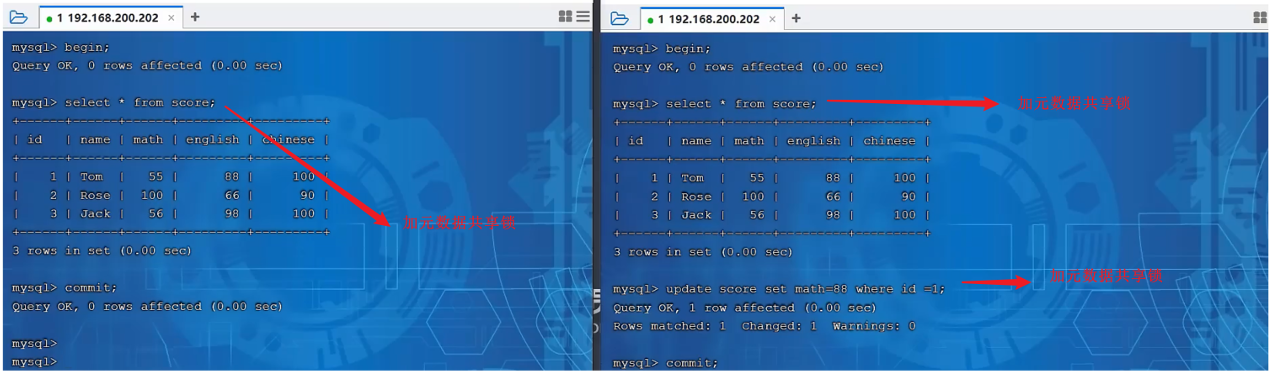
当执行 SELECT 语句时,添加的是元数据共享锁(SHARED_READ),会阻塞元数据排他锁(EXCLUSIVE),之间是互斥的
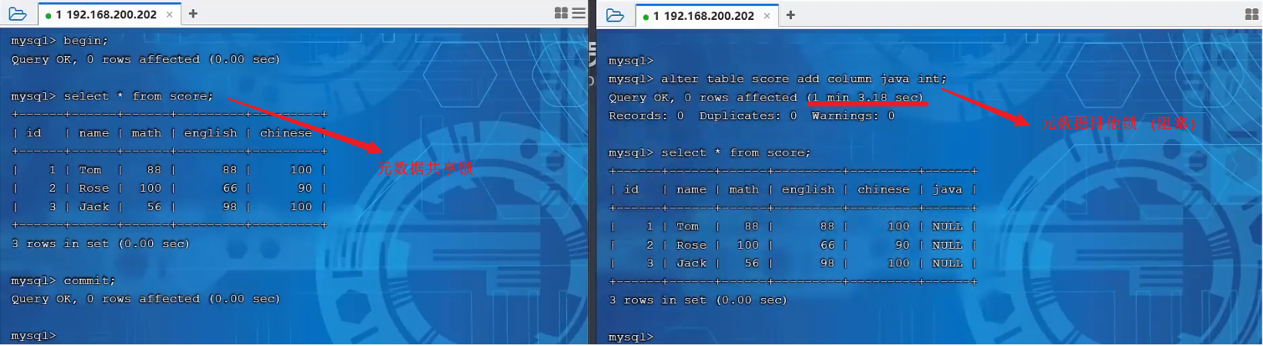
我们可以通过下面的 SQL,来查看数据库中的元数据锁的情况:
select object_type,object_schema,object_name,lock_type,lock_duration from performance_schema.metadata_locks ;(4)意向锁
1)介绍
为了避免 DML 在执行时,加的行锁与表锁的冲突,在 InnoDB 中引入了意向锁,使得表锁不用检查每行数据是否加锁,使用意向锁来减少表锁的检查
假如没有意向锁:
客户端一对表加了行锁后,客户端二如果想给表加表锁,需要检查表中每一行数据是否存在行锁,从第一行一直检查到最后一行,效率很低
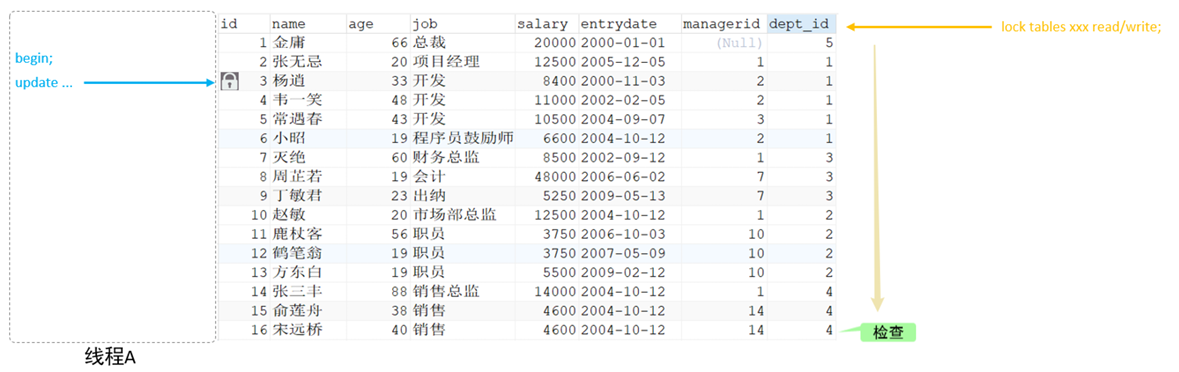
有了意向锁之后:
客户端一,在执行 DML 操作时,会对涉及的行加行锁,同时也会对该表加上意向锁。 而其他客户端,在对这张表加表锁的时候,会根据该表上所加的意向锁来判定是否可以成功加表锁,而不用逐行判断行锁情况了
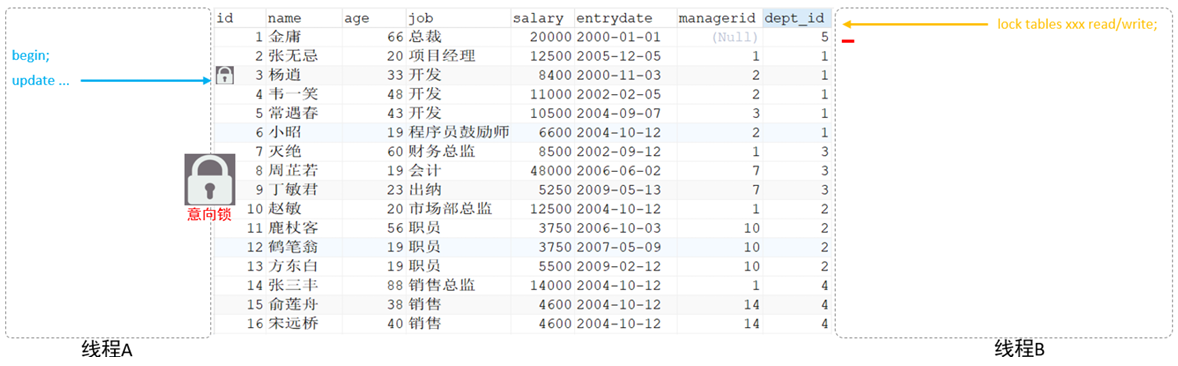
2)分类
-
意向共享锁(IS)
select ... lock in share mode与表锁共享锁(read)兼容,与表锁排他锁(write)互斥
-
意向排他锁(IX)
insert、update、delete、select...for update与表锁共享锁(read)及排他锁(write)都互斥,意向锁之间不会互斥
一旦事务提交了,意向共享锁、意向排他锁,都会自动释放
可以通过以下 SQL,查看意向锁及行锁的加锁情况:
select object_schema,object_name,index_name,lock_type,lock_mode,lock_data from performance_schema.data_locks;示例:
A. 意向共享锁与表读锁是兼容的
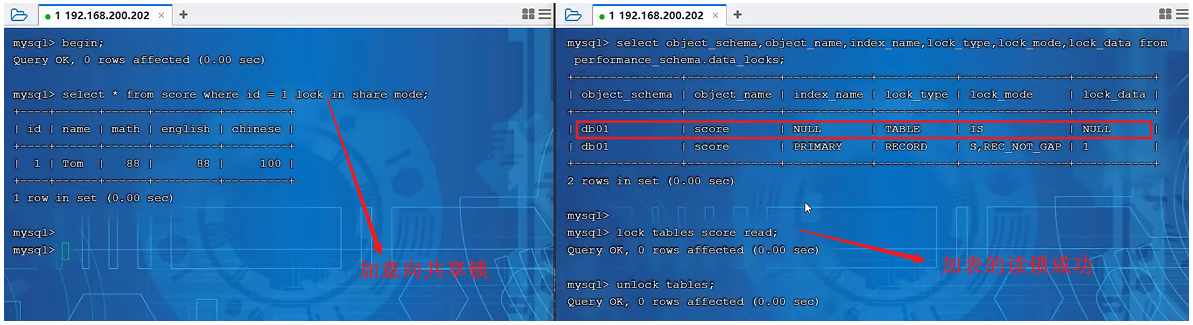
B. 意向排他锁与表读锁、写锁都是互斥的
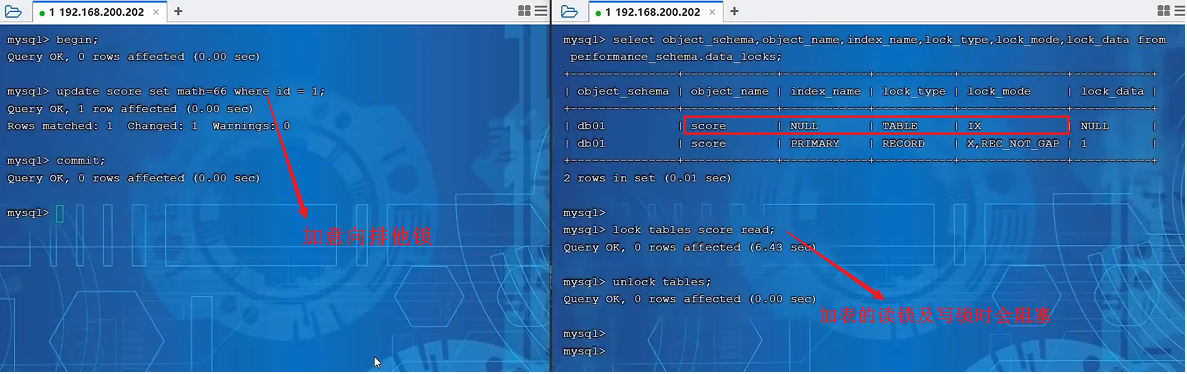
4、行级锁
(1)介绍
行级锁,每次操作锁住对应的行数据。锁定粒度最小,发生锁冲突的概率最低,并发度最高。应用在 InnoDB 存储引擎中
InnoDB 的数据是基于索引组织的,行锁是通过对索引上的索引项加锁来实现的,而不是对记录加的锁。对于行锁,主要分为以下三类:
-
行锁(Record Lock):锁定单个行记录的锁,防止其他事务对此行进行 update 和 delete。在 RC、RR 隔离级别下都支持
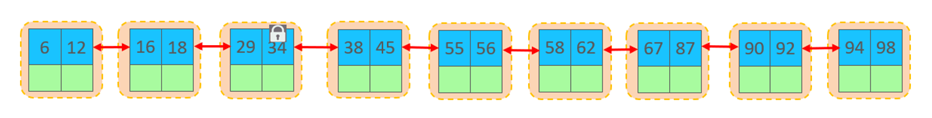
-
间隙锁(Gap Lock):锁定索引记录间隙(不含该记录),确保索引记录间隙不变,防止其他事务在这个间隙进行 insert,产生幻读。在 RR 隔离级别下都支持
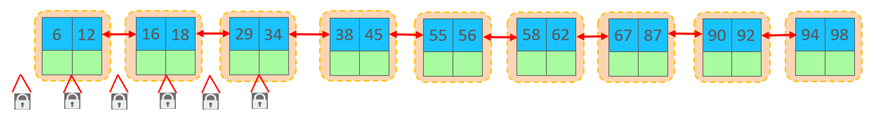
-
临键锁(Next-Key Lock):行锁和间隙锁组合,同时锁住数据,并锁住数据前面的间隙 Gap。在 RR 隔离级别下支持
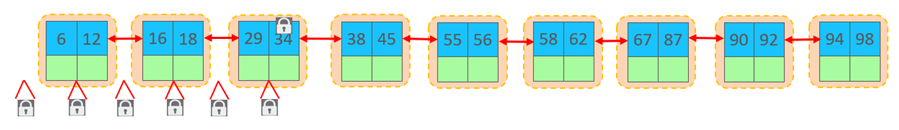
(2)行锁
1)介绍
InnoDB 实现了以下两种类型的行锁:
- 共享锁(S):允许一个事务去读一行,阻止其他事务获得相同数据集的排他锁
- 排他锁(X):允许获取排他锁的事务更新数据,阻止其他事务获得相同数据集的共享锁和排他锁
两种行锁的兼容情况:
| 当前锁类型 \ 请求锁类型 | S(共享锁) | X(排他锁) |
|---|---|---|
| S(共享锁) | 兼容 | 冲突 |
| X(排他锁) | 冲突 | 冲突 |
常见的 SQL 语句,在执行时,所加的行锁如下:
| SQL | 行锁类型 | 说明 |
|---|---|---|
| INSERT … | 排他锁 | 自动加锁 |
| UPDATE … | 排他锁 | 自动加锁 |
| DELETE … | 排他锁 | 自动加锁 |
| SELECT(正常) | 不加任何锁 | |
| SELECT … LOCK IN SHARE MODE | 共享锁 | 需要手动在 SELECT 之后加 LOCK IN SHARE MODE |
| SELECT … FOR UPDATE | 排他锁 | 需要手动在 SELECT 之后加 FOR UPDATE |
默认情况下,InnoDB 在 REPEATABLE READ 事务隔离级别运行,InnoDB 使用 next-key 锁进行搜索和索引扫描,以防止幻读
- 针对唯一索引进行检索时,对已存在的记录进行等值匹配时,将会自动优化为行锁
- InnoDB 的行锁是针对于索引加的锁,不通过索引条件检索数据(如通过不加索引的
name = 'lily'检索数据),那么 InnoDB 将对表中的所有记录加锁,此时就会升级为表锁
(3)间隙锁 & 临键锁
默认情况下,InnoDB 在 REPEATABLE READ 事务隔离级别运行,InnoDB 使用 next-key 锁进行搜索和索引扫描,以防止幻读
-
索引上的等值查询(唯一索引),给不存在的记录加锁时,优化为间隙锁
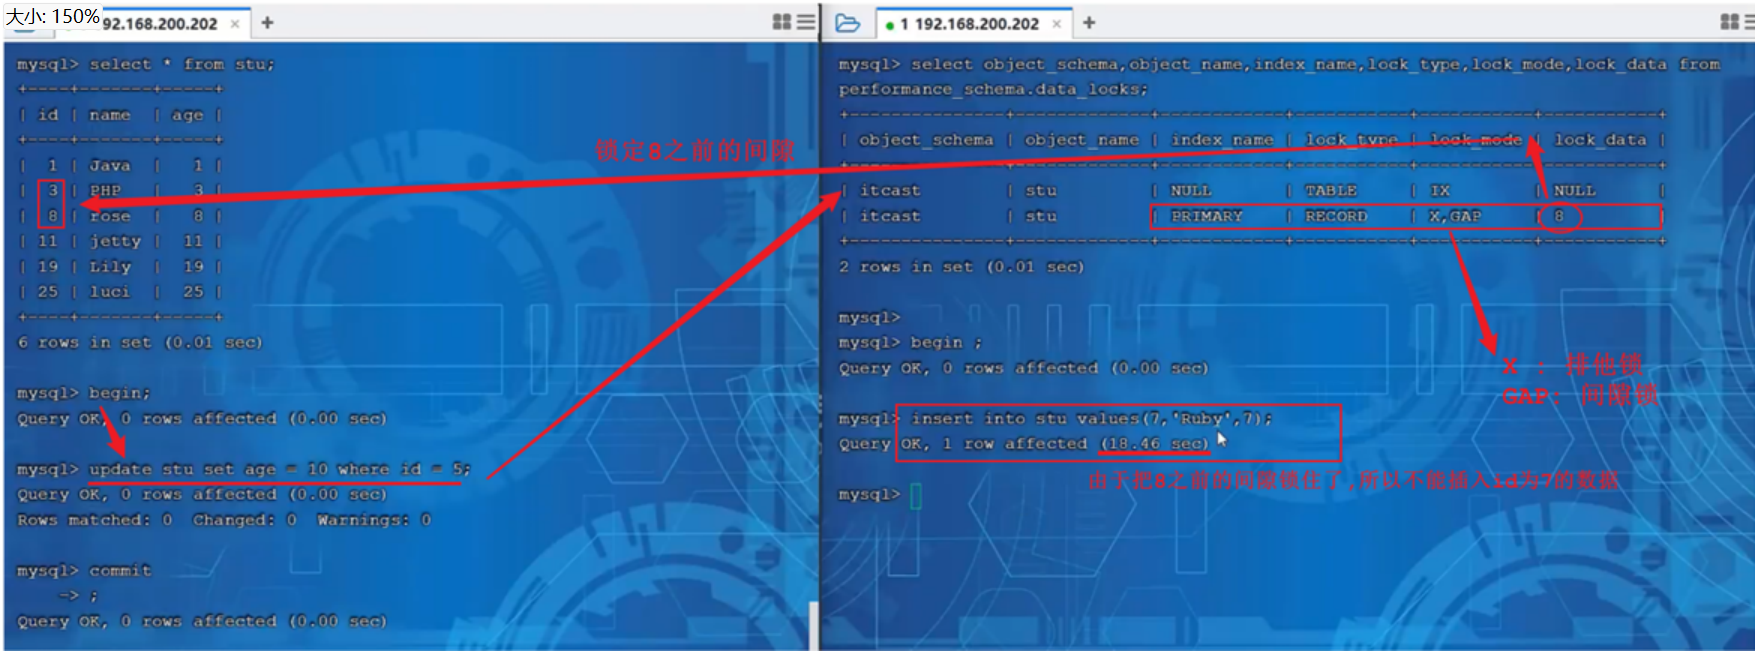
-
索引上的等值查询(非唯一普通索引),向右遍历时最后一个值不满足查询需求时,next-key lock 退化为间隙锁
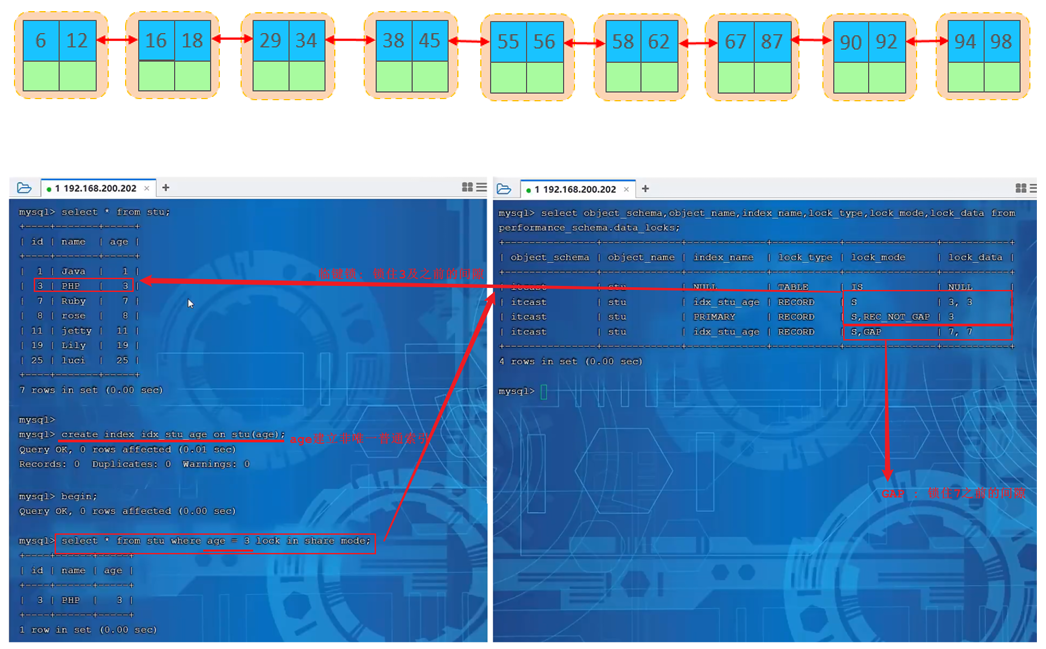
-
索引上的范围查询(唯一索引),会访问到不满足条件的第一个值为止
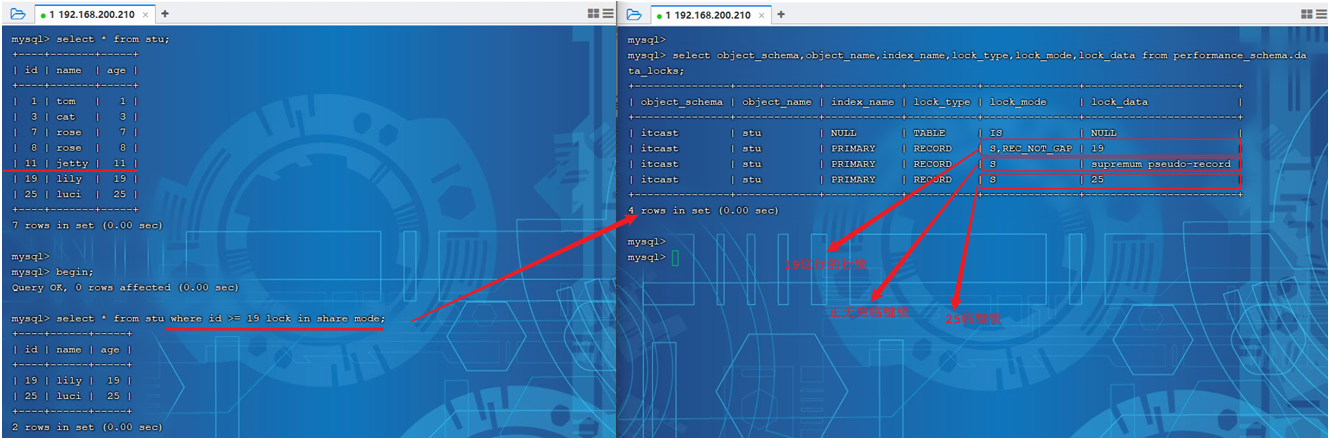
注意:
间隙锁唯一目的是防止其他事务插入间隙。间隙锁可以共存,一个事务采用的间隙锁不会阻止另一个事务在同一间隙上采用间隙锁
十四、MySQL 进阶之 —— InnoDB 引擎
1、逻辑存储结构
InnoDB 的逻辑存储结构如下图所示:
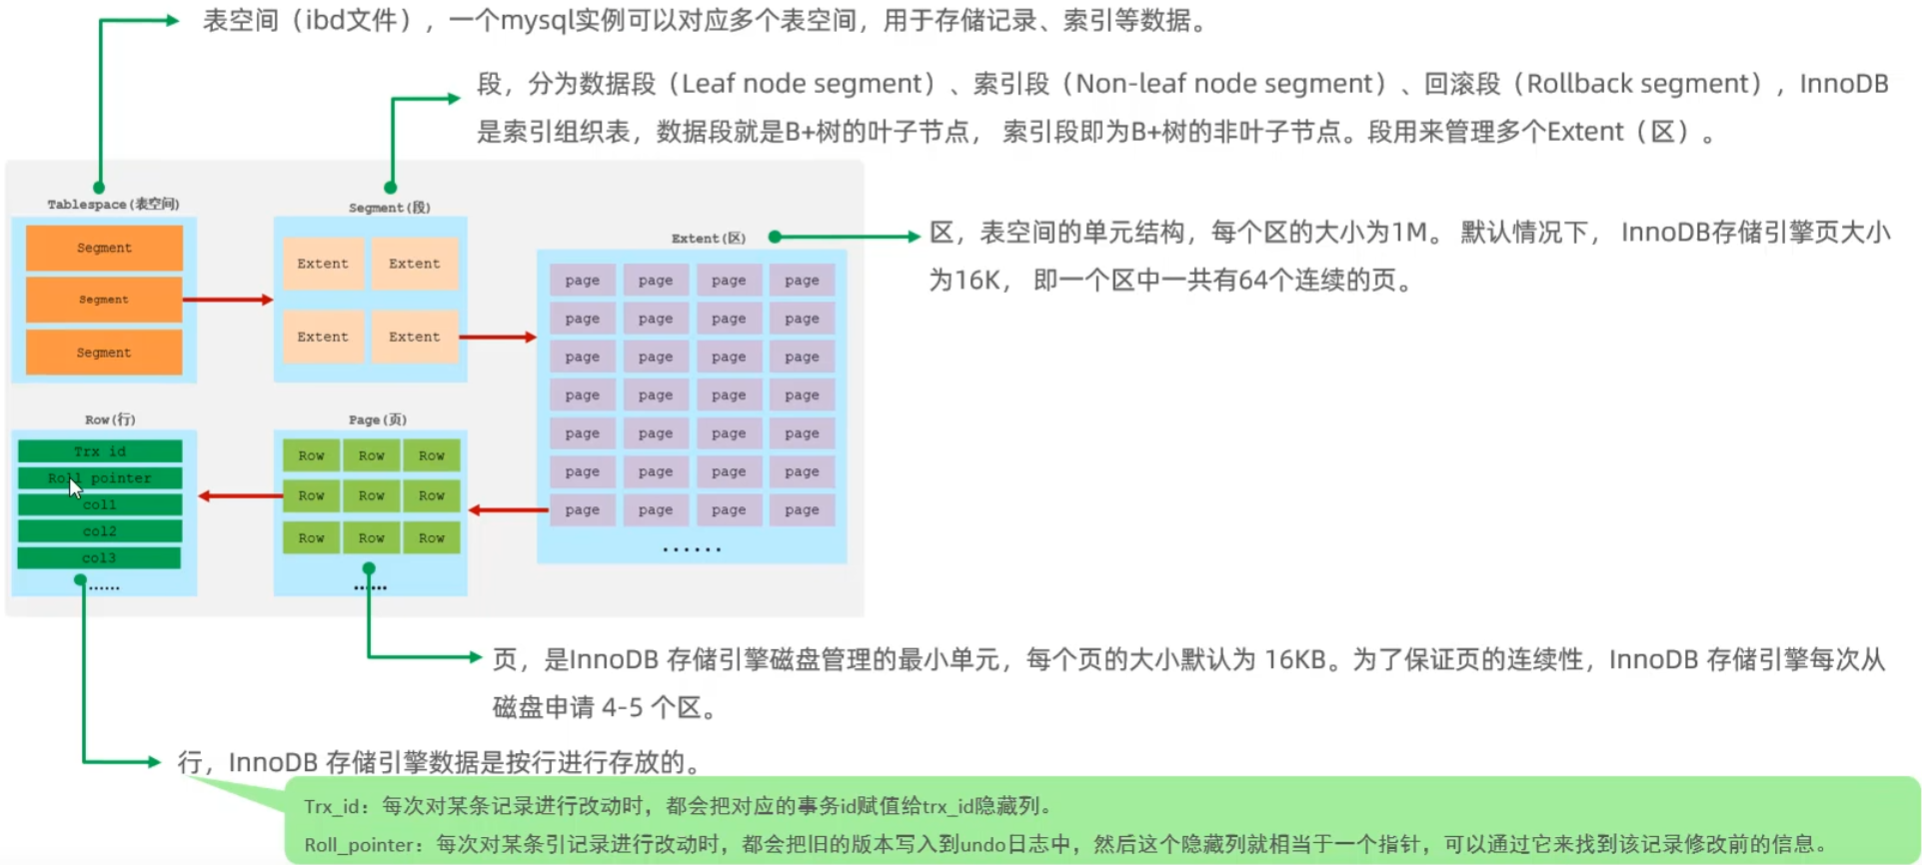
(1)表空间
表空间是 InnoDB 存储引擎逻辑结构的最高层,如果用户启用了参数 innodb_file_per_table(在 8.0 版本中默认开启) ,则每张表都会有一个表空间(xxx.ibd),一个 mysql 实例可以对应多个表空间,用于存储记录、索引等数据
(2)段
段,分为数据段(Leaf node segment)、索引段(Non-leaf node segment)、回滚段(Rollback segment),InnoDB 是索引组织表,数据段就是 B+ 树的叶子节点,索引段即为 B+ 树的非叶子节点。段用来管理多个 Extent(区)
(3)区
区,表空间的单元结构,每个区的大小为 1M。 默认情况下, InnoDB 存储引擎页大小为 16K, 即一个区中一共有 64 个连续的页
(4)页
页,是 InnoDB 存储引擎磁盘管理的最小单元,每个页的大小默认为 16KB。为了保证页的连续性,InnoDB 存储引擎每次从磁盘申请 4-5 个区
(5)行
行,InnoDB 存储引擎数据是按行进行存放的。在行中,默认有两个隐藏字段:
- Trx_id:每次对某条记录进行改动时,都会把对应的事务 id 赋值给 trx_id 隐藏列
- Roll_pointer:每次对某条引记录进行改动时,都会把旧的版本写入到 undo 日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修改前的信息
2、架构
MySQL5.5 版本开始,默认使用 InnoDB 存储引擎,它擅长事务处理,具有崩溃恢复特性,在日常开发中使用非常广泛。下面是 InnoDB 架构图,左侧为内存结构,右侧为磁盘结构
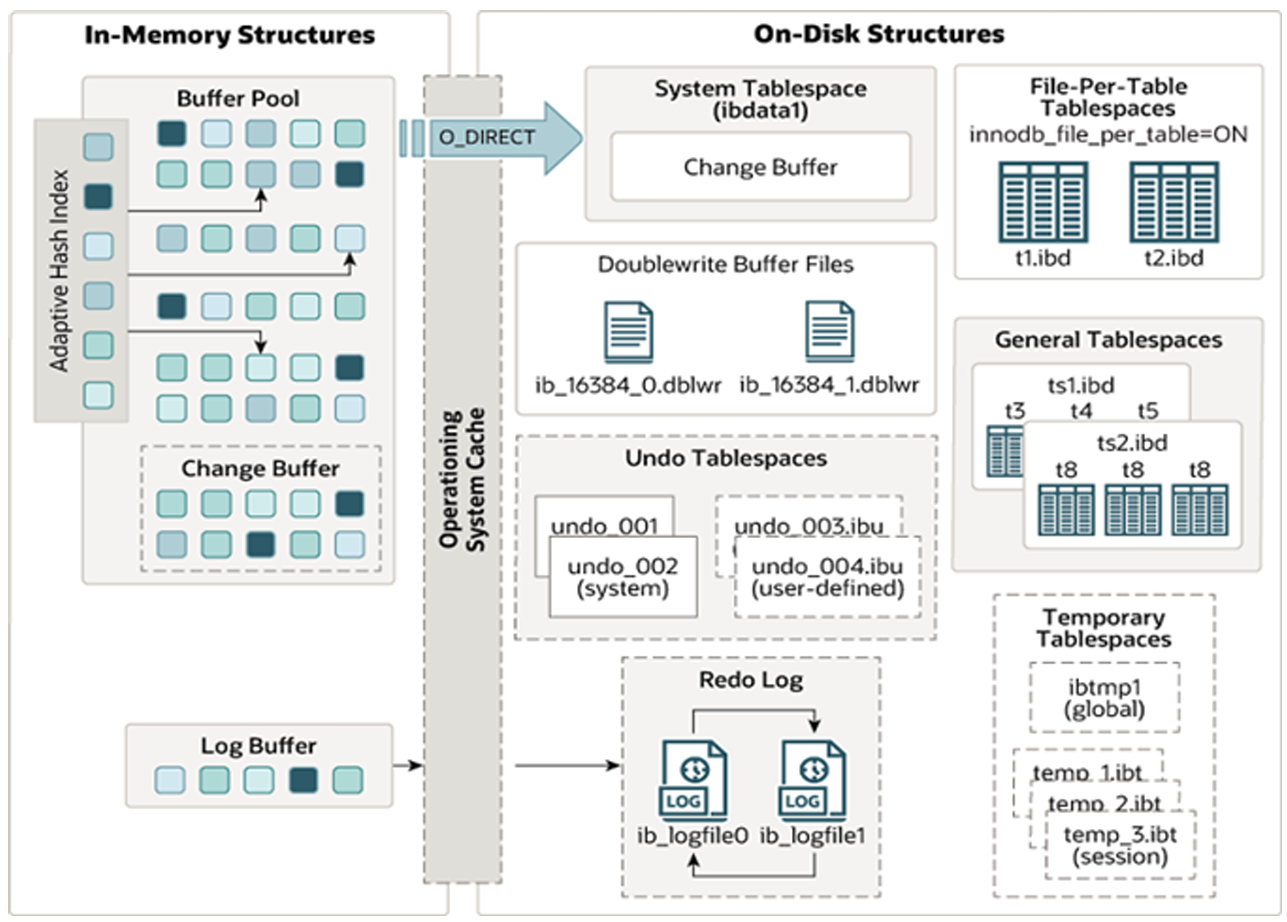
(1)内存结构
在左侧的内存结构中,主要分为四大块:
- Buffer Pool、
- Change Buffer、
- Adaptive Hash Index、
- Log Buffer
1)Buffer Pool 缓冲池
InnoDB 存储引擎基于磁盘文件存储,访问物理硬盘和在内存中进行访问,速度相差很大,为了尽可能弥补这两者之间的 I / O 效率的差值,就需要把经常使用的数据加载到缓冲池中,避免每次访问都进行磁盘 I / O
在 InnoDB 的缓冲池中不仅缓存了索引页和数据页,还包含了 undo 页、插入缓存、自适应哈希索引以及 InnoDB 的锁信息等等
缓冲池 Buffer Pool,是主内存中的一个区域,里面可以缓存磁盘上经常操作的真实数据,在执行增删改查操作时,先操作缓冲池中的数据(若缓冲池没有数据,则从磁盘加载并缓存),然后再以一定频率刷新到磁盘,从而减少磁盘 IO,加快处理速度
缓冲池以 Page 页为单位,底层采用链表数据结构管理 Page。根据状态,将 Page 分为三种类型:
- free page:空闲 page,未被使用
- clean page:被使用 page,数据没有被修改过
- dirty page:脏页,被使用 page,数据被修改过,页中数据与磁盘的数据产生了不一致
在专用服务器上,通常将多达 80% 的物理内存分配给缓冲池
参数设置:
show variables like 'innodb_buffer_pool_size';2)Change Buffer 更改缓冲区
更改缓冲区(针对于非唯一二级索引页),在执行 DML 语句时,如果这些数据 Page 没有在 Buffer Pool 中,不会直接操作磁盘,而会将数据变更存在更改缓冲区 Change Buffer 中,在未来数据被读取时,再将数据合并恢复到 Buffer Pool 中,再将合并后的数据刷新到磁盘中
与聚集索引不同,二级索引通常是非唯一的,并且以相对随机的顺序插入二级索引。同样,删除和更新可能会影响索引树中不相邻的二级索引页,如果每一次都操作磁盘,会造成大量的磁盘 IO。有了 ChangeBuffer 之后,我们可以在缓冲池中进行合并处理,减少磁盘 IO
3)Adaptive Hash Index 自适应 hash 索引
用于优化对 Buffer Pool 数据的查询。MySQL 的 innoDB 引擎中虽然没有直接支持 hash 索引,但是给我们提供了一个功能就是这个自适应 hash 索引。因为前面我们讲到过,hash 索引在进行等值匹配时,一般性能是要高于 B+ 树的,因为 hash 索引一般只需要一次 IO 即可,而 B+ 树,可能需要几次匹配,所以 hash 索引的效率要高,但是 hash 索引又不适合做范围查询、模糊匹配等
InnoDB 存储引擎会监控对表上各索引页的查询,如果观察到在特定的条件下 hash 索引可以提升速度,则建立 hash 索引,称之为自适应 hash 索引,无需人工干预,是系统根据情况自动完成
参数:
adaptive_hash_index4)Log Buffer Log Buffer 日志缓冲区
用来保存要写入到磁盘中的 log 日志数据(redo log 、undo log),默认大小为 16MB,日志缓冲区的日志会定期刷新到磁盘中。如果需要更新、插入或删除许多行的事务,增加日志缓冲区的大小可以节省磁盘 I / O
参数:
-
innodb_log_buffer_size:缓冲区大小
-
innodb_flush_log_at_trx_commit:日志刷新到磁盘时机
取值主要包含以下三个:
0:每秒将日志写入并刷新到磁盘一次
1:日志在每次事务提交时写入并刷新到磁盘,默认值
2:日志在每次事务提交后写入,并每秒刷新到磁盘一次
(2)磁盘结构
接下来,再来看看 InnoDB 体系结构的右边部分,也就是磁盘结构:
1)System Tablespace
系统表空间,是更改缓冲区的存储区域。如果表是在系统表空间而不是每个表文件或通用表空间中创建的,它也可能包含表和索引数据(在 MySQL5.x 版本中还包含 InnoDB 数据字典、undo log 等)
参数:
innodb_data_file_path 系统表空间,默认的文件名叫 ibdata12)File-Per-Table Tablespaces
如果开启了 innodb_file_per_table 开关,则每个表的文件表空间包含单个 InnoDB 表的数据和索引,并存储在文件系统上的单个数据文件中
开关参数:
innodb_file_per_table
该参数默认开启。那也就是说,我们每创建一个表,都会产生一个表空间文件
3)General Tablespaces
通用表空间,需要通过 CREATE TABLESPACE 语法创建通用表空间,在创建表时,可以指定该表空间
A.创建表空间
CREATE TABLESPACE ts_name ADD DATAFILE 'file_name' ENGINE = engine_name;B.创建表时指定表空间
CREATE TABLE xxx ... TABLESPACE ts_name;4)Undo Tablespaces
撤销表空间,MySQL 实例在初始化时会自动创建两个默认的 undo 表空间(初始大小16M),用于存储 undo log 日志
5)Temporary Tablespaces InnoDB
使用会话临时表空间和全局临时表空间,存储用户创建的临时表等数据
6)Doublewrite Buffer Files
双写缓冲区,innoDB 引擎将数据页从 Buffer Pool 刷新到磁盘前,先将数据页写入双写缓冲区文件中,便于系统异常时恢复数据
文件:
ib_16384_0.dblwr
ib_16384_1.dblwr
7)Redo Log
重做日志,是用来实现事务的持久性。该日志文件由两部分组成:
- 重做日志缓冲(redo log buffer)
- 重做日志文件(redo log)
前者是在内存中,后者在磁盘中。当事务提交之后会把所有修改信息都会存到该日志中,用于在刷新脏页到磁盘时,发生错误时,进行数据恢复使用。 以循环方式写入重做日志文件
涉及两个文件:
ib_logfile0
ib_logfile1
(3)后台线程
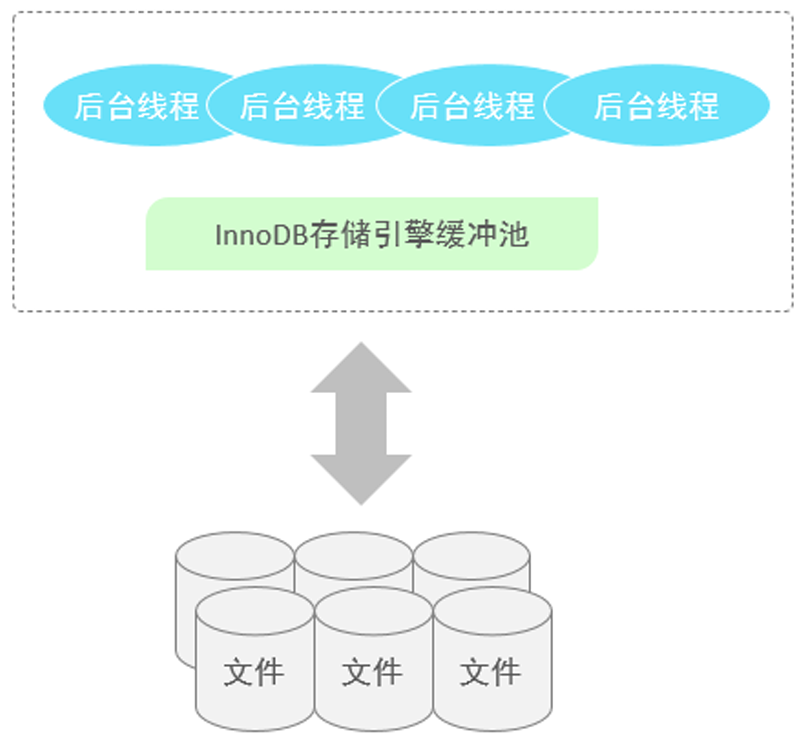
在 InnoDB 的后台线程中,分为 4 类,分别是:
- Master Thread
- IO Thread
- Purge Thread
- Page Cleaner Thread
1)Master Thread
核心后台线程,负责调度其他线程,还负责将缓冲池中的数据异步刷新到磁盘中,保持数据的一致性,还包括脏页的刷新、合并插入缓存、undo 页的回收
2)IO Thread
在 InnoDB 存储引擎中大量使用了 AIO 来处理 IO 请求,这样可以极大地提高数据库的性能,而 IO Thread 主要负责这些 IO 请求的回调
| 线程类型 | 默认个数 | 职责 |
|---|---|---|
| Read thread | 4 | 负责读操作 |
| Write thread | 4 | 负责写操作 |
| Log thread | 1 | 负责将日志缓冲区刷新到磁盘 |
| Insert buffer thread | 1 | 负责将写缓冲区内容刷新到磁盘 |
我们可以通过以下的这条指令,查看到 InnoDB 的状态信息,其中就包含 IO Thread 信息
show engine innodb status \G;3)Purge Thread
主要用于回收事务已经提交了的 undo log,在事务提交之后,undo log 可能不用了,就用它来回收
4)Page Cleaner Thread
协助 Master Thread 刷新脏页到磁盘的线程,它可以减轻 Master Thread 的工作压力,减少阻塞
3、事务原理
(1)事务基础
1)事务
事务是一组操作的集合,它是一个不可分割的工作单位,事务会把所有的操作作为一个整体一起向系统提交或撤销操作请求,即这些操作要么同时成功,要么同时失败
2)特性
- 原子性(Atomicity):事务是不可分割的最小操作单元,要么全部成功,要么全部失败
- 一致性(Consistency):事务完成时,必须使所有的数据都保持一致状态
- 隔离性(Isolation):数据库系统提供的隔离机制,保证事务在不受外部并发操作影响的独立环境下运行
- 持久性(Durability):事务一旦提交或回滚,它对数据库中的数据的改变就是永久的
研究事务的原理,就是研究 MySQL 的 InnoDB 引擎是如何保证事务的这四大特性的
而对于这四大特性,实际上分为两个部分。其中的原子性、一致性、持久性,实际上是由 InnoDB 中的两份日志来保证的,一份是 redo log 日志,一份是 undo log 日志。而隔离性是通过数据库的锁,加上 MVCC(多版本并发控制)来保证的
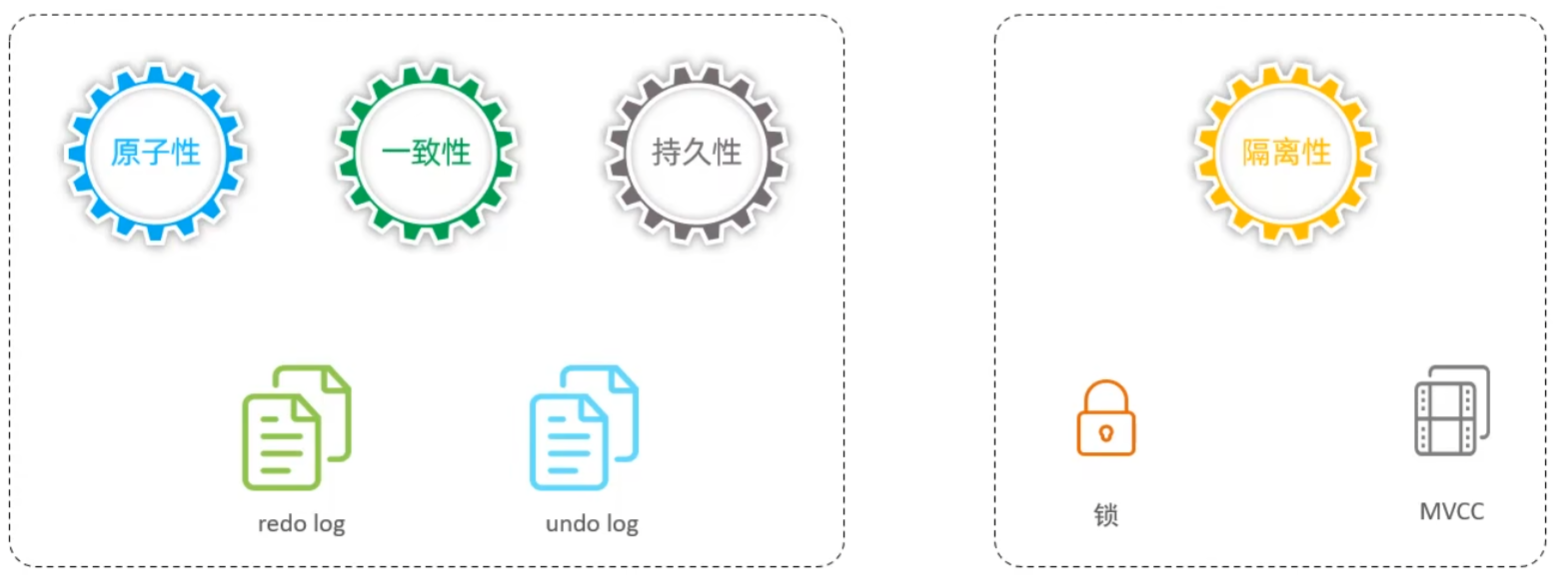
(2)redolog
redolog 用于解决持久性的问题
redolog,即重做日志,记录的是事务提交时数据页的物理修改,是用来实现事务的持久性
该日志文件由两部分组成:重做日志缓冲(redo log buffer)以及重做日志文件(redo log file),前者是在内存中,后者在磁盘中。当事务提交之后会把所有修改信息都存到该日志文件中,用于在刷新脏页到磁盘,发生错误时,进行数据恢复使用
当对缓冲区的数据进行增删改之后,会首先将操作的数据页的变化,记录在 redo log buffer 中。在事务提交时,会将 redo log buffer 中的数据刷新到 redo log 磁盘文件中。过一段时间之后,如果刷新缓冲区的脏页到磁盘时,发生错误,此时就可以借助于 redo log 进行数据恢复,这样就保证了事务的持久性。 而如果脏页成功刷新到磁盘或涉及到的数据已经落盘,此时 redolog 就没有作用了,就可以删除了,所以存在的两个 redolog 文件是循环写的
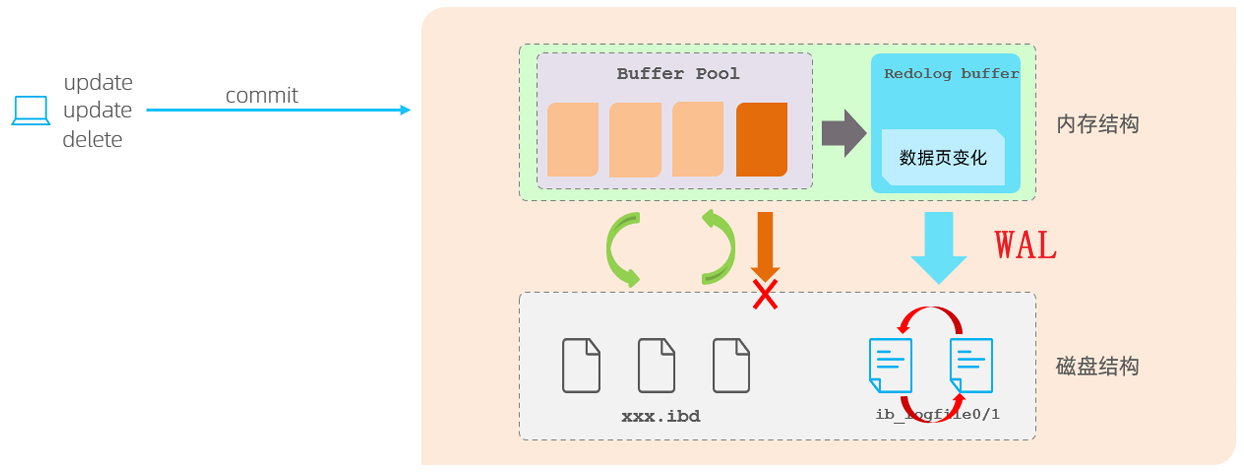
为什么每一次提交事务,要刷新 redo log 到磁盘中呢,而不是直接将 buffer pool 中的脏页刷新到磁盘呢?
因为在业务操作中,我们操作数据一般都是随机读写磁盘的,而不是顺序读写磁盘。 而 redo log 在往磁盘文件中写入数据,由于是日志文件,所以都是顺序写的。顺序写的效率,要远大于随机写。 这种先写日志的方式,称之为 WAL(Write-Ahead Logging)
(3)undolog
undolog 用于解决原子性的问题
undolog,即回滚日志,用于记录数据被修改前的信息,作用包含两个:
- 提供回滚(保证事务的原子性)
- MVCC(多版本并发控制)
undo log 和 redo log 记录物理日志不一样,它是逻辑日志。可以认为当 delete 一条记录时,undo log 中会记录一条对应的 insert 记录,反之亦然,当 update 一条记录时,它记录一条相应相反的 update 记录。当执行 rollback 时,就可以从 undo log 中的逻辑记录读取到相应的内容并进行回滚
- Undo log 销毁:undo log 在事务执行时产生,事务提交时,并不会立即删除 undo log,因为这些日志可能还用于 MVCC
- Undo log 存储:undo log 采用段的方式进行管理和记录,存放在前面介绍的 rollback segment 回滚段中,内部包含 1024 个 undo log segment
4、MVCC
(1)概念
1)当前读
读取的是记录的最新版本,读取时还要保证其他并发事务不能修改当前记录,会对读取的记录进行加锁
对于我们日常的操作,如:select ... lock in share mode(共享锁),select ... for update、update、insert、delete(排他锁)都是一种当前读
测试:
在测试中我们可以看到,即使是在默认的RR隔离级别下,事务A中依然可以读取到事务B最新提交的内容,因为在查询语句后面加上了 lock in share mode 共享锁,此时是当前读操作。当然,当我们加排他锁的时候,也是当前读操作。
2)快照读
简单的 select(不加锁)就是快照读,快照读,读取的是记录数据的可见版本,有可能是历史数据,不加锁,是非阻塞读
- Read Committed:每次 select,都生成一个快照读
- Repeatable Read:开启事务后第一个 select 语句才是快照读的地方
- Serializable:快照读会退化为当前读
同时开启两个事务,即使事务 B 提交了数据,事务 A 中也查询不到,原因就是因为普通的 select 是快照读,而在当前默认的 RR 隔离级别下,开启事务后第一个 select 语句才是快照读的地方,后面执行相同的 select 语句都是从快照中获取数据,可能不是当前的最新数据,这样也就保证了可重复读
3)MVCC
全称 Multi-Version Concurrency Control,多版本并发控制。指维护一个数据的多个版本,使得读写操作没有冲突,快照读为 MySQL 实现 MVCC 提供了一个非阻塞读功能。MVCC 的具体实现,还需要依赖于数据库记录中的三个隐式字段、undo log 日志、readView
(2)隐藏字段
1)介绍
当我们创建一张表,可以显式的看到字段,实际上除了显式的字段以外,InnoDB 还会自动的给我们添加隐藏字段:
| 隐藏字段 | 含义 |
|---|---|
| DB_TRX_ID | 最近修改事务 ID,记录插入这条记录或最后一次修改该记录的事务 ID |
| DB_ROLL_PTR | 回滚指针,指向这条记录的上一个版本,用于配合 undo log,指向上一个版本 |
| DB_ROW_ID | 隐藏主键,如果表结构没有指定主键,将会生成该隐藏字段 |
2)查看
查看有主键的表 stu
进入服务器中的 /var/lib/mysql/itcast/,查看 stu 的表结构信息,通过如下指令:
ibd2sdi stu.ibd查看到的表结构信息中,有一栏 columns,在其中我们会看到处理我们建表时指定的字段以外,还有额外的两个字段,分别是:DB_TRX_ID 、 DB_ROLL_PTR ,因为该表有主键,所以没有 DB_ROW_ID 隐藏字段
(3)undolog 版本链
1)介绍
回滚日志,在 insert、update、delete 的时候产生的便于数据回滚的日志
- 当 insert 的时候,产生的 undo log 日志只在回滚时需要,在事务提交后,可被立即删除
- 而 update、delete 的时候,产生的 undo log 日志不仅在回滚时需要,在快照读时也需要,不会立即被删除
2)undolog 版本链
有一张表原始数据为:
| id | age | name | DB_TRX_ID | DB_ROLL_PTR |
|---|---|---|---|---|
| 30 | 30 | A30 | 1 | null |
DB_TRX_ID:代表最近修改事务 ID,记录插入这条记录或最后一次修改该记录的事务 ID,是自增
DB_ROLL_PTR:由于这条数据是才插入的,没有被更新过,所以该字段值为 null
有四个并发事务同时在访问这张表:
A.第一步
| 事务2 | 事务3 | 事务4 | 事务5 |
|---|---|---|---|
| 开始事务 | 开始事务 | 开始事务 | 开始事务 |
| 修改 id 为 30 记录,age 改为 3 | 查询 id 为 30 的记录 | ||
| 提交事务 | 修改 id 为 30 记录,name 改为 A3 | 查询 id 为 30 的记录 | |
| 提交事务 | 修改 id 为 30 记录,age改为 10 | ||
| 查询 id 为 30 的记录 | 查询 id 为 30 的记录 | ||
| 提交事务 |
当事务 2 执行第一条修改语句时,会记录 undo log 日志,记录数据变更之前的样子;然后更新记录,并且记录本次操作的事务 ID,回滚指针,回滚指针用来指定如果发生回滚,回滚到哪一个版本
| id | age | name | DB_TRX_ID | DB_ROLL_PTR |
|---|---|---|---|---|
| 30 | 3 | A30 | 2 | 0x00001 |
B.第二步
| 事务2 | 事务3 | 事务4 | 事务5 |
|---|---|---|---|
| 开始事务 | 开始事务 | 开始事务 | 开始事务 |
| 修改 id 为 30 记录,age 改为 3 | 查询 id 为 30 的记录 | ||
| 提交事务 | 修改 id 为 30 记录,name 改为 A3 | 查询 id 为 30 的记录 | |
| 提交事务 | 修改id为30记录,age改为10 | ||
| 查询 id 为 30 的记录 | 查询 id 为 30 的记录 | ||
| 提交事务 |
当事务 3 执行第一条修改语句时,也会记录 undo log 日志,记录数据变更之前的样子;然后更新记录,并且记录本次操作的事务 ID,回滚指针,回滚指针用来指定如果发生回滚,回滚到哪一个版本
| id | age | name | DB_TRX_ID | DB_ROLL_PTR |
|---|---|---|---|---|
| 30 | 3 | A3 | 3 | 0x00002 |
C.第三步
| 事务2 | 事务3 | 事务4 | 事务5 |
|---|---|---|---|
| 开始事务 | 开始事务 | 开始事务 | 开始事务 |
| 修改 id 为 30 记录,age 改为 3 | 查询 id 为 30 的记录 | ||
| 提交事务 | 修改 id 为 30 记录,name 改为 A3 | 查询 id 为 30 的记录 | |
| 提交事务 | 修改 id 为 30 记录,age 改为 10 | ||
| 查询 id 为 30 的记录 | 查询 id 为 30 的记录 | ||
| 提交事务 |
当事务 4 执行第一条修改语句时,也会记录 undo log 日志,记录数据变更之前的样子;然后更新记录,并且记录本次操作的事务 ID,回滚指针,回滚指针用来指定如果发生回滚,回滚到哪一个版本
最终我们发现,不同事务或相同事务对同一条记录进行修改,会导致该记录的 undolog 生成一条记录版本链表,链表的头部是最新的旧记录,链表尾部是最早的旧记录
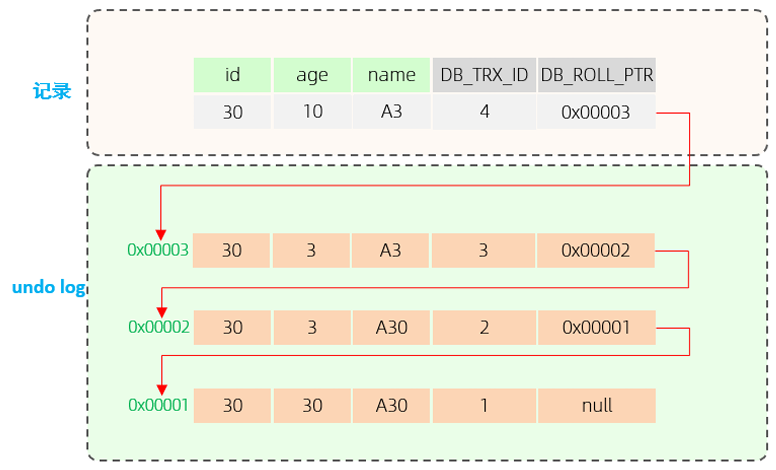
(4)readview 介绍
ReadView(读视图)是快照读 SQL 执行时 MVCC 提取数据的依据,记录并维护系统当前活跃的事务(未提交的)id
ReadView 中包含了四个核心字段:
| 字段 | 含义 |
|---|---|
| m_ids | 当前活跃的事务 ID 集合 |
| min_trx_id | 最小活跃事务 ID |
| max_trx_id | 预分配事务 ID,当前最大事务 ID+1(因为事务 ID 是自增的) |
| creator_trx_id | ReadView 创建者的事务 ID |
而在 readview 中就规定了版本链数据的访问规则:
| 条件 | 是否可以访问 | 说明 |
|---|---|---|
| trx_id == creator_trx_id | 可以访问该版本 | 成立,说明数据是当前这个事务更改的 |
| trx_id < min_trx_id | 可以访问该版本 | 成立,说明数据已经提交了 |
| trx_id > max_trx_id | 不可以访问该版本 | 成立,说明该事务是在ReadView生成后才开启 |
| min_trx_id <= trx_id <= max_trx_id | 如果 trx_id 不在 m_ids 中,是可以访问该版本的 | 成立,说明数据已经提交 |
其中 trx_id 代表当前 undolog 版本链对应事务 ID
不同的隔离级别,生成 ReadView 的时机不同:
- READ COMMITTED(RC 隔离级别):在事务中每一次执行快照读时生成 ReadView
- REPEATABLE READ(RR 隔离级别):仅在事务中第一次执行快照读时生成 ReadView,后续复用该 ReadView
(5)原理分析 —— RC 隔离级别
RC 隔离级别下,在事务中每一次执行快照读时生成 ReadView
我们来分析事务 5 中,两次快照读读取数据,是如何获取数据的:
在事务 5 中,查询了两次 id 为 30 的记录,由于隔离级别为 Read Committed,所以每一次进行快照读都会生成一个 ReadView,那么两次生成的 ReadView 如下
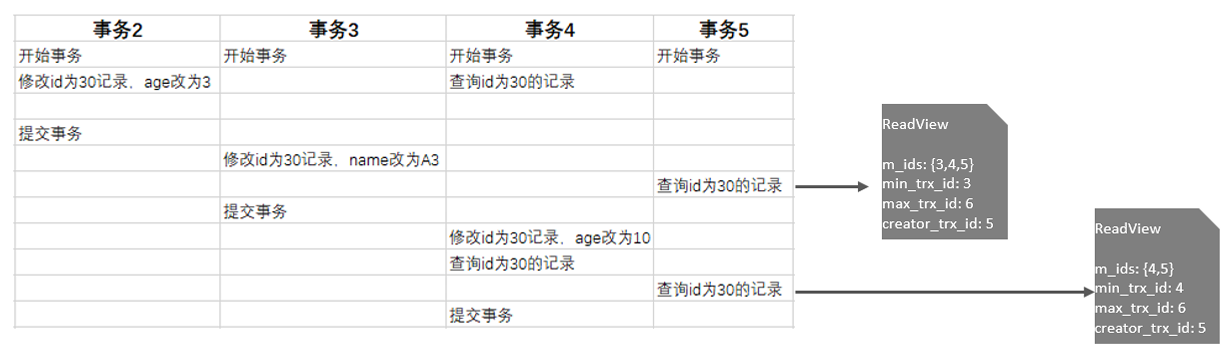
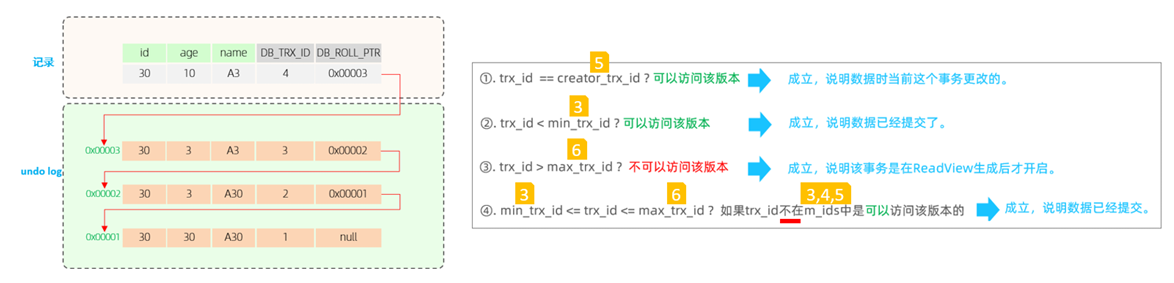
那么这两次快照读在获取数据时,就需要根据所生成的 ReadView 以及 ReadView 的版本链访问规则,到 undolog 版本链中匹配数据,最终决定此次快照读返回的数据
A.先来看第一次快照具体的读取过程
在进行匹配时,会从 undo log 的版本链,从上到下进行挨个匹配:
-
先匹配这条记录,这条记录对应的 trx_id 为 4,也就是将 4 带入右侧的匹配规则中:
①不满足 ②不满足 ③不满足 ④也不满足,都不满足,则继续匹配 undo log 版本链的下一条
-
再匹配第二条,这条记录对应的 trx_id 为3,也就是将 3 带入右侧的匹配规则中:
①不满足 ②不满足 ③不满足 ④也不满足,都不满足,则继续匹配 undo log 版本链的下一条
-
再匹配第三条,这条记录对应的 trx_id 为 2,也就是将 2 带入右侧的匹配规则中
①不满足 ②满足,终止匹配,此次快照读,返回的数据就是版本链中记录的这条数据
B.再来看第二次快照读具体的读取过程
在进行匹配时,会从 undo log 的版本链,从上到下进行挨个匹配:
-
先匹配这条记录,这条记录对应的 trx_id 为 4,也就是将 4 带入右侧的匹配规则中
①不满足 ②不满足 ③不满足 ④也不满足,都不满足,则继续匹配 undo log 版本链的下一条
-
再匹配第二条,这条记录对应的 trx_id 为 3,也就是将 3 带入右侧的匹配规则中
①不满足 ②满足。终止匹配,此次快照读,返回的数据就是版本链中记录的这条数据
(6)原理分析 —— RR 隔离级别
RR 隔离级别下,仅在事务中第一次执行快照读时生成 ReadView,后续复用该 ReadView。而 RR 是可重复读,在一个事务中,执行两次相同的 select 语句,查询到的结果是一样的
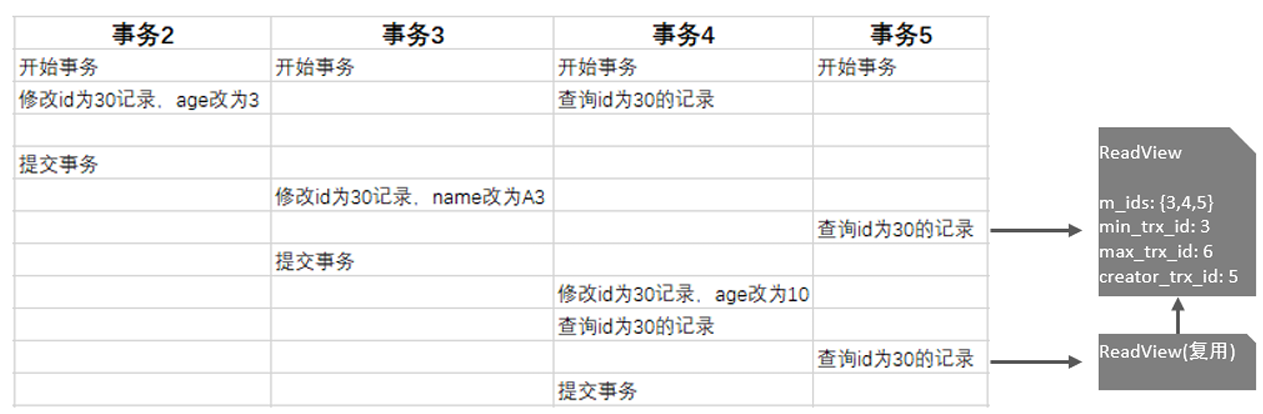
那么既然 ReadView 都一样,ReadView 的版本链匹配规则也一样,那么最终快照读返回的结果也是一样的
所以 MVCC 的实现原理就是通过 InnoDB 表的隐藏字段、UndoLog 版本链、ReadView 来实现的。而 MVCC + 锁,则实现了事务的隔离性。 而一致性则是由 redolog 与 undolog 保证
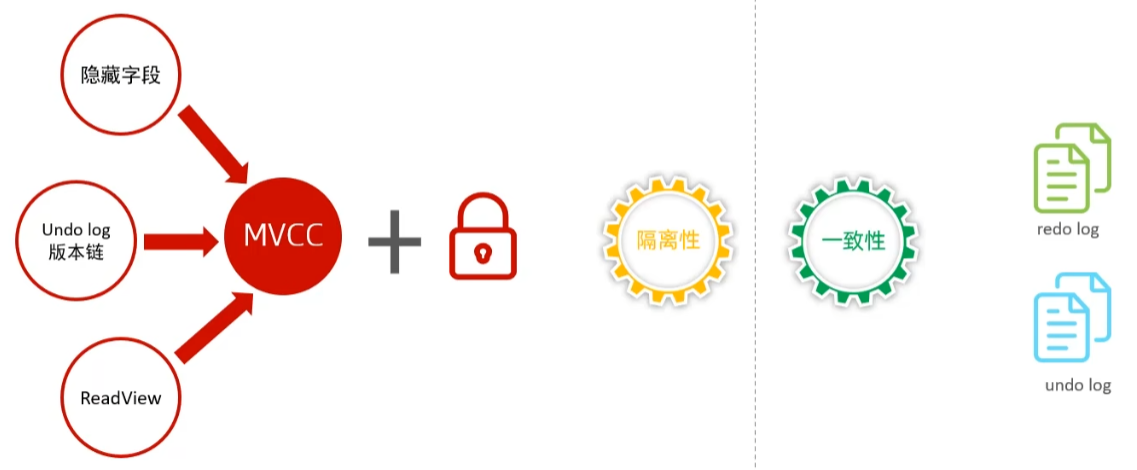
十五、MySQL 进阶之 —— MySQL 管理
1、系统数据库介绍
Mysql 数据库安装完成后,自带了一下四个数据库,具体作用如下:
| 数据库 | 含义 |
|---|---|
| mysql | 存储 MySQL 服务器正常运行所需要的各种信息(时区、主从、用户、权限等) |
| information_schema | 提供了访问数据库元数据的各种表和视图,包含数据库、表、字段类型及访问权限等 |
| performance_schema | 为 MySQL 服务器运行时状态提供了一个底层监控功能,主要用于收集数据库服务器性能参数 |
| sys | 包含了一系列方便 DBA 和开发人员利用 performance_schema 性能数据库进行性能调优和诊断的视图 |
2、常用工具
(1)mysql
该 mysql 不是指 mysql 服务,而是指 mysql 的客户端工具
语法:
mysql [options] [database]选项:
- -u, —user=name # 指定用户名
- -p, —password[=name] # 指定密码
- -h, —host=name # 指定服务器 IP 或域名
- -P, —port=port # 指定连接端口
- -e, —execute=name # 执行 SQL 语句并退出
-e 选项可以在 Mysql 客户端执行 SQL 语句,而不用连接到 MySQL 数据库再执行,对于一些批处理脚本,这种方式尤其方便
示例:
mysql -uroot -p123456 db01 -e "select * from stu";(2)mysqladmin
mysqladmin 是一个执行管理操作的客户端程序。可以用它来检查服务器的配置和当前状态、创建并删除数据库等
通过帮助文档查看选项:
mysqladmin --help语法:
mysqladmin [options] command ...选项:
- -u, —user=name # 指定用户名
- -p, —password[=name] # 指定密码
- -h, —host=name # 指定服务器IP或域名
- -P, —port=port # 指定连接端口
示例:
mysqladmin -uroot -p1234 drop 'test01';
mysqladmin -uroot -p1234 version;
(3)mysqlbinlog
由于服务器生成的二进制日志文件以二进制格式保存,所以如果想要检查这些文本的文本格式,就会使用到 mysqlbinlog 日志管理工具
语法:
mysqlbinlog [options] log-files1 log-files2 ...选项:
- -d, —database=name # 指定数据库名称,只列出指定的数据库相关操作
- -o, —offset= # 忽略掉日志中的前n行命令
- -r,—result-file=name # 将输出的文本格式日志输出到指定文件
- -s, —short-form # 显示简单格式,省略掉一些信息
- —start-datetime=date1 —stop-datetime=date2 # 指定日期间隔内的所有日志
- —start-position=pos1 —stop-position=pos2 # 指定位置间隔内的所有日志
(4)mysqlshow
mysqlshow 客户端对象查找工具,用来很快地查找存在哪些数据库、数据库中的表、表中的列或者索引
语法:
mysqlshow [options] [db_name [table_name [col_name]]]选项:
- —count # 显示数据库及表的统计信息(数据库,表 均可以不指定)
- -i # 显示指定数据库或者指定表的状态信息
示例:
#查询 test 库中每个表中的字段书,及行数
mysqlshow -uroot -p2143 test --count

#查询 test 库中 book 表的详细情况
mysqlshow -uroot -p2143 test book --count
示例:
A.查询每个数据库的表的数量及表中记录的数量
mysqlshow -uroot -p1234 --countB.查看数据库 db01 的统计信息
mysqlshow -uroot -p1234 db01 --countC.查看数据库 db01 中的 course 表的信息
mysqlshow -uroot -p1234 db01 course --countD.查看数据库 db01 中的 course 表的 id 字段的信息
mysqlshow -uroot -p1234 db01 course id --count(5)mysqldump
mysqldump 客户端工具用来备份数据库或在不同数据库之间进行数据迁移。备份内容包含创建表,及插入表的 SQL 语句
语法:
mysqldump [options] db_name [tables]
mysqldump [options] --database/-B db1 [db2 db3...]
mysqldump [options] --all-databases/-A
连接选项:
- -u, —user=name # 指定用户名
- -p, —password[=name] # 指定密码
- -h, —host=name # 指定服务器ip或域名
- -P, —port=# # 指定连接端口
输出选项:
- —add-drop-database 在每个数据库创建语句前加上 drop database 语句
- —add-drop-table 在每个表创建语句前加上 drop table 语句,默认开启;不开启(—skip-add-drop-table)
- -n, —no-create-db 不包含数据库的创建语句
- -t, —no-create-info 不包含数据表的创建语句
- -d —no-data 不包含数据
- -T, —tab=name 自动生成两个文件:一个 .sql 文件,创建表结构的语句;一个 .txt 文件,数据文件
示例:
A.备份 db01 数据库
mysqldump -uroot -p1234 db01 > db01.sql可以直接打开 db01.sql,来查看备份出来的数据到底什么样
备份出来的数据包含:
- 删除表的语句
- 创建表的语句
- 数据插入语句
如果我们在数据备份时,不需要创建表,或者不需要备份数据,只需要备份表结构,都可以通过对应的参数来实现
B.备份 db01 数据库中的表数据,不备份表结构(-t)
mysqldump -uroot -p1234 -t db01 > db01.sql打开 db02.sql,来查看备份的数据,只有 insert 语句,没有备份表结构
C.将 db01 数据库的表的表结构与数据分开备份(-T)
mysqldump -uroot -p1234 -T /root db01 score执行上述指令,会出错,数据不能完成备份,原因是因为我们所指定的数据存放目录 /root,MySQL 认为是不安全的,需要存储在 MySQL 信任的目录下。那么,哪个目录才是 MySQL 信任的目录呢,可以查看一下系统变量 secure_file_priv
上述的两个文件 score.sql 中记录的就是表结构文件,而 score.txt 就是表数据文件,但是需要注意表数据文件,并不是记录一条条的 insert 语句,而是按照一定的格式记录表结构中的数据
(6)mysqlimport / source
1)mysqlimport
mysqlimport 是客户端数据导入工具,用来导入 mysqldump 加 -T 参数后导出的文本文件
语法:
mysqlimport [options] db_name textfile1 [textfile2...]示例:
mysqlimport -uroot -p2143 test /tmp/city.txt2)source
如果需要导入 sql 文件,可以使用 mysql 中的 source 指令
语法:
source /root/xxxxx.sql十六、MySQL 运维之 —— 日志
十七、MySQL 运维之 —— 主从复制
十八、MySQL 运维之 —— 分库分表
十九、MySQL 运维之 —— 读写分离
数据准备
1、SQL 部分
create table emp(
    id int comment '编号',
    workno varchar(10) comment '工号',
    name varchar(10) comment '姓名',
    gender char(1) comment '性别',
    age tinyint unsigned comment '年龄',
    idcard char(18) comment '身份证号',
    workaddress varchar(50) comment '工作地址',
    entrydate date comment '入职时间'
) comment '员工表';

INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (1, '00001', '柳岩666', '女', 20, '123456789012345678', '北京', '2000-01-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (2, '00002', '张无忌', '男', 18, '123456789012345670', '北京', '2005-09-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (3, '00003', '韦一笑', '男', 38, '123456789712345670', '上海', '2005-08-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (4, '00004', '赵敏', '女', 18, '123456757123845670', '北京', '2009-12-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (5, '00005', '小昭', '女', 16, '123456769012345678', '上海', '2007-07-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (6, '00006', '杨逍', '男', 28, '12345678931234567X', '北京', '2006-01-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (7, '00007', '范瑶', '男', 40, '123456789212345670', '北京', '2005-05-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (8, '00008', '黛绮丝', '女', 38, '123456157123645670', '天津', '2015-05-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (9, '00009', '范凉凉', '女', 45, '123156789012345678', '北京', '2010-04-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (10, '00010', '陈友谅', '男', 53, '123456789012345670', '上海', '2011-01-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (11, '00011', '张士诚', '男', 55, '123567897123465670', '江苏', '2015-05-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (12, '00012', '常遇春', '男', 32, '123446757152345670', '北京', '2004-02-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (13, '00013', '张三丰', '男', 88, '123656789012345678', '江苏', '2020-11-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (14, '00014', '灭绝', '女', 65, '123456719012345670', '西安', '2019-05-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (15, '00015', '胡青牛', '男', 70, '12345674971234567X', '西安', '2018-04-01');
INSERT INTO emp (id, workno, name, gender, age, idcard, workaddress, entrydate)
VALUES (16, '00016', '周芷若', '女', 18, null, '北京', '2012-06-01');
2、外键约束部分
create table dept(
    id int auto_increment comment 'ID' primary key,
    name varchar(50) not null comment '部门名称'
)comment '部门表';

INSERT INTO dept (id, name) VALUES (1, '研发部'), (2, '市场部'),(3, '财务部'), (4, '销售部'), (5, '总经办');

create table emp(
    id int auto_increment comment 'ID' primary key,
    name varchar(50) not null comment '姓名',
    age int comment '年龄',
    job varchar(20) comment '职位',
    salary int comment '薪资',
    entrydate date comment '入职时间',
    managerid int comment '直属领导 ID',
    dept_id int comment '部门 ID'
)comment '员工表';

INSERT INTO emp (id, name, age, job,salary, entrydate, managerid, dept_id)
VALUES
    (1, '金庸', 66, '总裁',20000, '2000-01-01', null,5),
    (2, '张无忌', 20, '项目经理',12500, '2005-12-05', 1,1),
    (3, '杨逍', 33, '开发', 8400,'2000-11-03', 2,1),
    (4, '韦一笑', 48, '开发',11000, '2002-02-05', 2,1),
    (5, '常遇春', 43, '开发',10500, '2004-09-07', 3,1),
    (6, '小昭', 19, '程序员鼓励师',6600, '2004-10-12', 2,1);
3、多表查询部分
create table dept(
    id int auto_increment comment 'ID' primary key,
    name varchar(50) not null comment '部门名称'
)comment '部门表';

INSERT INTO dept (id, name) VALUES (1, '研发部'), (2, '市场部'), (3, '财务部'), (4, '销售部'), (5, '总经办'), (6, '人事部');

create table emp(
    id int auto_increment comment 'ID' primary key,
    name varchar(50) not null comment '姓名',
    age int comment '年龄',
    job varchar(20) comment '职位',
    salary int comment '薪资',
    entrydate date comment '入职时间',
    managerid int comment '直属领导ID',
    dept_id int comment '部门ID'
)comment '员工表';

alter table emp add constraint fk_emp_dept_id foreign key (dept_id) references dept(id);

INSERT INTO emp (id, name, age, job,salary, entrydate, managerid, dept_id) VALUES
    (1, '金庸', 66, '总裁',20000, '2000-01-01', null,5),
    (2, '张无忌', 20, '项目经理',12500, '2005-12-05', 1,1),
    (3, '杨逍', 33, '开发', 8400,'2000-11-03', 2,1),
    (4, '韦一笑', 48, '开发',11000,'2002-02-05', 2,1),
    (5, '常遇春', 43, '开发',10500, '2004-09-07', 3,1),
    (6, '小昭', 19, '程序员鼓励师',6600,'2004-10-12', 2,1),
    (7, '灭绝', 60, '财务总监',8500, '2002-09-12', 1,3),
    (8, '周芷若', 19, '会计',4800,'2006-06-02',7,3),
    (9, '丁敏君', 23, '出纳',5250,'2009-05-13',7,3),
    (10, '赵敏', 20, '市场部总监',12500,'2004-10-12',1,2),
    (11, '鹿杖客', 56, '职员',3750,'2006-10-03',10,2),
    (12, '鹤笔翁', 19, '职员',3750,'2007-05-09',10,2),
    (13, '方东白', 19, '职员',5500,'2009-02-12',10,2),
    (14, '张三丰', 88, '销售总监',14000,'2004-10-12',1,4),
    (15, '俞莲舟', 38, '销售',4600,'2004-10-12',14,4),
    (16, '宋远桥', 40, '销售',4600,'2004-10-12',14,4),
    (17, '陈友谅', 42, null,2000,'2011-10-12',1,null);
4、索引语法部分
create table tb_user(
    id int primary key auto_increment comment '主键',
    name varchar(50) not null comment '用户名',
    phone varchar(11) not null comment '手机号',
    email varchar(100) comment '邮箱',
    profession varchar(11) comment '专业',
    age tinyint unsigned comment '年龄',
    gender char(1) comment '性别,1:男,2:女',
    status char(1) comment '状态',
    createtime datetime comment '创建时间'
) comment '系统用户表';

INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('吕布','17799990000','lvbu666@163.com','软件工程',23,'1','6','2001-02-02 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('曹操','17799990001','caocao666@qq.com','通讯工程',33,'1','0','2001-03-05 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('赵云','17799990002','1779999002@139.com','英语',34,'1','2','2002-03-02 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('孙悟空','17799990003','1779999003@sina.com','工程造价',54,'1','0','2001-07-02 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('花木兰','17799990004','199807298@sina.com','软件工程',23,'2','1','2001-04-22 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('大乔','17799990005','daqiao666@sina.com','舞蹈',22,'2','0','2001-02-07 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('露娜','17799990006','luna_love@sina.com','应用数学',24,'2','0','2001-02-08 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('程咬金','17799990007','chengyaojin@163.com','化工',38,'1','5','2001-05-23 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('项羽','17799990008','xiaoyu666@qq.com','金属材料',43,'1','0','2001-09-18 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('白起','17799990009','baiqi666@sina.com','机械工程及其自动化',27,'1','2','2001-08-16 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('韩信','17799990010','hanxin520@163.com','无机非金属材料工程',27,'1','0','2001-06-12 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('荆轲','17799990011','jingke123@163.com','会计',29,'1','0','2001-05-11 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('兰陵王','17799990012','lanlinwang666@126.com','工程造价',44,'1','1','2001-04-09 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('狂铁','17799990013','kuangtie@sina.com','应用数学',43,'1','2','2001-04-10 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('貂蝉','17799990014','849589483748@qq.com','软件工程',40,'2','3','2001-02-12 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('妲己','17799990015','2783238293@qq.com','软件工程',31,'2','0','2001-01-30 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('芈月','17799990016','xiaomin2001@sina.com','工业经济',35,'2','0','2000-05-03 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('嬴政','17799990017','88394343428@qq.com','化工',38,'1','1','2001-08-08 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('狄仁杰','17799990018','jujiam181668@163.com','国际贸易',30,'1','0','2007-03-12 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('安琪拉','17799990019','jdodmlh@126.com','城市规划',51,'2','0','2001-08-15 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('典韦','17799990020','ycaunanjian@163.com','城市规划',52,'1','2','2000-04-12 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('廉颇','17799990021','lianpo321@126.com','土木工程',19,'1','3','2002-07-18 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('后羿','17799990022','altycj2000@139.com','城市园林',20,'1','0','2002-03-10 00:00:00');
INSERT INTO tb_user (name, phone, email, profession, age, gender, status, createtime) VALUES ('姜子牙','17799990023','374838448@qq.com','工程造价',29,'1','4','2003-05-26 00:00:00');